
 Assistant scénario▸
 Apps AI
 Actualités AI
Llama 4 : premiers modèles IA multimodaux à architecture Mixture-of-Experts
小编 ·

Llama 4 : premiers modèles IA multimodaux à architecture Mixture-of-Experts
Qu'est-ce que Llama 4 ?
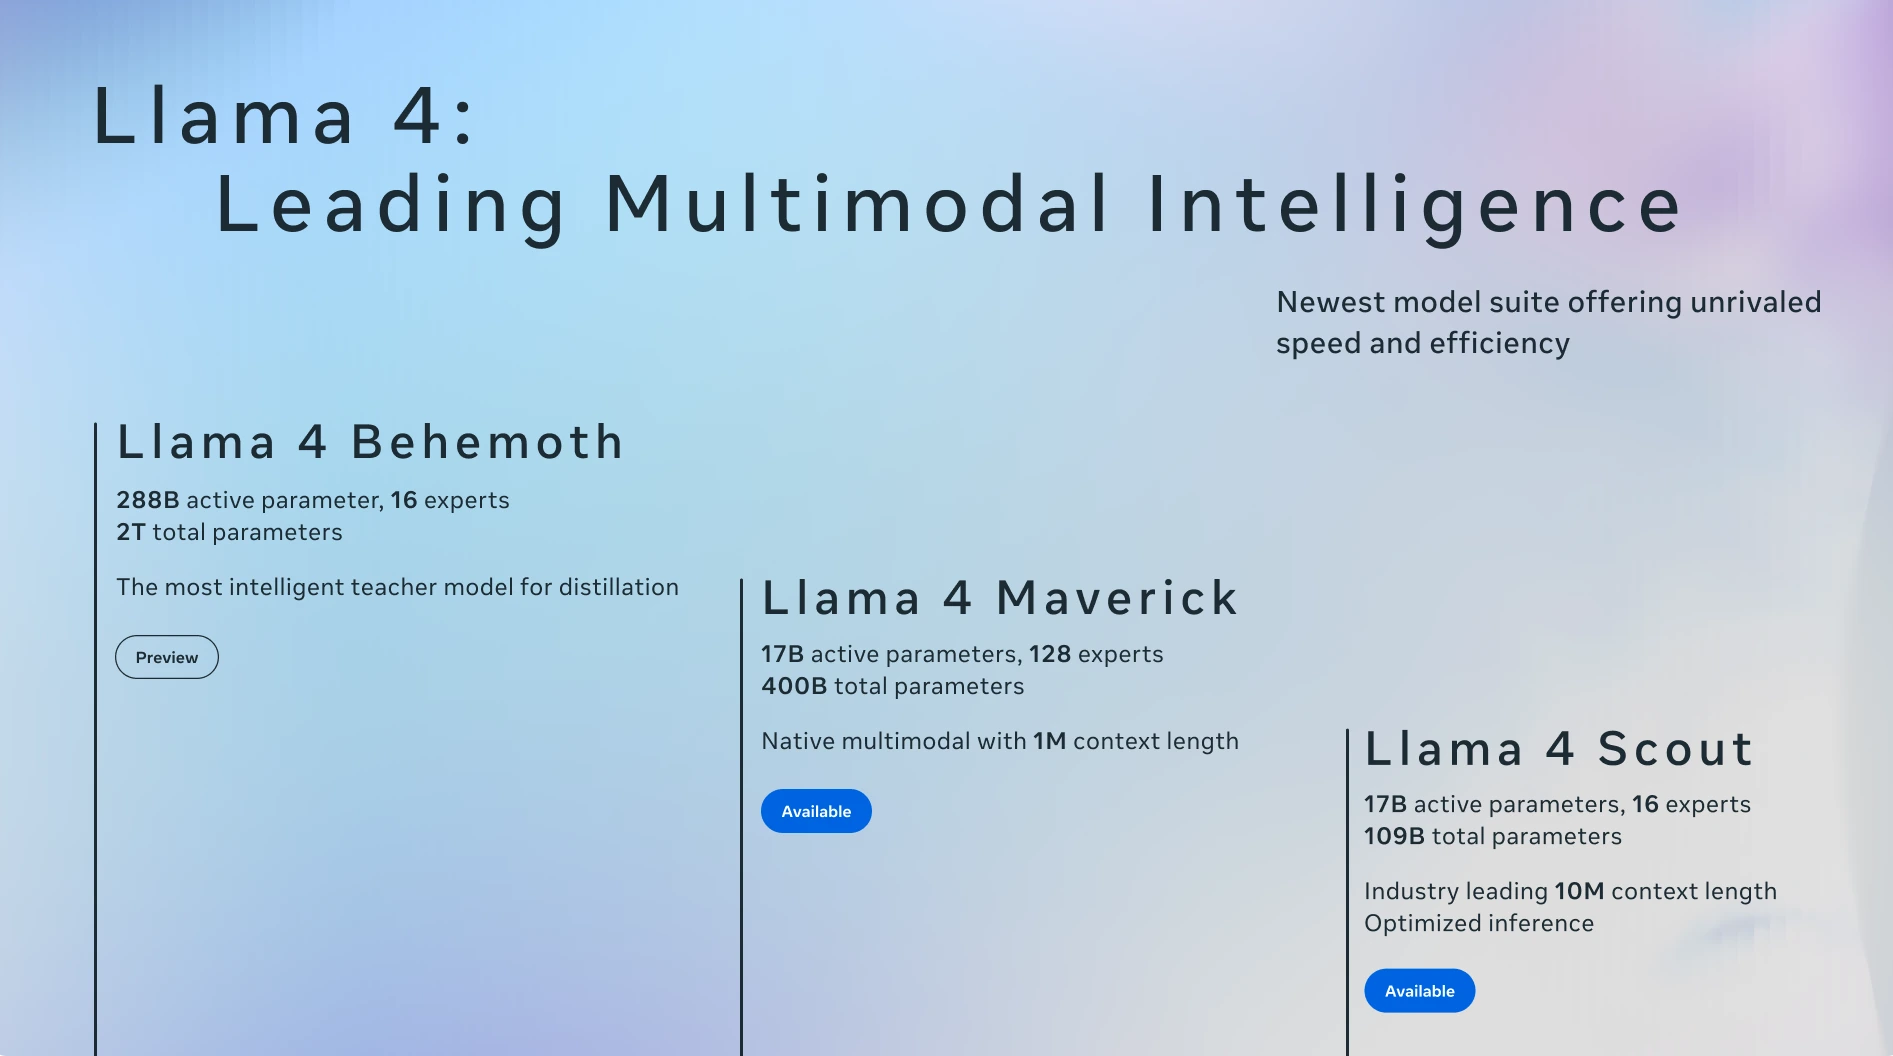
Llama 4 est la toute dernière génération de modèles IA open source publiée par Meta le 5 avril 2025. Elle comprend Llama 4 Scout et Llama 4 Maverick, qui sont les premiers modèles d'IA multimodaux à adopter une architecture à mixture d'experts (MoE). Scout dispose de 17 milliards de paramètres actifs, de 16 modèles « experts » et d'un nombre total de paramètres de 109 milliards, tandis que Maverick possède également 17 milliards de paramètres actifs, mais est équipé de 128 modèles « experts », avec un nombre total de paramètres atteignant 400 milliards. De plus, une version encore plus puissante, Llama 4 Behemoth, est en cours de développement, avec 288 milliards de paramètres actifs, 16 modèles « experts » et un nombre total de paramètres proche de 2 000 milliards. Ces modèles ont été entraînés sur de grandes quantités de données textuelles, d'images et de vidéos non annotées, et possèdent des capacités de compréhension visuelle.
Série de modèles Llama 4
Llama 4 Scout
Taille des paramètres : 17 milliards de paramètres actifs, 16 experts
Exigences matérielles : peut fonctionner sur un seul GPU NVIDIA H100
Fenêtre de contexte : prend en charge une fenêtre de contexte ultra-longue pouvant atteindre 10 millions de tokens
Avantages en termes de performances : surpasse Gemma 3, Gemini 2.0 Flash-Lite et Mistral 3.1
Llama 4 Maverick
Taille des paramètres : 17 milliards de paramètres actifs, 128 experts, pour un total de 400 milliards de paramètres
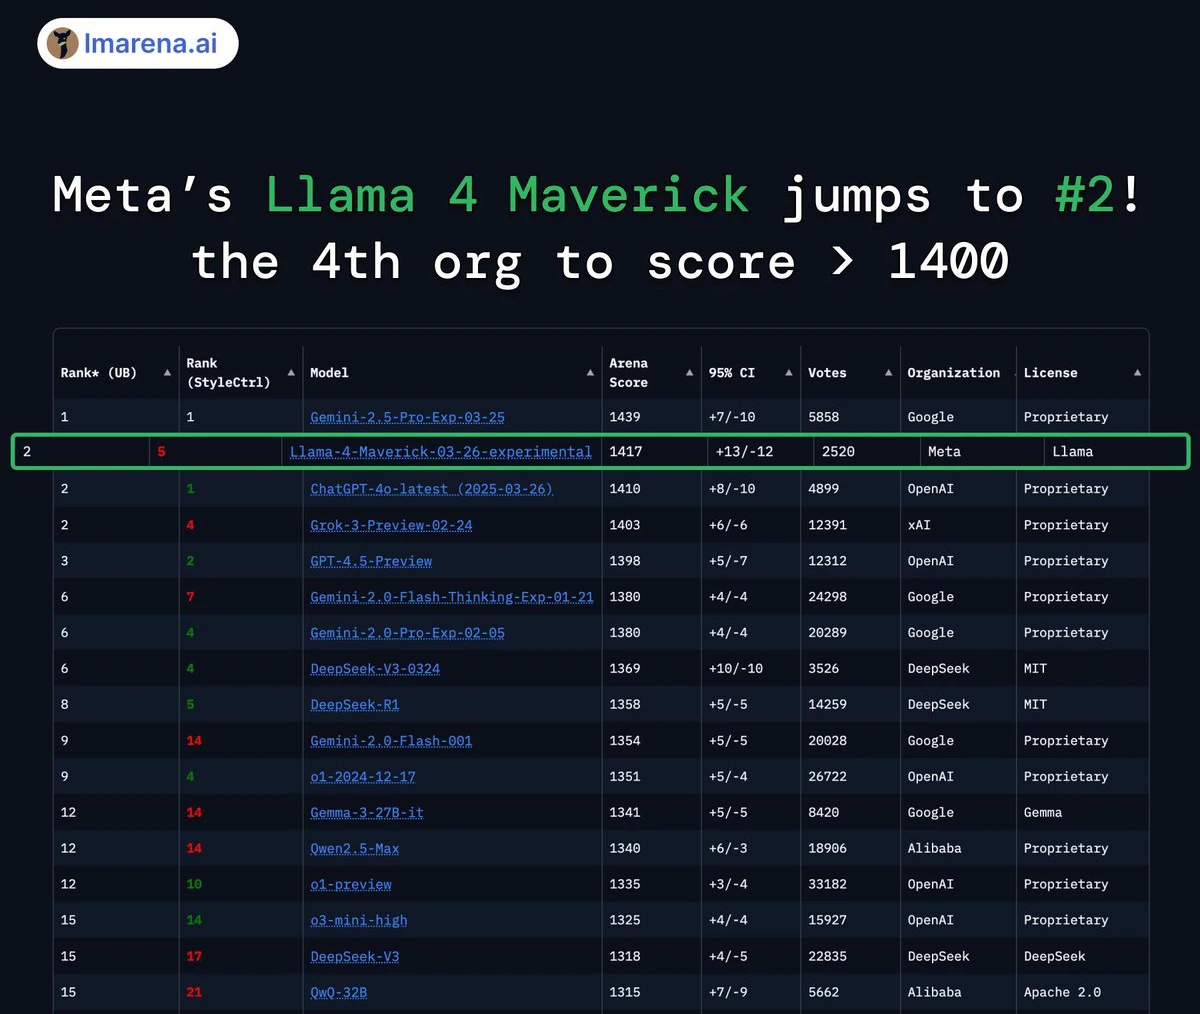
Avantages en termes de performances : excellentes performances dans les tâches multimodales, surpassant GPT-4o et Gemini 2.0 Flash
Capacités de raisonnement : capacités de raisonnement et de programmation comparables à celles de DeepSeek v3, mais avec moins de la moitié des paramètres actifs
Llama 4 Behemoth (aperçu)
Taille des paramètres : 288 milliards de paramètres actifs, 16 experts, pour un nombre total de paramètres proche de 2 000 milliards
Avantages en termes de performances : surpasse GPT-4.5, Claude Sonnet 3.7 et Gemini 2.0 Pro dans plusieurs benchmarks STEM
Rôle : sert de modèle enseignant pour la distillation des autres modèles Llama 4 ; est encore en cours d'entraînement
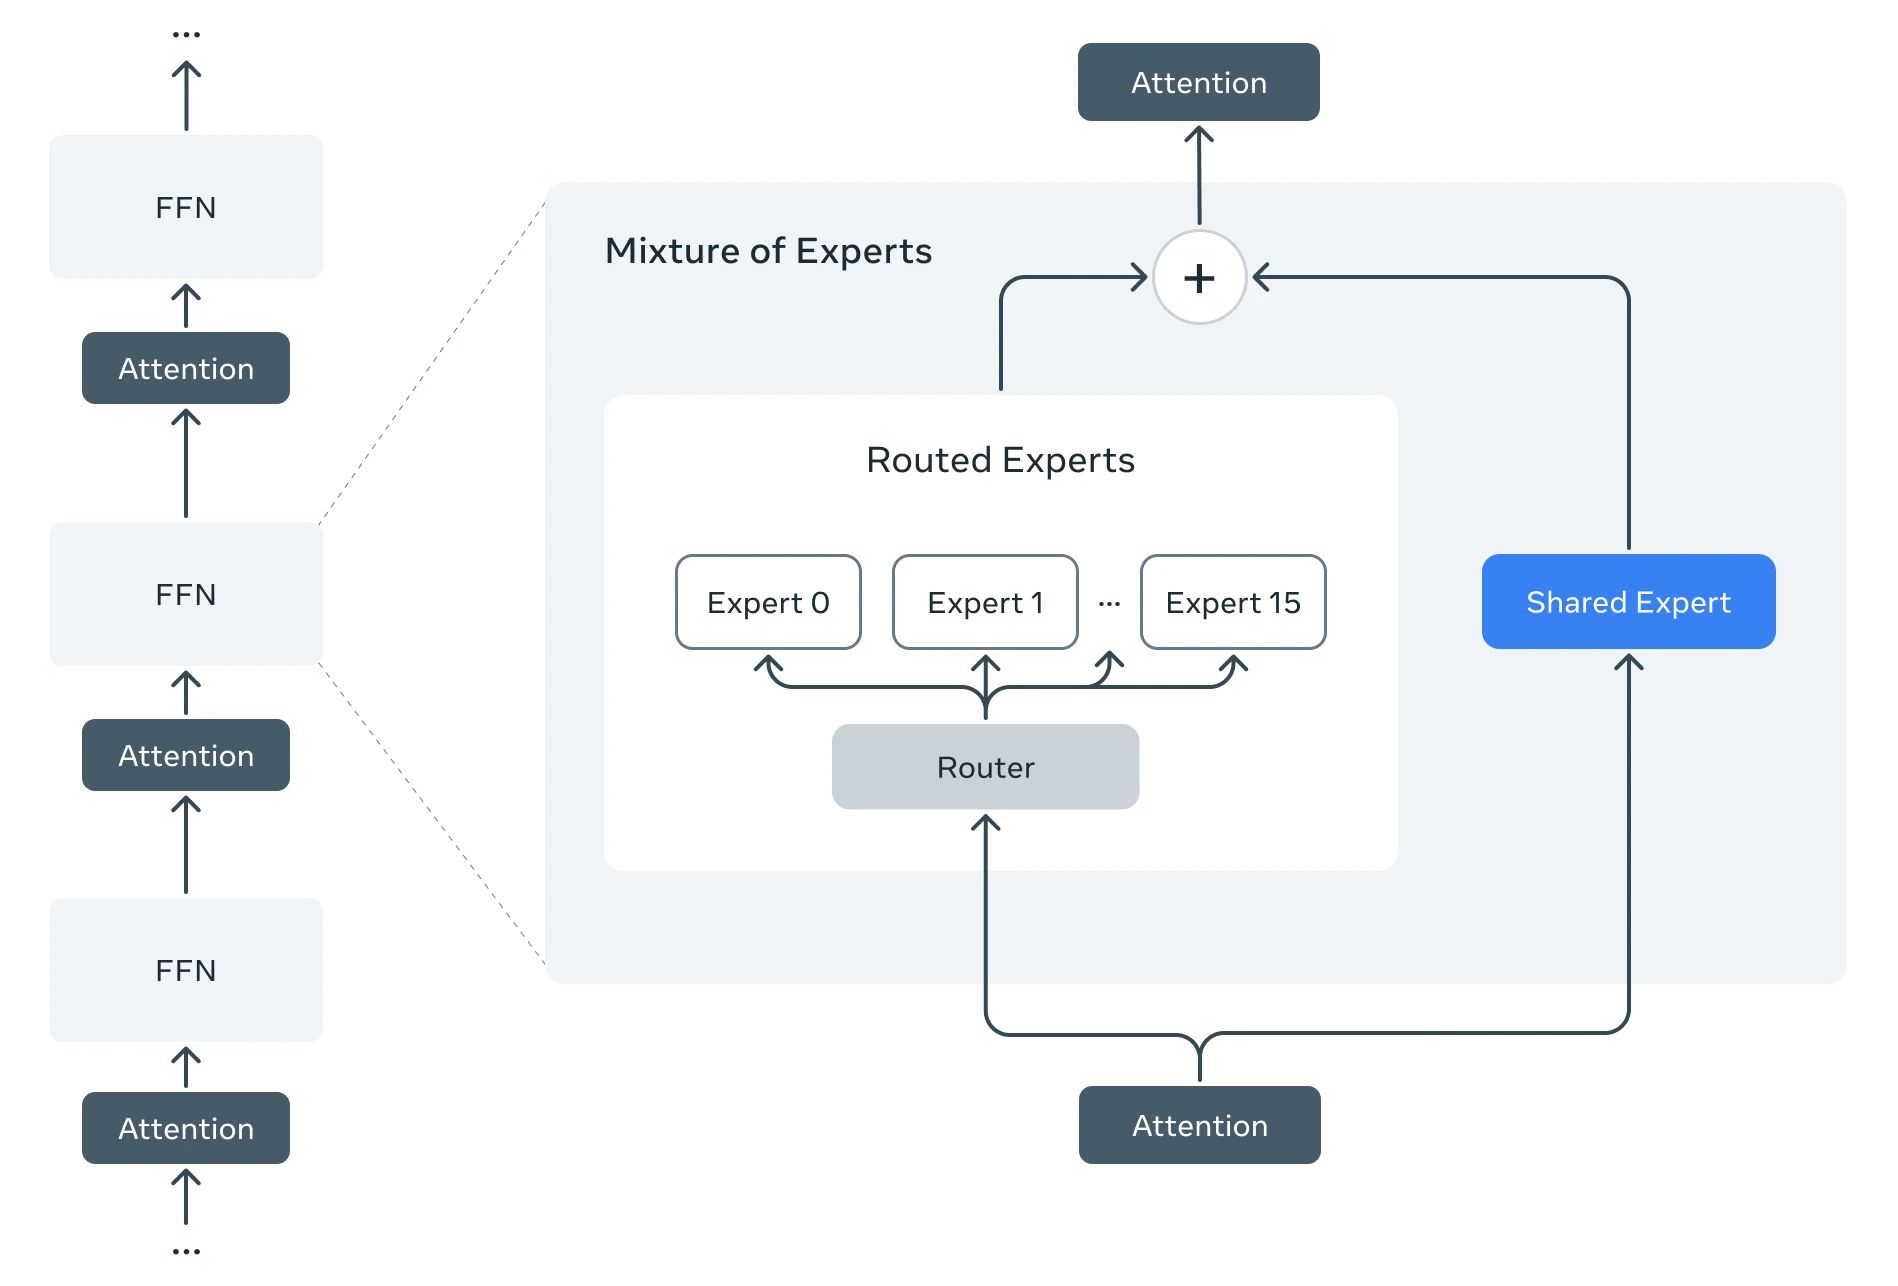
Caractéristiques de Llama 4
Capacités multimodales : Llama 4 est un grand modèle multimodal capable de traiter et d'intégrer différents types de données tels que le texte, la vidéo, les images et l'audio, et de convertir du contenu entre ces formats. Par exemple, Llama 4 Scout peut analyser le contenu d'images dans des environnements complexes.
Architecture à mixture d'experts : c'est l'une des caractéristiques principales de Llama 4. Cette architecture divise le modèle en plusieurs sous-modèles « experts » spécialisés dans des tâches spécifiques, améliorant ainsi l'efficacité de l'entraînement et du traitement des requêtes des utilisateurs. Par exemple, le modèle Llama 4 Maverick compte au total 400 milliards de paramètres, mais seuls 17 milliards sont réellement actifs pendant les calculs.
Capacité de traitement de longs contextes : la fenêtre de contexte de Llama 4 Scout peut atteindre 10 millions de tokens, ce qui lui permet d'exceller dans le traitement de documents très longs.
Fonctionnalités vocales : Llama 4 intègre un traitement vocal natif, capable de traiter directement les informations vocales sans avoir besoin de convertir d'abord la parole en texte pour l'entrée du modèle, puis de retransformer le texte en voix. Cela améliore considérablement l'efficacité et la fluidité des interactions vocales.
Applications
Service client : les entreprises peuvent utiliser ce modèle d'IA multimodal pour analyser rapidement les questions posées par les utilisateurs et fournir des réponses plus précises et plus efficaces.
Domaine de l'éducation : les assistants pédagogiques intelligents peuvent expliquer des concepts complexes en comprenant les questions des étudiants et en les accompagnant d'images, améliorant ainsi considérablement l'apprentissage.
Réunions virtuelles : lors de réunions virtuelles, Llama 4 peut servir d'assistant pour aider les utilisateurs à effectuer des traductions en temps réel, prendre en note les points essentiels de la réunion, et même simuler les interventions des participants, améliorant ainsi l'efficacité de la communication.
Contrôle des appareils intelligents : grâce aux commandes vocales, les utilisateurs peuvent facilement rédiger des textes, envoyer des messages et contrôler des appareils domotiques.
Domaines à forte densité d'information : la capacité de Llama 4 à traiter de longs contextes le rend particulièrement utile dans les domaines à forte densité d'information tels que la médecine, la science, l'ingénierie, les mathématiques et la littérature.
Caractéristiques techniques de Llama 4
Taille et nombre de paramètres du modèle : Llama 4 Scout dispose de 17 milliards de paramètres actifs, de 16 modèles « experts » et d'un nombre total de paramètres de 109 milliards ; Llama 4 Maverick possède également 17 milliards de paramètres actifs, mais est équipé de 128 modèles « experts », pour un nombre total de paramètres atteignant 400 milliards ; Llama 4 Behemoth, quant à lui, dispose de 288 milliards de paramètres actifs et de 2 000 milliards de paramètres au total.
Données d'entraînement et diversité : tous les modèles ont été entraînés sur de grandes quantités de données textuelles, d'images et de vidéos non annotées afin d'acquérir de larges capacités de compréhension visuelle.
Optimisation architecturale : une architecture à mixture d'experts est adoptée, ce qui permet d'atteindre une efficacité opérationnelle supérieure en décomposant les tâches de traitement des données en sous-tâches et en les assignant à des modèles « experts » plus petits.
Efficacité de l'inférence : l'efficacité de l'inférence est améliorée en réduisant les coûts d'exécution et la latence du modèle. Par exemple, Llama 4 Maverick peut fonctionner sur une seule machine NVIDIA H100 DGX.
Meta estime que le coût d'inférence de Llama 4 Maverick se situe entre 0,19 et 0,49 dollars pour 1 million de tokens (avec un ratio entrée/sortie de 3:1), ce qui le rend beaucoup moins cher que des modèles propriétaires tels que GPT-4o.
Lecture détaillée :https://ai.meta.com/blog/llama-4-multimodal-intelligence/
Téléchargement du modèle :https://www.llama.com/llama-downloads/?utm_source=llama-home-hero&utm_medium=llama-referral&utm_campaign=llama-utm&utm_offering=llama-downloads&utm_product=llama









