
 Assistant scénario▸
 Apps AI
 Actualités AI
Speech-02 : un puissant modèle de synthèse vocale (TTS) de MiniMax Audio
小编 ·

Speech-02 : un puissant modèle de synthèse vocale (TTS) de MiniMax Audio
Qu'est-ce que Speech-02 ?
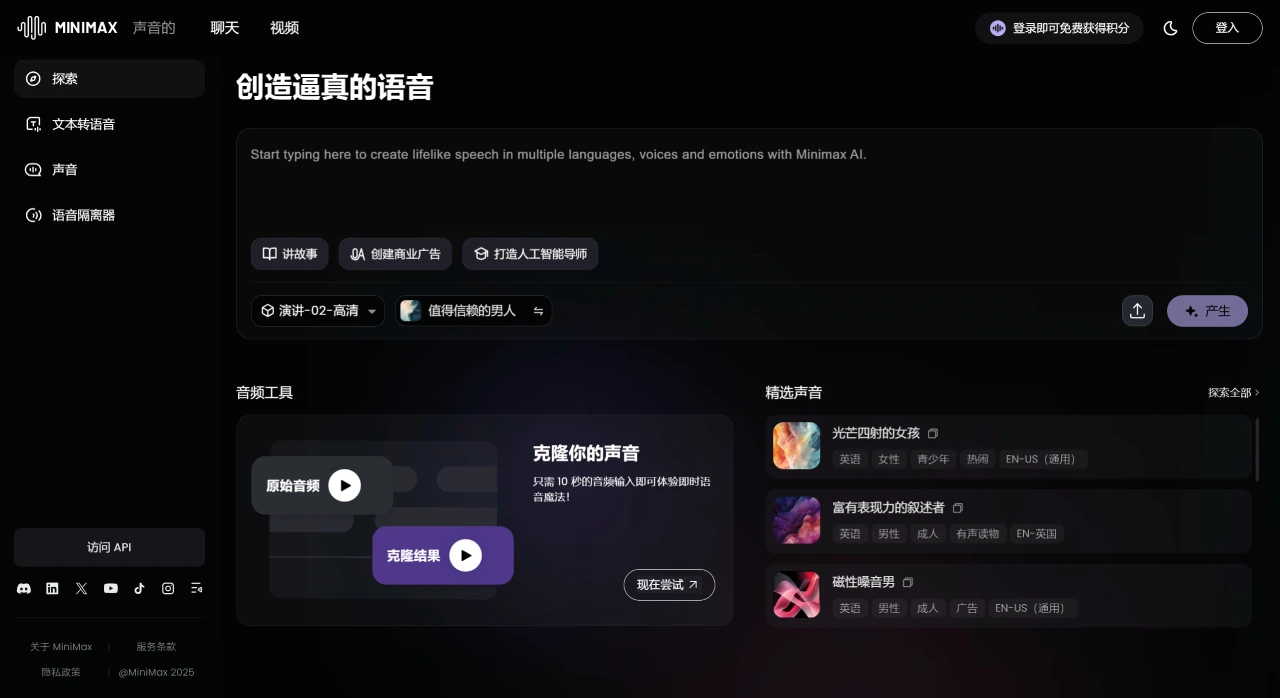
MiniMax Audio Speech-02 est un puissant modèle de text-to-speech (TTS) capable de transformer instantanément n'importe quel fichier ou URL en un audio réaliste. Il prend en charge des entrées uniques pouvant aller jusqu'à 200 000 caractères, couvre plus de 30 langues et propose des accents authentiques. De plus, Speech-02 prend en charge le clonage vocal illimité, le streaming en moins d'une seconde et plusieurs formats audio (tels que FLAC, WAV, MP3 et PCM).
Le modèle Speech-02 est disponible en deux versions : speech-02-hd-preview (caractérisé par 99 % de similarité vocale et une clarté de qualité studio, idéal pour le doublage, les livres audio et autres scénarios nécessitant des performances réalistes) et speech-02-turbo-preview (offrant un équilibre entre faible latence et hautes performances, adapté aux applications en temps réel).
Capacités linguistiques et vocales
Support multilingue : Speech-02 prend en charge la synthèse vocale dans plus de 30 langues, notamment l'anglais, le chinois, le japonais, le coréen, le français, l'allemand, l'espagnol, le portugais, l'italien, l'arabe, le russe, le turc, le néerlandais, l'ukrainien, le vietnamien, le hindi, le thaï, le polonais, le roumain, le grec, le finnois et l'indonésien, avec des accents authentiques.
Bibliothèque vocale riche : plus de 300 voix réalistes, prenant en charge une expression authentique dans plusieurs langues.
Performances techniques
Nombre de caractères par entrée : prend en charge jusqu'à 200 000 caractères par entrée unique.
Vitesse de streaming : prend en charge le streaming en moins d'une seconde.
Versions du modèle : inclut speech-02-hd-preview et speech-02-turbo-preview. Le premier se distingue par 99 % de similarité vocale et une clarté de qualité studio, idéal pour le doublage, les livres audio et autres scénarios nécessitant des performances réalistes ; le second offre un équilibre entre faible latence et hautes performances, adapté aux applications en temps réel.
Fonctionnalités de Speech-02
Clonage vocal illimité : permet de cloner rapidement des voix dans divers styles et intonations avec une qualité de pointe dans le secteur.
Contrôle vocal : les utilisateurs peuvent facilement contrôler l'émotion, le volume, la vitesse et le format de sortie de la voix.
Mixage vocal : permet de combiner des voix existantes pour créer de nouvelles voix uniques.
Prise en charge des formats audio : prend en charge plusieurs formats audio tels que FLAC, WAV, MP3 et PCM.
Cas d'utilisation de Speech-02
Production de livres audio : idéal pour transformer des romans, des articles académiques, etc. en contenu audio de haute qualité.
Création de podcasts : aide les créateurs de podcasts à produire du contenu plus attrayant et diversifié.
Doublage de films et de jeux : offre une qualité audio de niveau cinématographique et des effets sonores immersifs.
Conférences internationales et traduction : permet une commutation instantanée et fluide entre plusieurs langues.
Actuellement, le modèle Speech-02 est disponible sur la plateforme MiniMax Audio et la plateforme API, mais n'a pas encore été lancé en Chine.
Liens officiels
Plateforme MiniMax Audio :https://www.minimax.io/audio
Plateforme MiniMax Audio API :https://www.minimax.io/platform









