
 Assistant scénario▸
 Apps AI
 Actualités AI
MegaTTS 3 : un système de synthèse vocale zero-shot par ByteDance
小编 ·

MegaTTS 3 : un système de synthèse vocale zero-shot par ByteDance
Qu'est-ce que MegaTTS 3 ?
MegaTTS 3 est un système de synthèse texte-parole zéro-shot lancé par ByteDance. Il utilise un modèle de diffusion léger, décompose la parole en attributs tels que le contenu, le timbre et la prosodie pour la modélisation, et prend en charge le clonage vocal de très haute qualité, la synthèse bilingue, le contrôle de l'intensité de l'accent, etc., et peut être appliqué à des scénarios tels que la synthèse vocale et l'édition vocale.
Architecture principale et technologie
Modèle de diffusion léger et efficace : Le cœur de MegaTTS 3 est le TTS Diffusion Transformer, dont le nombre de paramètres n'est que de 0,45B, ce qui permet de générer une voix de haute qualité tout en garantissant l'efficacité.
Décomposition et modélisation de la parole : La parole est décomposée en différents attributs tels que le contenu, le timbre et la prosodie, et des modules appropriés sont conçus pour modéliser chaque attribut. Par exemple, un vecteur global est utilisé pour modéliser le timbre, car le timbre est un attribut global qui varie lentement dans le temps ; un modèle acoustique basé sur VQGAN est utilisé pour générer des spectrogrammes, ainsi qu'un modèle de langage basé sur des codes latents pour ajuster la distribution de la prosodie, car la prosodie varie rapidement dans une phrase et le modèle de langage est capable de capturer les dépendances locales et à longue distance.
Vocodeur : Un vocodeur basé sur GAN est utilisé pour construire correctement la phase, sans qu'un modèle de langage ait besoin de modéliser la phase.
Fonctionnalités de MegaTTS 3
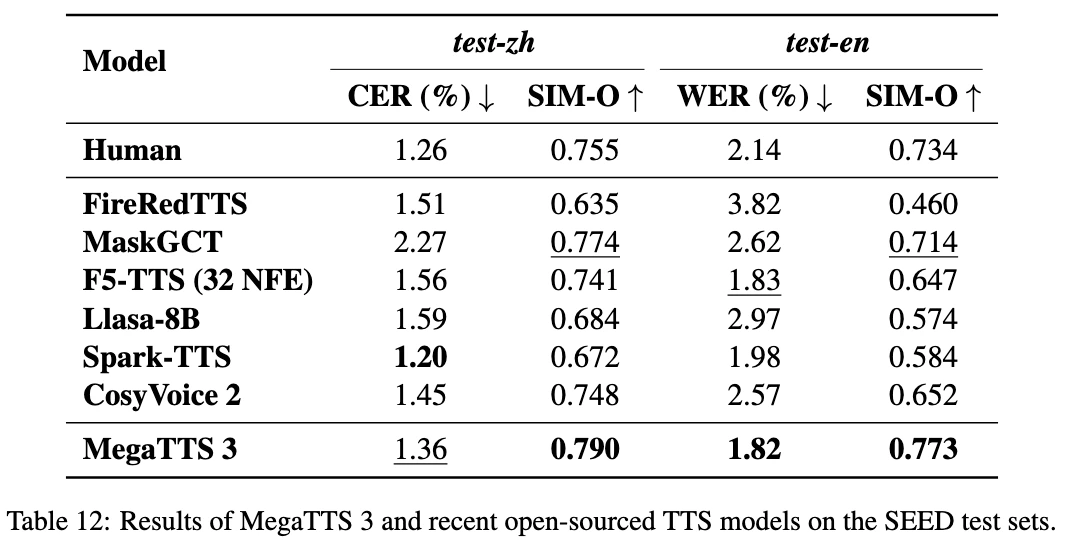
Clonage vocal de très haute qualité : capable de générer une voix très similaire à celle du locuteur cible.
Prise en charge bilingue : prend en charge le chinois et l'anglais, ainsi que la synthèse vocale mixte chinois-anglais.
Contrôlabilité : prend en charge le contrôle de l'intensité de l'accent et prendra en charge à l'avenir des ajustements plus fins de la prononciation/durée.
Synthèse vocale zéro-shot : capable de générer la voix d'un locuteur cible sans données vocales spécifiques à ce locuteur.
Scénarios d'application de MegaTTS 3
Synthèse vocale : peut être utilisée dans divers scénarios nécessitant la conversion de texte en parole, tels que les livres audio, les annonces vocales, etc.
Édition vocale : permet d'éditer et de modifier la parole pour répondre à différents besoins.
Synthèse vocale multilingue : prend en charge les tâches de synthèse vocale multilingue.
Tutoriel d'utilisation de MegaTTS 3
Outil en ligne de commande : Une interface en ligne de commande est fournie, permettant à l'utilisateur de générer de la parole synthétisée en spécifiant le fichier d'invite vocale d'entrée et le contenu textuel. Par exemple :
Commande de synthèse vocale standard :
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/Chinese_prompt.wav' --input_text "另一边的桌上,一位读书人嗤之以鼻道,'佛子三藏,神子燕小鱼是什么样的人物,李家的那个李子夜如何与他们相提并论?'" --output_dir ./gen
Commande de synthèse vocale avec contrôle de l'accent :
CUDA_VISIBLE_DEVICES=0 python tts/infer_cli.py --input_wav 'assets/English_prompt.wav' --input_text '这是一条有口音的音频。' --output_dir ./gen --p_w 1.0 --t_w 3.0
Web UI : Prend également en charge la synthèse vocale via une interface Web UI.
Installation de MegaTTS 3
Configuration requise : Un environnement Python 3.9 est nécessaire.
Téléchargement du modèle : Les checkpoints du modèle pré-entraîné peuvent être téléchargés depuis Google Drive ou Hugging Face et placés dans le répertoire spécifié.
Étapes d'installation :
# 创建 Python 3.9 的 conda 环境
conda create -n megatts3-env python=3.9
conda activate megatts3-env
# 安装依赖
pip install -r requirements.txt
Projet GitHub :https://github.com/bytedance/MegaTTS3









