
 Assistant scénario▸
 Apps AI
 Actualités AI
QVQ-Max : le modèle de raisonnement visuel d'Alibaba qui comprend les images et les vidéos
小编 ·

QVQ-Max : le modèle de raisonnement visuel d'Alibaba qui comprend les images et les vidéos
Qu'est-ce que QVQ-Max ?
QVQ-Max est un modèle de raisonnement visuel capable de comprendre le contenu des vidéos et des images, d'analyser et de raisonner à partir des informations pertinentes, et de fournir des solutions. Le modèle QVQ-Max obtient d'excellents résultats dans de nombreux domaines, tels que la résolution de problèmes mathématiques, la gestion de problèmes de la vie quotidienne, l'aide à la programmation et la création artistique.
Conception initiale
Les modèles d'IA traditionnels s'appuient principalement sur des entrées textuelles, mais dans la réalité, de nombreuses informations se présentent sous forme d'images, de graphiques ou de vidéos. QVQ-Max vise à créer un assistant à la fois doué pour capter les informations visuelles et capable d'analyses rapides, afin d'aider les utilisateurs à résoudre divers problèmes concrets.
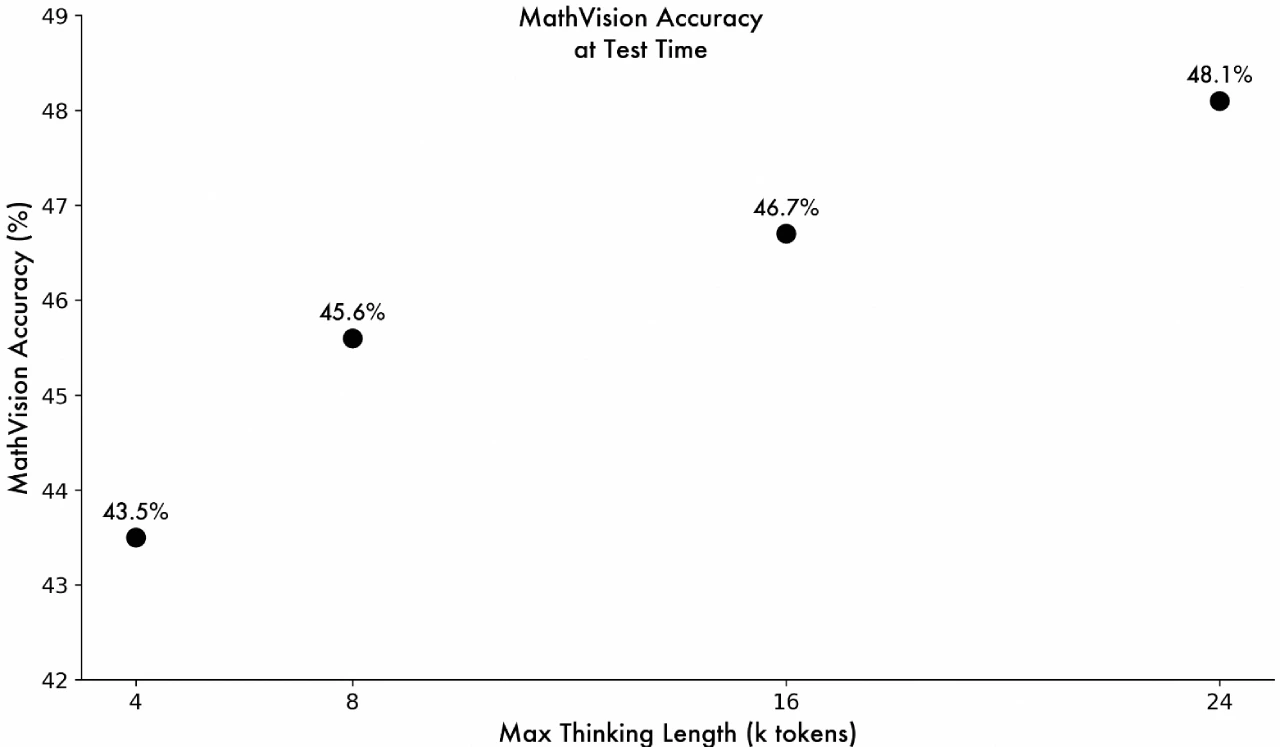
Capacités clés de QVQ-Max
Observation minutieuse : QVQ-Max peut identifier rapidement les éléments clés d'une image. Qu'il s'agisse d'un graphique complexe ou d'une photo du quotidien, il parvient à en saisir les détails.
Raisonnement approfondi : le modèle ne se contente pas d'identifier le contenu, il est également capable de raisonner en s'appuyant sur des connaissances contextuelles. Par exemple, il peut analyser les figures d'un problème de géométrie et en déduire la réponse.
Application flexible : au-delà de l'analyse et du raisonnement, QVQ-Max peut également être utilisé pour la création, comme la conception d'illustrations, la génération de scripts pour de courtes vidéos, ou encore la création de contenus de jeu de rôle selon les besoins de l'utilisateur.
Scénarios d'application de QVQ-Max
Usage professionnel : aide à l'analyse de données, à l'organisation d'informations et à la programmation.
Soutien à l'apprentissage : aide à résoudre des problèmes complexes en mathématiques, en physique et dans d'autres matières, en particulier ceux accompagnés de graphiques.
Assistance au quotidien : fournit des conseils vestimentaires à partir d'une photo de votre garde-robe, ou guide la préparation d'un plat à partir de l'image d'une recette.
Tutoriel d'utilisation de QVQ-Max
1. Rendez-vous sur https://chat.qwen.ai/
2. Sélectionnez le modèle QWQ-32B
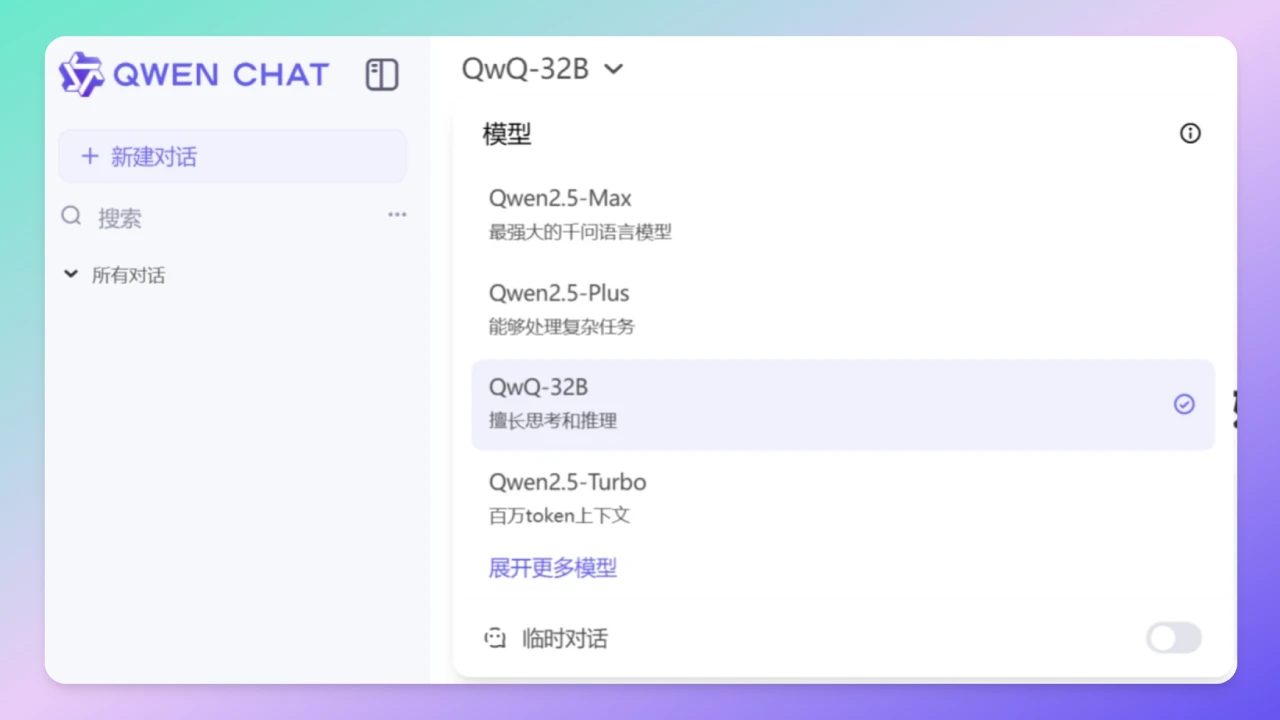
3. Cliquez sur le signe « + » dans la zone de saisie pour téléverser une image ou une vidéo.
4. Posez une question sur le contenu de l'image.
Axes de développement futur
Améliorer les capacités d'observation : grâce à des technologies de vérification du contenu visuel (comme le grounding), renforcer la précision de la reconnaissance.
Renforcer les capacités de traitement des tâches : développer un Agent visuel afin d'améliorer la gestion des tâches multi-étapes et complexes, telles que l'utilisation d'un téléphone, d'un ordinateur ou le jeu vidéo.
Optimiser l'expérience interactive : élargir les modalités d'interaction, notamment la vérification d'outils et la génération visuelle.
QVQ-Max, en tant que modèle de raisonnement visuel, dispose d'un potentiel énorme. Il est non seulement capable d'identifier le contenu d'une image, mais aussi d'analyser et de raisonner à partir des informations, voire d'accomplir certaines tâches créatives. Bien qu'il n'en soit qu'à sa première version, il a déjà démontré un grand potentiel et pourrait, à l'avenir, devenir un Agent visuel pratique offrant un soutien solide aux utilisateurs pour résoudre leurs problèmes concrets.
Présentation détaillée :https://qwenlm.github.io/zh/blog/qvq-max-preview/
Adresse d'utilisation :https://chat.qwen.ai/









