
 Assistant scénario▸
 Apps AI
 Actualités AI
Qwen2.5-Omni : le modèle multimodal phare de bout en bout d'Alibaba
小编 ·

Qwen2.5-Omni : le modèle multimodal phare de bout en bout d'Alibaba
Qu'est-ce que Qwen2.5-Omni ?
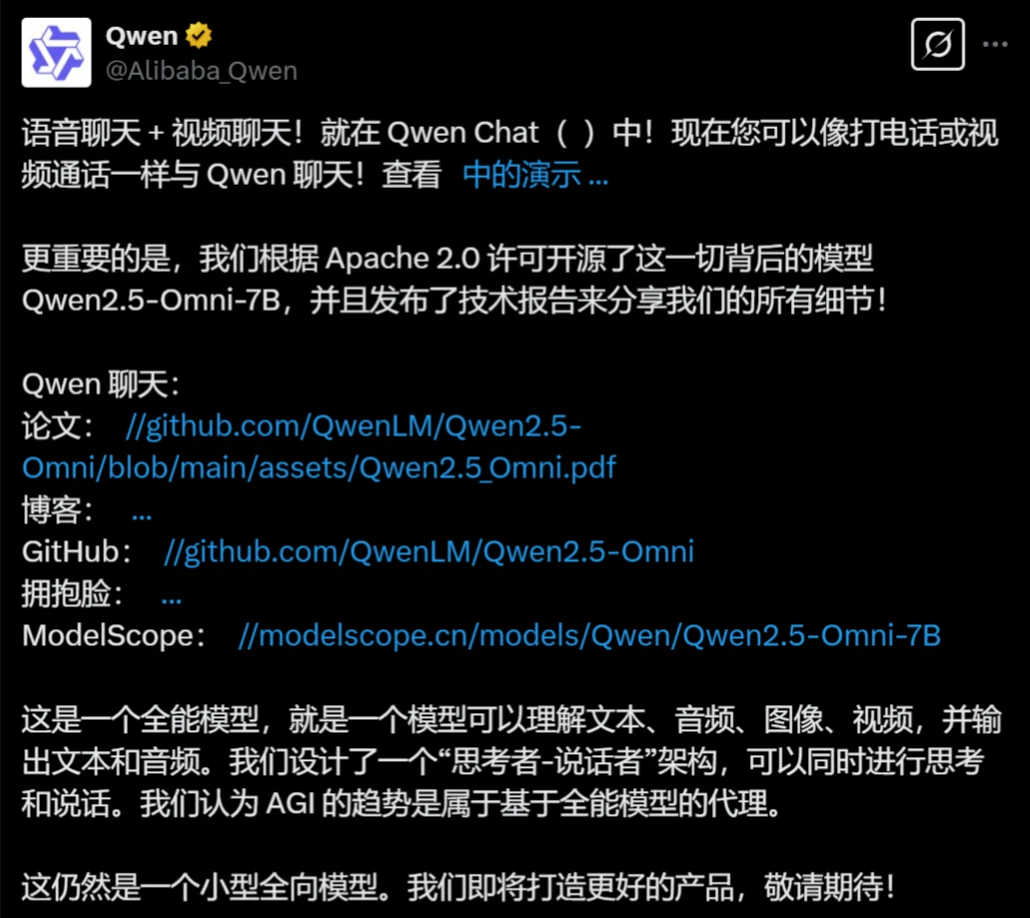
Qwen2.5-Omni est le nouveau modèle phare multimodal de bout en bout de la série Qwen publiée par Alibaba. Il est spécialement conçu pour une perception multimodale globale, c'est-à-dire capable de comprendre le texte, l'audio, les images et la vidéo, et peut réfléchir et parler simultanément, en générant à la fois du texte et une sortie de synthèse vocale naturelle via une réponse en streaming en temps réel, le tout au sein d'un même modèle d'ia.
Caractéristiques principales de Qwen2.5-Omni
Architecture innovante :
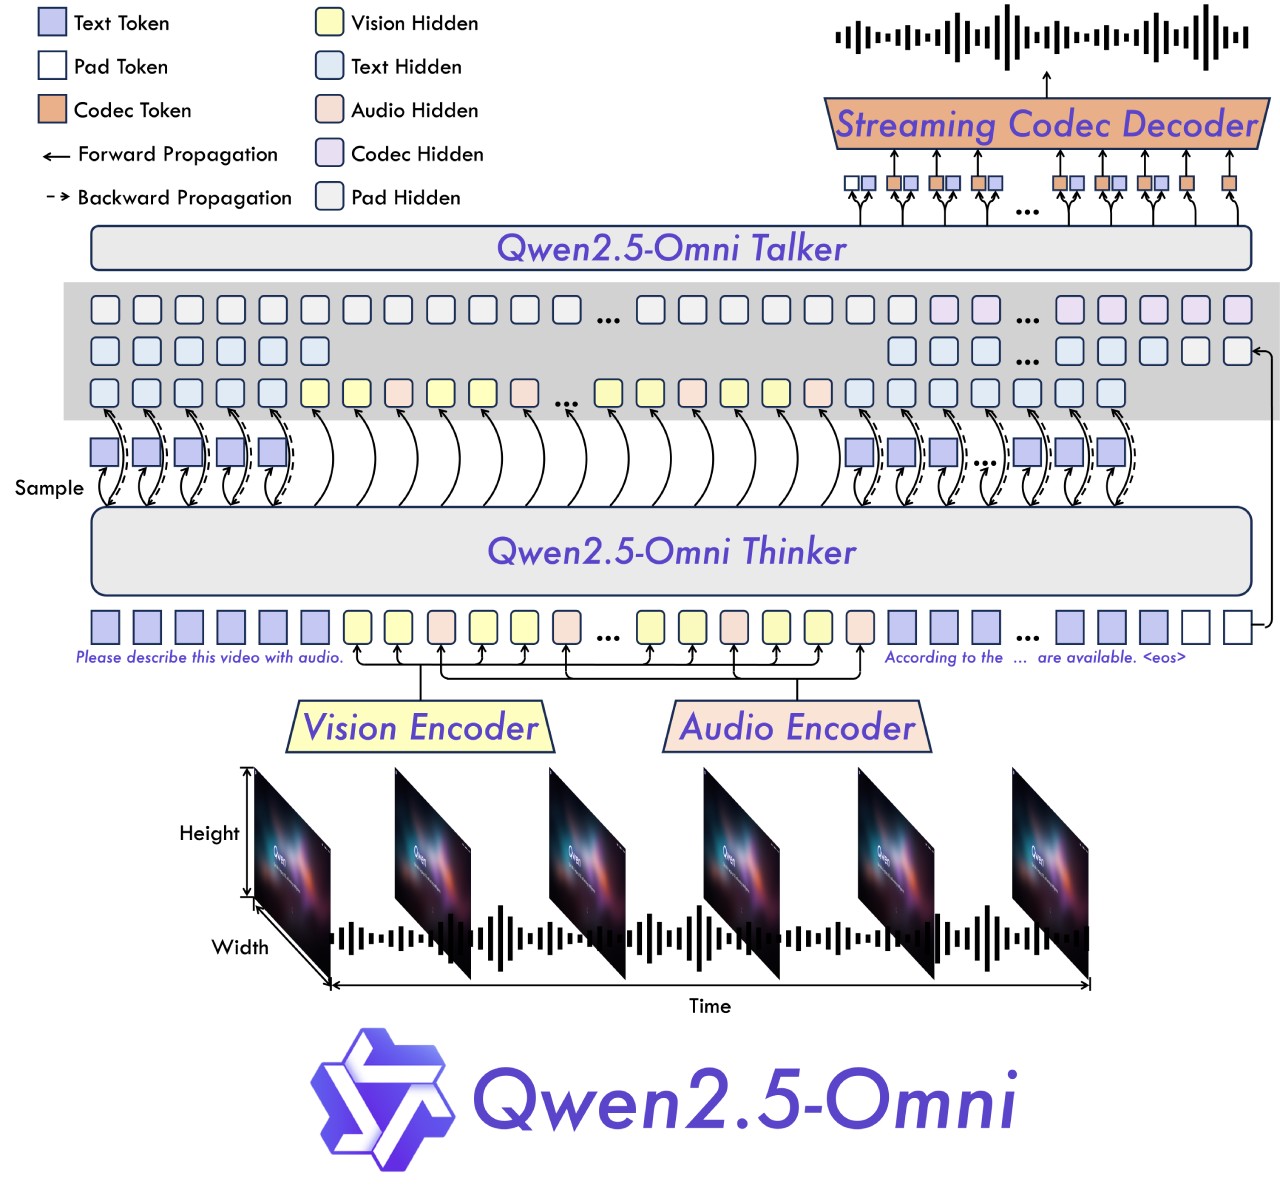
Architecture Thinker-Talker : Thinker est chargé de traiter et de comprendre les entrées provenant des modalités texte, audio et vidéo, en générant des représentations sémantiques de haut niveau et le contenu textuel correspondant ; Talker convertit ensuite ce contenu en une sortie vocale naturelle.
Technologie TMRoPE : une nouvelle technique d'encodage positionnel appelée TMRoPE (Time-aligned Multimodal RoPE) a été proposée pour synchroniser les entrées vidéo avec les horodatages audio.
Interaction en temps réel :
Prend en charge une interaction entièrement en temps réel, capable de traiter des entrées par blocs et de fournir une sortie immédiate.
Génération vocale naturelle et fluide :
Surpasse de nombreuses alternatives existantes, qu'elles soient en streaming ou non, en termes de naturel et de stabilité de la génération vocale.
Avantages de performance toutes modalités :
Performances exceptionnelles sur les tâches multimodales (telles qu'OmniBench), ainsi que sur les tâches unimodales (telles que la reconnaissance vocale, la traduction, la compréhension audio, le raisonnement sur images et la compréhension vidéo, entre autres).
Capacité de suivi des instructions vocales de bout en bout :
Affiche des performances comparables au traitement des entrées textuelles en matière de suivi des instructions vocales de bout en bout, avec d'excellents résultats sur des benchmarks tels que MMLU et GSM8K.
Conception de l'architecture de Qwen2.5-Omni
Thinker : semblable à un cerveau, il est responsable du traitement et de la compréhension des entrées provenant des modalités texte, audio et vidéo, en générant des représentations sémantiques de haut niveau et le contenu textuel correspondant.
Talker : semblable à la bouche humaine, il reçoit les représentations sémantiques de haut niveau et le contenu textuel générés par Thinker, et produit en streaming une parole naturelle.
Architecture globale : Thinker est un décodeur Transformer équipé d'encodeurs pour l'audio et l'image afin d'en extraire les informations. Talker est une architecture de décodeur Transformer autoregressive à deux voies. Pendant l'entraînement et l'inférence, Talker reçoit directement les représentations de haute dimension issues de Thinker et partage toutes les informations contextuelles historiques de Thinker. L'ensemble de l'architecture est entraîné et utilisé pour l'inférence de bout en bout en tant que modèle unifié.
Performances de Qwen2.5-Omni
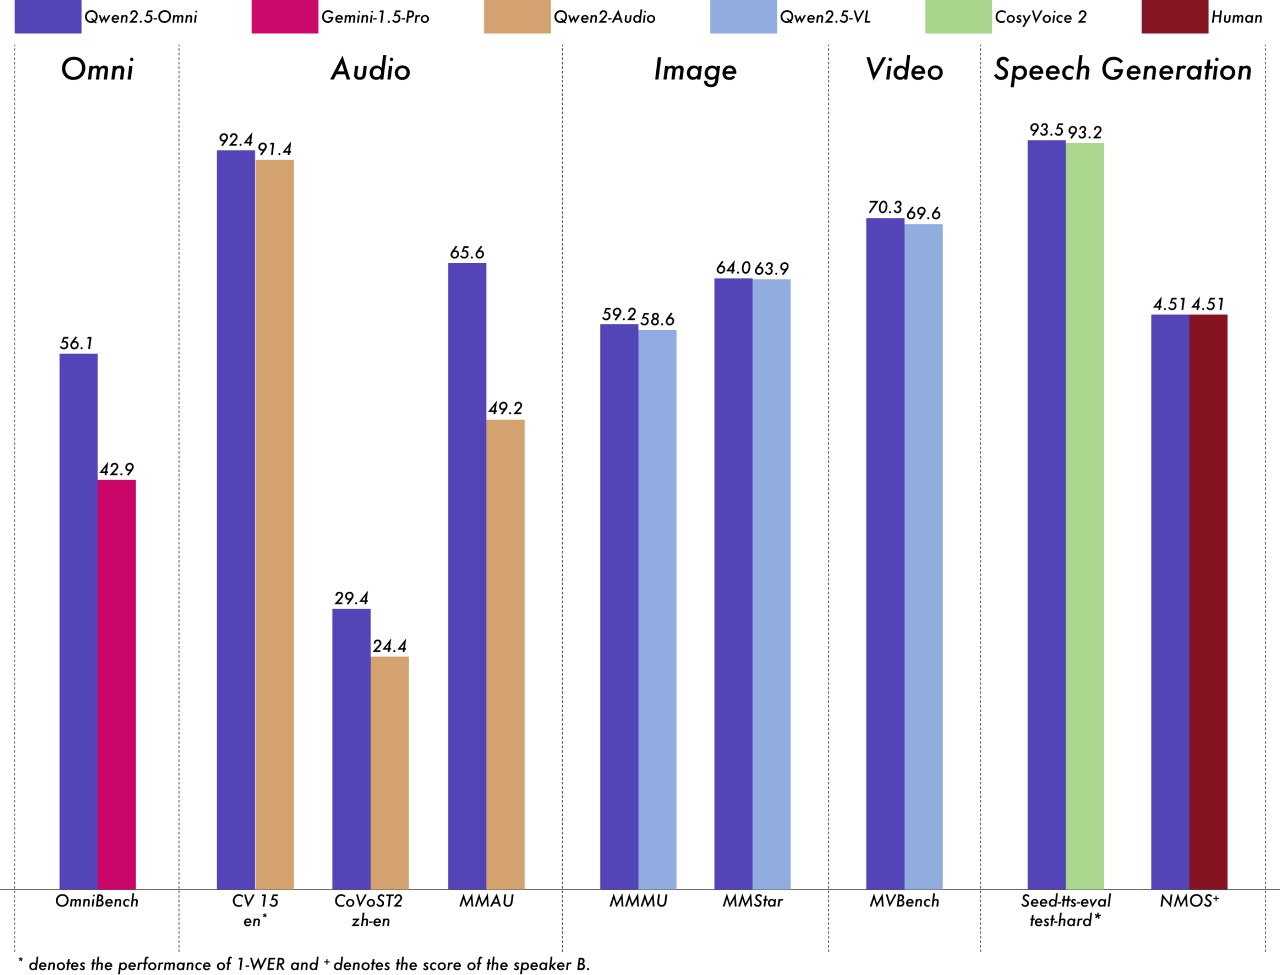
Sur les tâches multimodales (telles qu'OmniBench), Qwen2.5-Omni atteint des performances de pointe.
Sur les tâches unimodales, il excelle en reconnaissance vocale (Common Voice), en traduction (CoVoST2), en compréhension audio (MMAU), en raisonnement sur images (MMMU, MMStar), en compréhension vidéo (MVBench) et en génération vocale (Seed-tts-eval et naturel subjectif), entre autres.
Liens connexes
Qwen Chat : https://chat.qwenlm.ai
Hugging Face : https://huggingface.co/Qwen/Qwen2.5-Omni-7B
ModelScope : https://modelscope.cn/models/Qwen/Qwen2.5-Omni-7B
DashScope : https://help.aliyun.com/zh/model-studio/user-guide/qwen-omni
GitHub : https://github.com/QwenLM/Qwen2.5-Omni
Démo : https://modelscope.cn/studios/Qwen/Qwen2.5-Omni-Demo









