
 Assistant scénario▸
 Apps AI
 Actualités AI
KDTalker : génère des expressions faciales réalistes et des vidéos de mouvement à partir de l'audio
小编 ·

KDTalker : génère des expressions faciales réalistes et des vidéos de mouvement à partir de l'audio
Qu'est-ce que KDTalker ?
KDTalker est un outil de génération de portraits dynamiques pilotés par l'audio, capable de générer des expressions faciales et des mouvements réalistes à partir de signaux audio en entrée. KDTalker se caractérise par une technologie de points clés implicites, un modèle de diffusion spatio-temporelle et une diversité des poses. Il convient à de nombreux scénarios tels que la réalité virtuelle, les réseaux sociaux et les vidéoconférences. Grâce à une préparation simple de l'environnement et à des opérations en ligne de commande, les utilisateurs peuvent rapidement générer des vidéos de portraits dynamiques de haute qualité.
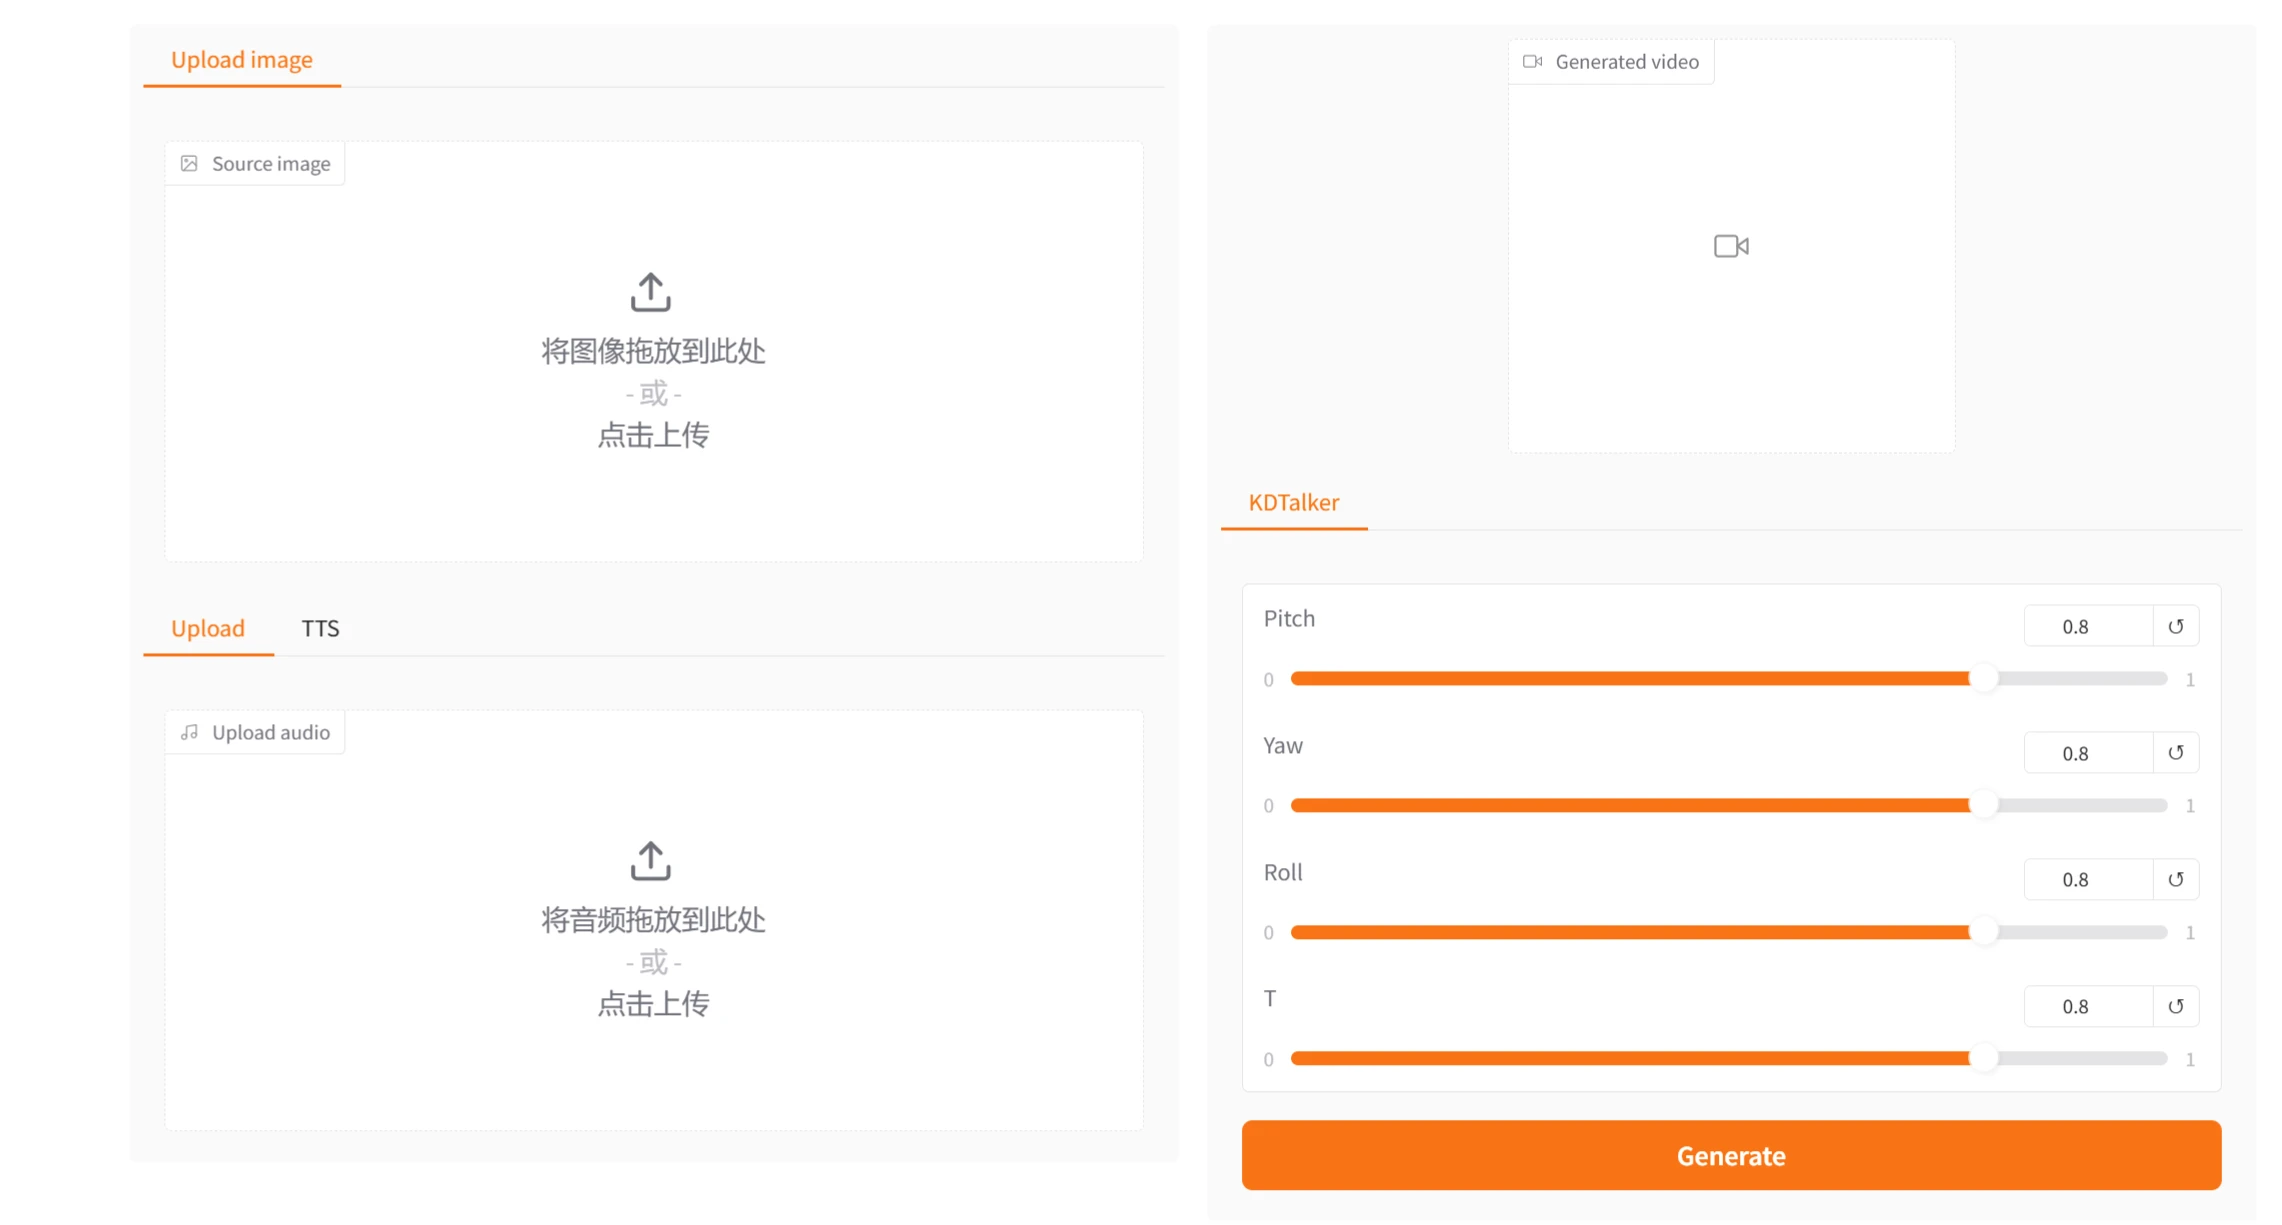
Fonctionnalités de KDTalker
Technologie de points clés implicites :
Utilise des points clés implicites pour capturer les variations subtiles des expressions faciales et des mouvements, reflétant ainsi plus naturellement la relation entre l'audio et les mouvements du visage.
Comparée aux méthodes traditionnelles de points clés explicites, l'approche implicite évite la complexité et les erreurs liées à l'annotation explicite.
Modèle de diffusion spatio-temporelle :
Combiné à un modèle de diffusion spatio-temporelle, il génère des effets dynamiques plus fluides et cohérents, tout en préservant la qualité et la stabilité de l'image.
Grâce au modèle de diffusion spatio-temporelle, la continuité temporelle dans les séquences vidéo est mieux gérée.
Diversité des poses :
Prend en charge la génération de multiples poses et permet d'ajuster dynamiquement l'attitude du personnage en fonction du contenu audio, augmentant ainsi la diversité et le naturel des résultats générés.
Les utilisateurs peuvent spécifier différents styles de pose pour générer des portraits dynamiques plus personnalisés.
Efficacité :
La conception optimisée du modèle et le flux de calcul efficace permettent à cette technologie de fonctionner sur une seule carte graphique RTX4090 ou RTX3090, offrant une grande praticité et évolutivité.
Convient à une utilisation sur des appareils aux ressources limitées, tout en maintenant une vitesse de génération élevée.
Génération de haute qualité :
Les portraits dynamiques générés présentent une haute résolution et un grand réalisme, répondant aux exigences de la génération vidéo de qualité.
Grâce à des modèles pré-entraînés et à un flux d'inférence optimisé, la stabilité et la cohérence des résultats générés sont garanties.
Scénarios d'application de KDTalker
Réalité virtuelle (VR) et réalité augmentée (AR) :
Dans les applications VR et AR, KDTalker peut générer des portraits dynamiques de personnages virtuels réalistes, améliorant ainsi l'expérience utilisateur.
Par exemple, lors de réunions virtuelles, les utilisateurs peuvent générer leur propre portrait dynamique piloté par l'audio, rendant la communication à distance plus naturelle.
Réseaux sociaux et création de contenu vidéo :
Les utilisateurs peuvent entrer leurs propres photos et audio dans KDTalker pour générer des vidéos de portraits dynamiques personnalisées, destinées à être partagées sur les réseaux sociaux.
Les créateurs de contenu peuvent exploiter cette technologie pour produire des contenus vidéo attrayants et accroître l'intérêt de leurs vidéos.
Visioconférence :
Lors de visioconférences, un réseau instable peut entraîner des saccades ou un flou de la vidéo. KDTalker peut générer des portraits dynamiques fluides pilotés par l'audio, maintenant une bonne qualité visuelle même dans des environnements à faible bande passante.
Divertissement et jeux vidéo :
Dans les applications de jeux et de divertissement, KDTalker peut générer des expressions et des mouvements dynamiques pour les personnages virtuels, renforçant ainsi l'immersion dans le jeu.
Par exemple, dans les jeux de rôle, les joueurs peuvent générer des portraits dynamiques de leur personnage pilotés par l'audio.
Éducation et formation :
Dans les contextes d'éducation et de formation, KDTalker peut générer des portraits dynamiques d'enseignants ou de formateurs pour des cours en ligne ou des vidéos de formation.
Les portraits dynamiques générés par l'audio rendent le contenu pédagogique plus vivant et améliorent l'efficacité de l'apprentissage.
Comment utiliser KDTalker
1. Préparation de l'environnement
Configuration matérielle requise : il est recommandé d'utiliser une carte graphique RTX4090 ou RTX3090.
Dépendances logicielles :
Installez git, conda et FFmpeg.
Clonez le code et créez l'environnement Python :
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# Créer et activer l'environnement conda
conda create -n KDTalker python=3.9
conda activate KDTalker
# Installer PyTorch et les autres dépendances
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. Téléchargement des poids pré-entraînés
Téléchargez les fichiers de poids pré-entraînés depuis Google Drive ou Hugging Face, et placez-les dans les répertoires ./pretrained_weights et ./ckpts.
Assurez-vous que la structure des répertoires est la suivante :
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. Exécution de l'inférence
Utilisez la commande suivante pour exécuter le script d'inférence et générer la vidéo de portrait dynamique :
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image : spécifie le chemin de l'image source en entrée.
-driven_audio : spécifie le chemin de l'audio pilote en entrée.
-output : spécifie le chemin de sauvegarde de la vidéo générée.
Adresse du projet : https://github.com/chaolongy/KDTalker
DEMO : https://kdtalker.com/









