
 Assistant scénario▸
 Apps AI
 Actualités AI
Fonctionnalités, tarifs et cas d'usage des modèles vocaux OpenAI GPT-4o-transcribe, GPT-4o-mini-transcribe et GPT-4o-mini-tts
小编 ·

Fonctionnalités, tarifs et cas d'usage des modèles vocaux OpenAI GPT-4o-transcribe, GPT-4o-mini-transcribe et GPT-4o-mini-tts
Openaia lancé une nouvelle génération de modèles vocaux, offrant aux développeurs des capacités d'interaction vocale plus puissantes et prenant en charge le développement d'agents vocaux intelligents. Ces modèles comprennent deux modèles de conversion voix-texte (gpt-4o-transcribe et gpt-4o-mini-transcribe) ainsi qu'un modèle de conversion texte-voix (gpt-4o-mini-tts). Quelles sont leurs caractéristiques respectives ?
1. GPT-4o-transcribe (modèle de conversion voix-texte)
Caractéristiques :
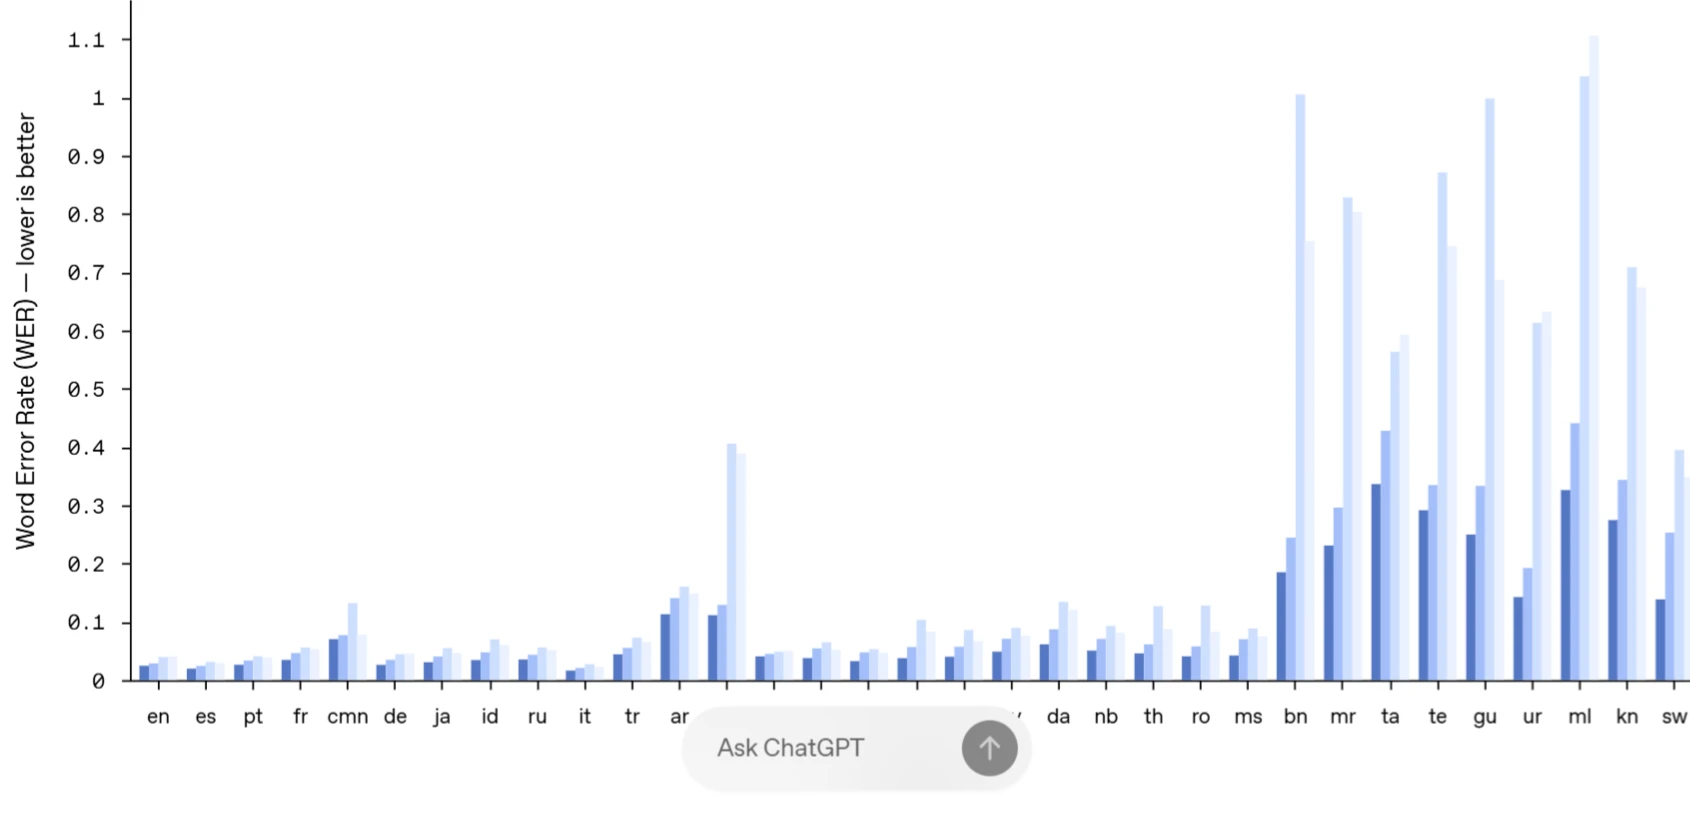
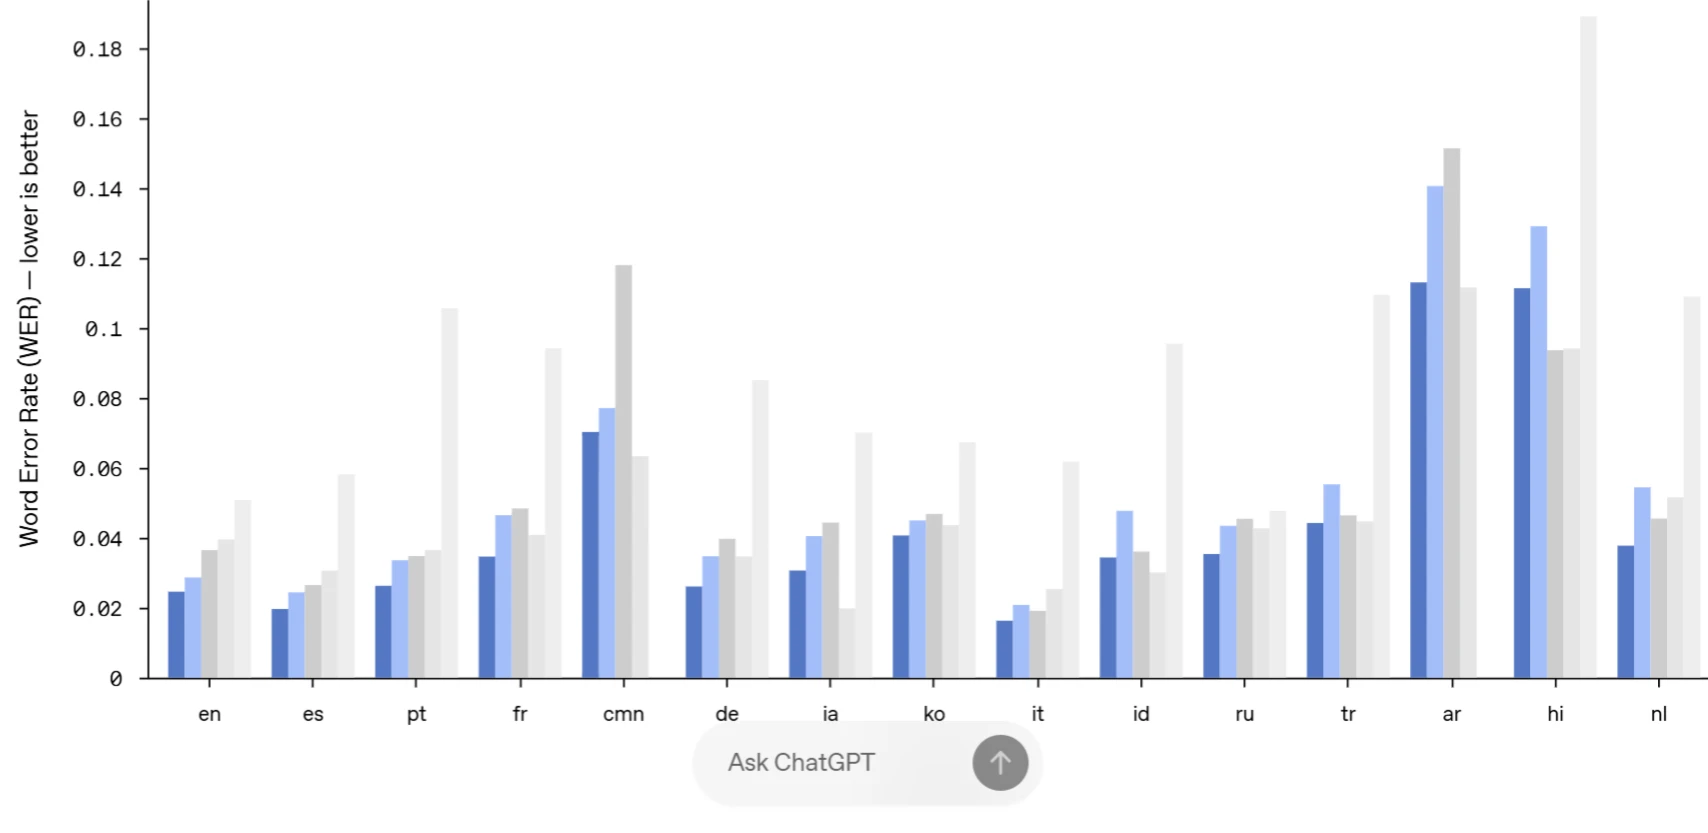
Transcription haute précision : Entraîné pendant une longue période sur des ensembles de données audio diversifiés et de haute qualité, il est capable de mieux capturer les nuances de la voix, de réduire les erreurs de reconnaissance et d'améliorer considérablement la fiabilité de la transcription.
Adaptation aux scénarios complexes : Il dispose d'une forte capacité d'adaptation aux accents, au débit de parole, au bruit ambiant, etc. Même dans des environnements bruyants, avec des accents prononcés ou un débit de parole rapide, il peut reconnaître et transcrire avec précision le contenu vocal.
Capacité de traitement de longs segments vocaux : Capable de traiter des entrées vocales longues, il convient aux scénarios nécessitant une transcription vocale continue prolongée.
Cas d'utilisation :
Comptes rendus de réunions : Transcrire en temps réel ou a posteriori le contenu vocal des réunions en texte, facilitant ainsi la rédaction et la révision après la réunion, et améliorant l'efficacité du travail.
Comptes rendus d'interviews : Dans les scénarios d'interviews journalistiques, d'entretiens, etc., transcrire rapidement et précisément le contenu vocal de l'interviewé en texte, facilitant ainsi le travail éditorial et la publication ultérieurs.
Notes vocales : Transcrire les notes vocales de l'utilisateur en texte, permettant à l'utilisateur de les consulter et de les organiser à tout moment.
Centres d'appels clients : Reconnaître avec précision la voix du client et la transcrire en texte, permettant aux agents du service client de comprendre rapidement les besoins du client et d'y répondre.
Tarification :
Le prix est de 6,00 $ pour 1 million de jetons audio en entrée, soit environ 0,006 $ par minute.
2. GPT-4o-mini-transcribe (version allégée du modèle de conversion voix-texte)
Caractéristiques :
Rapide et efficace : Le modèle est plus compact et la vitesse de calcul est plus rapide, permettant d'accomplir les tâches de transcription vocale en peu de temps.
Faible consommation de ressources : Les exigences en matière de ressources matérielles sont relativement faibles, ce qui le rend adapté à une exécution sur des appareils aux ressources limitées.
Excellent rapport qualité-prix : Bien que le taux d'erreur sur les mots (WER) soit légèrement supérieur à celui du modèle complet, il reste supérieur à celui de l'ancien modèle Whisper.
Cas d'utilisation :
Saisie vocale sur appareils mobiles : Sur les smartphones, les tablettes et autres appareils mobiles, fournir aux utilisateurs une fonction de saisie vocale rapide, par exemple pour dicter des messages textuels.
Petites applications vocales : Convient aux applications vocales de petite taille nécessitant une réponse rapide mais dont les exigences de précision de transcription sont relativement modérées, comme la reconnaissance de commandes vocales ou la prise de notes vocales simples.
Environnements aux ressources limitées : Dans les scénarios où les ressources de calcul sont limitées, comme certains projets de petites entreprises ou de développeurs individuels, il offre une solution de transcription vocale efficace et économique.
Tarification :
Le prix est de 3,00 $ pour 1 million de jetons audio en entrée, soit environ 0,003 $ par minute.
3. GPT-4o-mini-tts (modèle de conversion texte-voix)
Caractéristiques :
Guidage : Pour la première fois, le « guidage » est pris en charge. Les développeurs peuvent non seulement spécifier ce que le modèle « dit », mais aussi contrôler « comment il le dit ». Par exemple, il est possible de prédéfinir un style vocal tel que « calme », « surfeur », « professionnel », « chevalier médiéval », etc., et d'ajuster le style vocal selon les instructions, comme « parle comme un agent du service client compatissant ».
Voix naturelle et fluide : La voix générée est naturelle, fluide et expressive, capable de s'adapter au contenu du texte et au style prédéfini pour une expression vocale correspondante.
Prise en charge multilingue : Prend en charge la conversion texte-voix dans plusieurs langues, répondant aux besoins des utilisateurs de différentes langues.
Cas d'utilisation :
Livres audio : Convertir des livres et des articles en contenu audio, offrant aux utilisateurs une expérience de lecture plus vivante et intéressante.
Service client intelligent : Fournir une fonction de synthèse vocale aux systèmes de service client intelligent, permettant au robot d'interagir avec les utilisateurs d'une voix naturelle et expressive, améliorant ainsi l'expérience utilisateur.
Diffusion vocale : Dans des scénarios tels que les bulletins d'information, les prévisions météorologiques, les bulletins de circulation, etc., convertir le contenu textuel en parole pour la diffusion.
Création de contenu créatif : Dans des domaines tels que la narration créative, la production publicitaire, le doublage vidéo, etc., générer des voix au style et à l'émotion spécifiques selon les différents besoins créatifs.
Tarification :
Le prix est de 0,60 $ pour 1 million de jetons de texte en entrée et de 12,00 $ pour 1 million de jetons audio en sortie, soit environ 0,015 $ par minute.
Les modèles tels que GPT-4o-transcribe sont déjà accessibles aux développeurs via l'interface API d'OpenAI et peuvent être intégrés très facilement dans des applications, avec seulement quelques lignes de code. Les développeurs peuvent choisir le modèle adapté à leurs besoins en fonction des fonctionnalités et de l'environnement, et peuvent également les tester sur le site officiel.
Site officiel :http://open ai.fm/
Blog :https://openai.com/index/introducing-our-next-generation-audio-models/









