
 Assistant scénario▸
 Apps AI
 Actualités AI
Step-Video-TI2V : un modèle IA open source de texte vers vidéo et d'image vers vidéo par StepFun
小编 ·

Step-Video-TI2V : un modèle IA open source de texte vers vidéo et d'image vers vidéo par StepFun
Qu'est-ce que Step-Video-TI2V
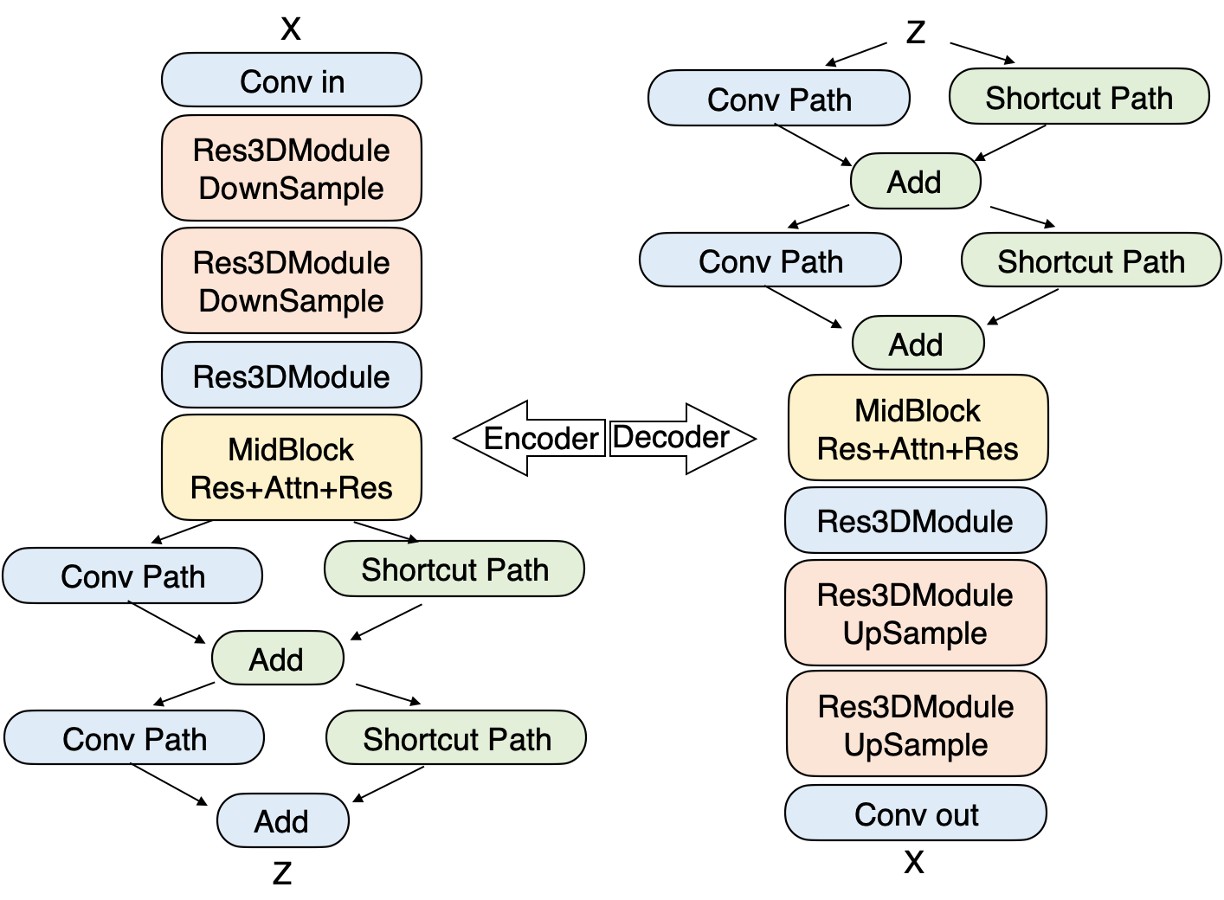
Step-Video-TI2V est un modèle ai de génération d'images en vidéo piloté par texte, open source et développé par l'équipe StepFun. Il peut générer des vidéos de haute qualité à partir des invites textuelles et des images saisies par l'utilisateur. Il est particulièrement performant dans la génération de vidéos de style anime, et prend en charge le contrôle du mouvement, les entrées multilingues ainsi que la sortie de plusieurs formats vidéo.
Fonctionnalités de Step-Video-TI2V
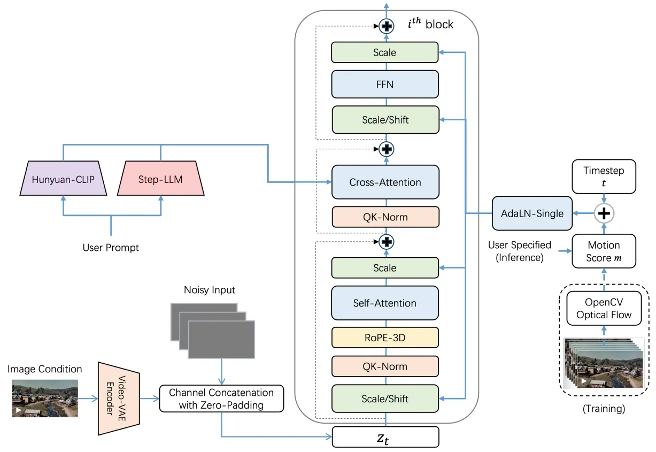
Génération d'images en vidéo pilotée par texte : à partir de l'invite textuelle et de l'image fournies par l'utilisateur, génère une vidéo fortement cohérente avec le contenu du texte et de l'image.
Contrôle du mouvement : l'utilisateur peut spécifier différents niveaux de mouvement afin de contrôler précisément l'amplitude dynamique de la vidéo, en équilibrant dynamisme et stabilité.
Sortie vidéo haute qualité : capable de générer des vidéos de 102 images, 5 secondes, en résolution 540P, et prend en charge plusieurs formats d'image (paysage, portrait et carré).
Prise en charge multilingue : accepte les entrées en chinois et en anglais, facilitant l'utilisation pour des utilisateurs de différentes langues.
Respect des instructions et cohérence du contenu : excellent dans le respect des instructions, la cohérence du sujet et de l'arrière-plan, ainsi que le respect des lois physiques, le contenu vidéo généré correspondant aux attentes de l'utilisateur.
Prise en charge de benchmarks : un jeu de données de référence Step-Video-TI2V-eval a été développé, comprenant 178 paires invite-image du monde réel et 120 paires invite-image de style anime, afin d'évaluer les performances du modèle.
Applications de Step-Video-TI2V
Création de contenu : fournit aux créateurs vidéo de l'inspiration et des ressources, permet de générer rapidement du contenu vidéo et d'économiser du temps et des efforts.
Production d'anime : excellent dans la génération de vidéos de style anime, utilisable pour les démonstrations d'actions de personnages d'anime, les animations de décors, etc.
Publicité et marketing : génère des publicités vidéo attrayantes présentant les caractéristiques et les avantages d'un produit ou d'un service.
Éducation et formation : crée des vidéos éducatives aidant les élèves à mieux comprendre et mémoriser les connaissances.
Divertissement et réseaux sociaux : offre aux utilisateurs une expérience ludique de génération de vidéo à partager sur les réseaux sociaux, augmentant l'interactivité et le plaisir.
Installation et utilisation de Step-Video-TI2V
Installation
1. Configuration requise :Python 3.8 ou version supérieure, ainsi que CUDA 11.3 ou version supérieure (pour l'accélération GPU).
2. Installation des dépendances :installez les packages Python nécessaires à l'aide de la commande suivante :
pip install -r requirements.txt
3. Téléchargement du modèle :téléchargez les fichiers du modèle depuis Hugging Face ou Modelscope, et placez-les dans le répertoire spécifié.
Utilisation
1. Préparation des données d'entrée :préparez une image d'entrée et une invite textuelle, en veillant à ce que l'invite textuelle soit liée au contenu de l'image d'entrée.
2. Exécution du code :utilisez la commande suivante pour exécuter le modèle et générer la vidéo :
python generate_video.py --image_path --text_prompt "" --output_path
3. Ajustement des paramètres :ajustez selon vos besoins les paramètres de contrôle du mouvement (tels que l'amplitude du mouvement) et les autres paramètres de génération afin d'obtenir l'effet vidéo souhaité.
Liens connexes
Dépôt de code GitHub :https://github.com/stepfun-ai/Step-Video-TI2V
Page du modèle sur Hugging Face :https://huggingface.co/stepfun-ai/stepvideo-t2v
Page du modèle sur Modelscope :https://modelscope.cn/models/stepfun-ai/stepvideo-ti2v
Github-ComfyUI :https://github.com/stepfun-ai/ComfyUI-StepVideo
Article :https://arxiv.org/abs/2503.08334









