
 Assistant scénario▸
 Apps AI
 Actualités AI
Chitu : framework d'inférence LLM haute performance open source de l'équipe Tsinghua
小编 ·

Chitu : framework d'inférence LLM haute performance open source de l'équipe Tsinghua
Qu'est-ce que 赤兔(Chitu)?
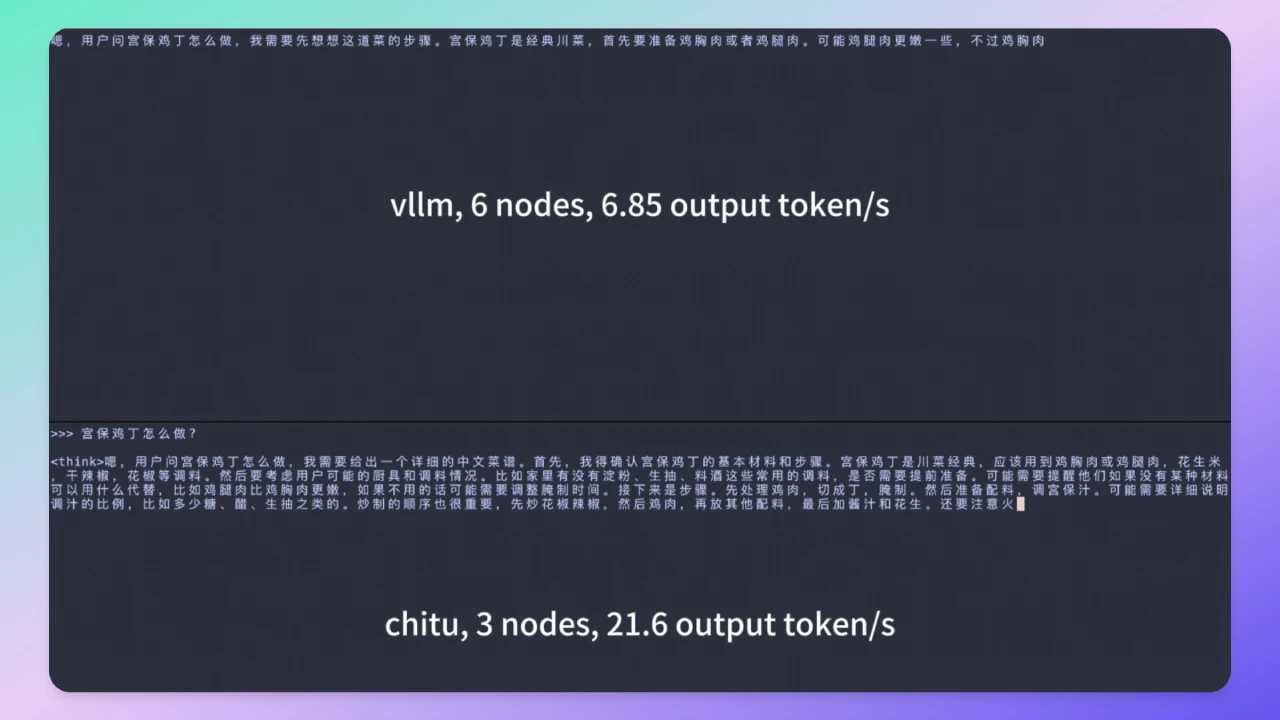
赤兔(Chitu) est un framework d'inférence de grands modèles de langage open source hautes performances développé par une équipe de l'Université Tsinghua. Il se concentre sur l'amélioration de l'efficacité d'inférence, la réduction des coûts, et prend en charge diverses plateformes matérielles et scénarios de déploiement. Il peut permettre de réduire de moitié le coût d'inférence de DeepSeek tout en doublant les performances. L'objectif de 赤兔(Chitu) est de fournir aux entreprises et aux développeurs un moteur d'inférence efficace, flexible et facile à mettre en œuvre, afin d'accélérer l'adoption des grands modèles de langage (LLM) dans les applications concrètes.
Fonctionnalités et caractéristiques de 赤兔(Chitu)
Adaptation à des capacités de calcul diversifiées : prise en charge d'une large gamme de produits NVIDIA, des plus récents fleurons aux modèles plus anciens, avec une optimisation pour les puces nationales.
Évolutivité tous scénarios : du déploiement CPU pur ou single GPU aux déploiements en clusters à grande échelle, offrant des solutions flexibles et évolutives.
Fonctionnement stable à long terme : adapté aux environnements de production réels, capable de supporter de manière stable un trafic métier concurrentiel.
Performances d'inférence élevées : lors de tests sur cluster A800, par rapport à certains frameworks open source étrangers, la vitesse d'inférence est multipliée par 3,15 avec 50 % de GPU en moins.
Réduction des coûts : en optimisant l'utilisation des ressources matérielles, il abaisse le seuil et le coût de déploiement de modèles IA pour les entreprises.
Scénarios d'application de 赤兔(Chitu)
Applications IA de niveau entreprise : nécessitant des services d'inférence hautes performances, à faible latence et à haut débit.
Déploiements en clusters à grande échelle : scénarios nécessitant un fonctionnement efficace dans des environnements multi-GPU ou multi-nœuds.
Environnements à ressources limitées : scénarios nécessitant une inférence efficace avec des ressources matérielles limitées.
Adaptation aux puces nationales : scénarios nécessitant l'exécution de grands modèles de langage sur des plateformes matérielles nationales.
Comment utiliser 赤兔(Chitu)
1. Installation depuis les sources
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2. Inférence sur un seul GPU
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3. Parallélisme hybride (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4. Démarrage du service
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5. Test de performance
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
Dépôt GitHub :https://github.com/thu-pacman/chitu









