
 Assistant scénario▸
 Apps AI
 Actualités AI
OpenManus-RL : projet open-source pour améliorer le raisonnement et la prise de décision des agents LLM
小编 ·

OpenManus-RL : projet open-source pour améliorer le raisonnement et la prise de décision des agents LLM
Qu'est-ce qu'OpenManus-RL ?
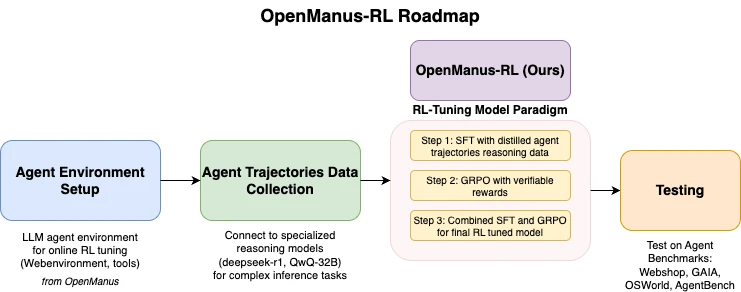
OpenManus-RL est un projet open source développé conjointement par UIUC-Ulab et l'équipe OpenManus de la communauté MetaGPT. Il vise à améliorer les capacités de raisonnement et de prise de décision des grands modèles de langage (LLM) agents grâce à la technique d'apprentissage par renforcement (RL). Basé sur l'expérience de modèles avancés tels que Deepseek-R1 et QwQ-32B, le projet explore de nouvelles méthodes d'ajustement afin de renforcer les performances des agents dans des tâches complexes. Les fonctionnalités principales d'OpenManus-RL incluent la mise en place d'environnements pour agents, la collecte de données de trajectoire, la prise en charge de l'ajustement par apprentissage par renforcement, ainsi que l'intégration de benchmarks. Il intègre également plusieurs stratégies d'apprentissage par renforcement, telles que Tree-of-Thoughts et la recherche arborescente de Monte Carlo (Monte Carlo Tree Search), afin d'améliorer les capacités de raisonnement des agents.
Fonctionnalités d'OpenManus-RL
Mise en place d'environnements pour agents : fournit des outils de configuration d'environnement pour agents dédiés à l'ajustement par apprentissage par renforcement (RL) en ligne, permettant aux utilisateurs de personnaliser l'environnement de l'agent pour des tâches spécifiques.
Collecte de données de trajectoire : permet de se connecter à des modèles tels que Deepseek-R1 et QwQ-32B, afin de recueillir les données comportementales sur des tâches complexes, fournissant ainsi un support de données pour l'ajustement ultérieur.
Prise en charge de l'ajustement RL : prend en charge des méthodes d'apprentissage par renforcement permettant de personnaliser le comportement des agents. Les utilisateurs peuvent optimiser le comportement de l'agent en spécifiant, par exemple, des fonctions de récompense.
Intégration de benchmarks : intègre des environnements de test tels que WebShop, GaiA, OSWorld et AgentBench, facilitant l'évaluation quantitative des performances des agents.
Stratégies diversifiées : intègre des stratégies d'apprentissage par renforcement telles que Tree-of-Thoughts et Monte Carlo Tree Search, afin d'améliorer les capacités de raisonnement des agents dans les tâches de planification à long terme.
Collaboration communautaire : permet aux utilisateurs de soumettre du code, des jeux de données, etc. Les contributeurs importants peuvent devenir co-auteurs des articles scientifiques, favorisant ainsi le développement collaboratif au sein de la communauté.
Partage des avancées en temps réel : présente de manière dynamique le processus et les résultats de l'ajustement RL, permettant aux utilisateurs de suivre les dernières avancées du projet.
Cas d'utilisation d'OpenManus-RL
Prise de décision d'achat : optimise les performances de l'agent dans les tâches de décision d'achat en personnalisant l'environnement de l'agent, par exemple en augmentant le taux de réussite d'achat dans WebShop.
Analyse de tâches complexes : analyse les performances de l'agent dans des tâches complexes, telles que le taux de réussite et le temps de réponse dans les benchmarks GAIA et OSWorld, aidant les développeurs à comparer les performances des modèles.
Optimisation de tâches multimodales : optimise le comportement de l'agent dans des environnements de tâches multimodales tels qu'OSWorld, améliorant ainsi ses performances dans ce type de tâches.
Tâches de planification à long terme : exploite les stratégies diversifiées intégrées pour améliorer les capacités de raisonnement de l'agent dans les tâches de planification à long terme, par exemple en optimisant son comportement via la stratégie Tree-of-Thoughts.
Installation d'OpenManus-RL
1. Créer un environnement Conda : pour éviter les conflits de dépendances, il est recommandé de créer un environnement avec Conda, à l'aide des commandes suivantes :
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. Cloner le projet : assurez-vous que Git est installé, puis clonez le projet et accédez au répertoire du projet, à l'aide des commandes suivantes :
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. Installer les dépendances : exécutez la commande suivante à la racine du projet pour installer les dépendances. Si le téléchargement est lent, vous pouvez utiliser un miroir chinois :
pip install -r requirements.txt
ou
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
Des outils supplémentaires de visualisation doivent être installés :
pip install matplotlib numpy
4. Configurer le modèle et le jeu de données :
Réglage fin supervisé (SFT) : spécifiez le modèle et le jeu de données, à l'aide de la commande suivante :
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
Ajustement par apprentissage par renforcement (GRPO) : configurez la fonction de récompense, à l'aide de la commande suivante :
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
Le jeu de données peut être obtenu depuis Huggingface.
5. Lancer le projet :
Exécution du SFT sur un seul GPU :
python -m openmanus_rl.sft --output_dir data/sft-output
Exécution de GRPO sur plusieurs GPU (nécessite la configuration de zero3.yaml) :
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
Utilisation d'OpenManus-RL
1. Mise en place de l'environnement de l'agent :
Exécutez python -m openmanus_rl.sft pour générer l'environnement de base.
Modifiez les fichiers de configuration (par exemple, l'objectif de la tâche ou la fonction de récompense).
Exécutez python -m openmanus_rl.grpo pour démarrer l'ajustement.
2. Collecte de données et tests :
Configurer le modèle (par exemple Deepseek-R1) : python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
Lancer le test : --benchmark GAIA, les résultats seront enregistrés dans le répertoire data/.
3. Opérations d'ajustement RL :
Lancer le mode GRPO : python -m openmanus_rl.grpo --reward_funcs accuracy
Consultez les journaux d'entraînement ; le modèle sera enregistré dans data/grpo-output.
Adresse du dépôt GitHub : https://github.com/OpenManus/OpenManus-RL









