
 Assistant scénario▸
 Apps AI
 Actualités AI
SpeakerKit : identifiez rapidement et précisément les différents locuteurs d'un enregistrement audio
小编 ·

SpeakerKit : identifiez rapidement et précisément les différents locuteurs d'un enregistrement audio
Qu'est-ce que SpeakerKit ?
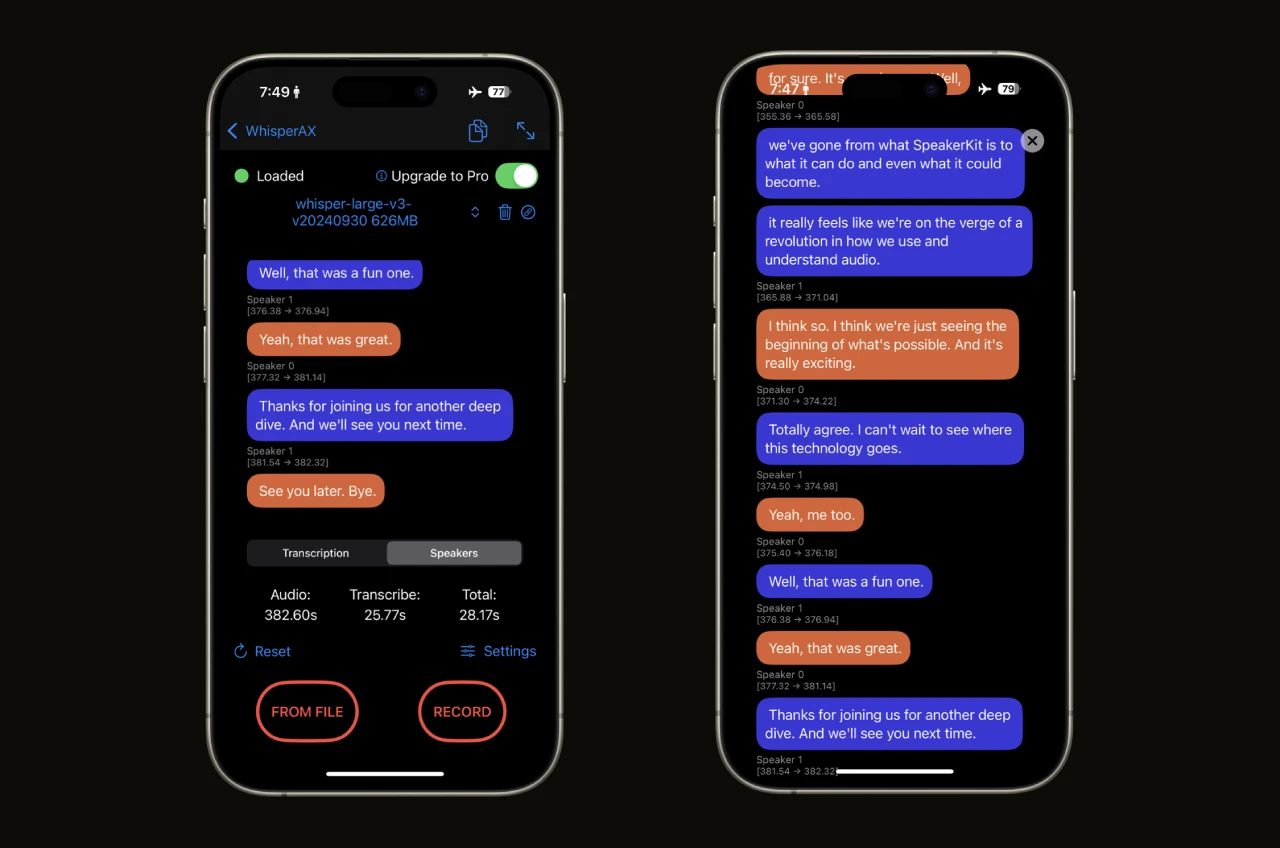
SpeakerKit est un outil de diarisation (identification des locuteurs) sur appareil développé par Argmax, qui permet d'identifier rapidement et efficacement les différents locuteurs dans un fichier audio. Il fonctionne de concert avec WhisperKit (un outil de transcription audio) pour générer des transcriptions étiquetées par locuteur. Il convient aux applications nécessitant une identification rapide et précise des locuteurs dans un contenu audio.
Caractéristiques principales de SpeakerKit
Vitesse :
Lors du traitement d'un audio de 4 minutes sur un iPhone, SpeakerKit effectue la diarisation en seulement environ 1 seconde, surpassant de loin les autres systèmes similaires.
Lorsqu'il est combiné avec WhisperKit, le temps total de transcription et de diarisation n'est que de 25 secondes.
Qualité :
Le taux d'erreur de SpeakerKit est comparable à celui des systèmes leaders du secteur (comme Pyannote), malgré une vitesse multipliée par plusieurs.
Taille :
La taille totale est d'environ 10 Mo, ce qui facilite son intégration dans une application ou son téléchargement rapide.
Compatibilité :
Prise en charge des appareils sous iOS 16 et macOS 13 (et versions ultérieures).
Le support Android est en cours de développement.
Modularité :
SpeakerKit peut être utilisé avec WhisperKit pour produire des transcriptions étiquetées par locuteur, mais il peut également être intégré à d'autres moteurs de transcription, offrant une flexibilité supérieure à celle des API côté serveur.
Benchmarks
Argmax a développé un toolkit Python nommé SDBench, destiné à évaluer de manière standardisée les performances des systèmes de diarisation sur 13 jeux de données largement utilisés. Le code de SDBench sera open source, et l'article associé sera publié en avril 2025.
Feuille de route
Optimisation de la qualité de transcription :La qualité de la diarisation autonome de SpeakerKit a déjà atteint le niveau de référence du secteur (mesurée par le DER). L'étape suivante consiste à optimiser son utilisation conjointe avec WhisperKit afin d'améliorer la qualité des transcriptions étiquetées par locuteur (mesurée par le WDER).
Fonctionnalité de reconnaissance des locuteurs :SpeakerKit proposera prochainement une nouvelle fonctionnalité permettant d'extraire les empreintes vocales des locuteurs et de les reconnaître dans de nouveaux contextes.
Lecture détaillée :https://www.argmaxinc.com/blog/speakerkit
HuggingFace :https://huggingface.co/argmaxinc/speakerkit-pro









