
 Assistant scénario▸
 Apps AI
 Actualités AI
HunyuanVideo-I2V : le framework open source image-vers-vidéo de Tencent Hunyuan
小编 ·

HunyuanVideo-I2V : le framework open source image-vers-vidéo de Tencent Hunyuan
Qu'est-ce que HunyuanVideo-I2V ?
HunyuanVideo-I2V est un nouveau cadre de génération vidéo à partir d'images open source publié par l'équipe Hunyuan de Tencent le 6 mars 2025. Basé sur le précédent HunyuanVideo open source, ce cadre étend davantage les capacités de génération d'images vers vidéo, permettant aux créateurs vidéo de générer des courtes vidéos de haute qualité à partir d'une seule image, tout en prenant en charge l'entraînement d'effets spéciaux personnalisés.
Fonctionnalités de HunyuanVideo-I2V
Génération vidéo à partir d'images : HunyuanVideo-I2V peut prendre une image statique comme première frame de la vidéo et générer un contenu vidéo correspondant en fonction des sous-titres ou des descriptions fournis par l'utilisateur.
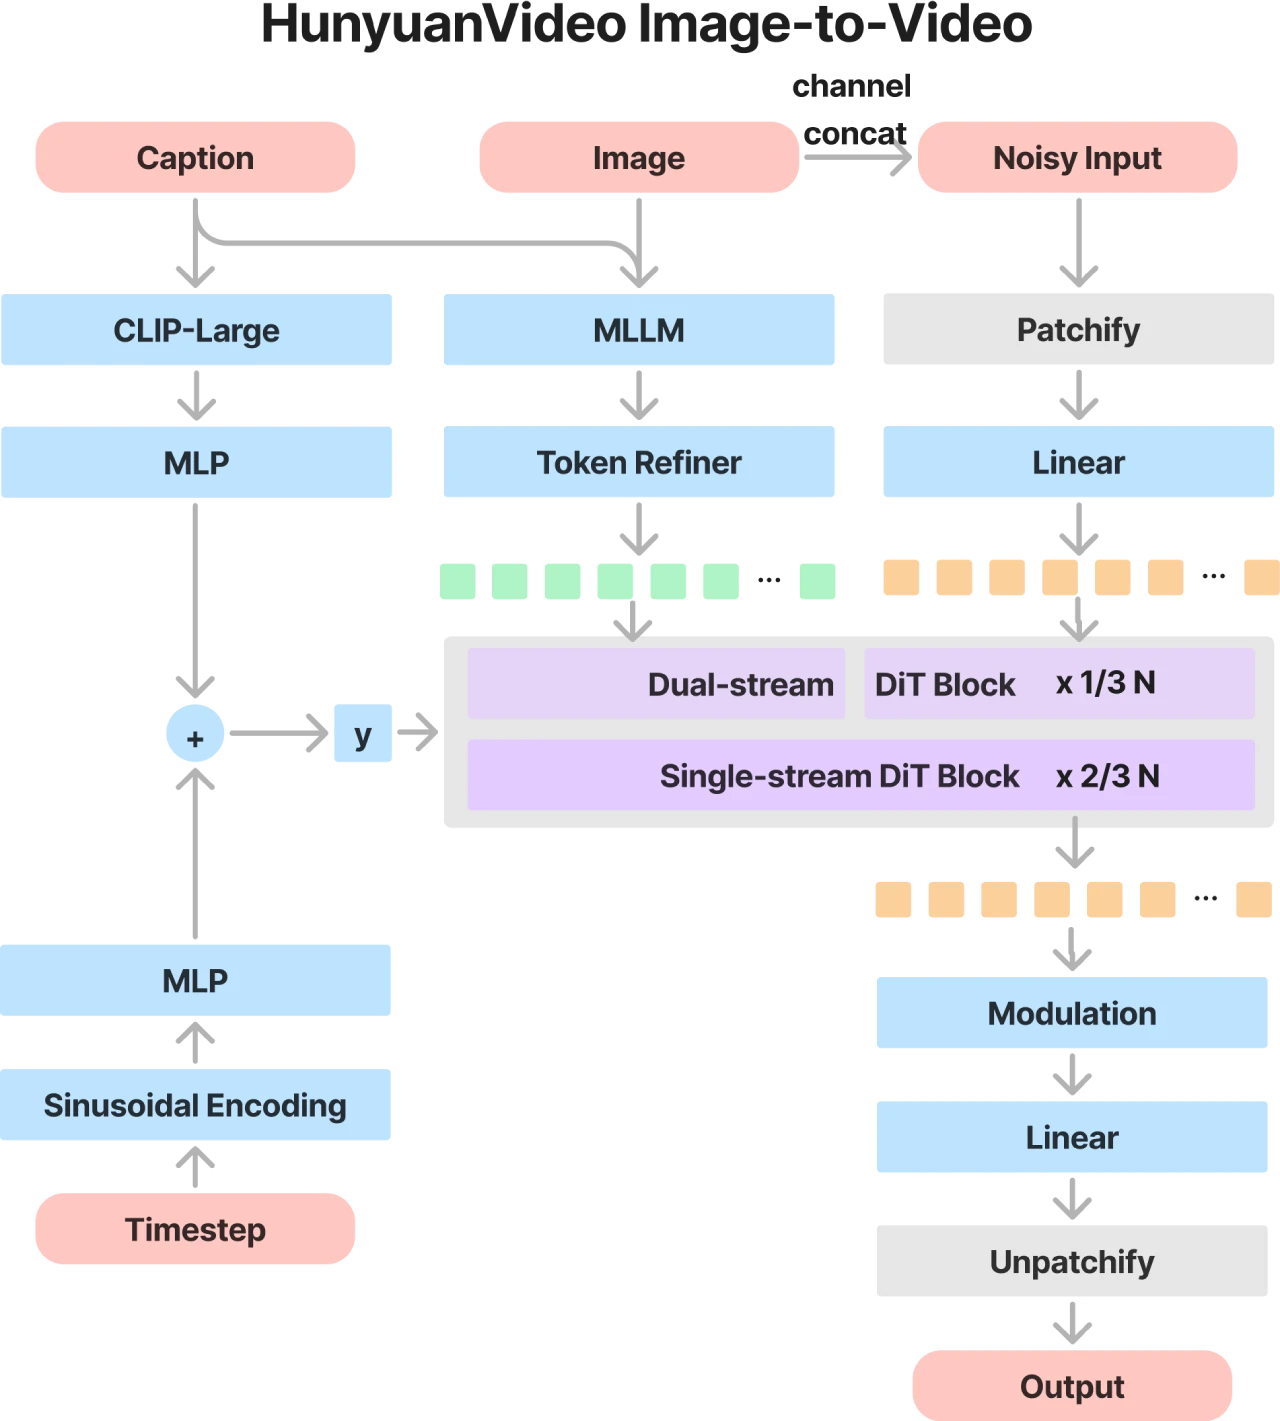
Grand modèle de langage multimodal (MLLM) : Le modèle utilise un grand modèle de langage multimodal pré-entraîné comme encodeur de texte, améliorant considérablement la compréhension du contenu sémantique de l'image d'entrée.
3D Autoencodeur Variationnel (3D VAE) : Un 3D VAE entraîné avec la technologie CausalConv3D, qui compresse les vidéos et les images de l'espace pixelique dans un espace latent compact, réduisant le nombre de tokens dans les modèles en aval.
Conception de modèle hybride à double flux puis à flux unique : Pendant la phase à double flux, les tokens vidéo et texte sont traités indépendamment via plusieurs blocs Transformer ; pendant la phase à flux unique, les tokens vidéo et texte sont concaténés pour la fusion d'informations multimodales.
Stratégie d'entraînement progressif : Passage progressif de vidéos courtes en basse résolution à des vidéos longues en haute résolution, améliorant la vitesse de convergence du modèle.
Modèle de réécriture de prompts : Résout les problèmes de variation de style linguistique et de longueur des prompts utilisateur, convertissant les prompts saisis par l'utilisateur dans un format plus facilement compréhensible par le modèle.
Entraînement LoRA personnalisable : Prend en charge l'entraînement de modèles de génération vidéo avec des effets spécifiques à partir d'une petite quantité de données, tels que « croissance des cheveux » ou « mouvements de personnages ».
Inférence efficace : Fournit une inférence sur un seul GPU et une inférence parallèle en série multi-GPU, prenant en charge une vitesse d'inférence plus rapide.
Architecture technique de HunyuanVideo-I2V
HunyuanVideo-I2V perpétue l'approche conceptuelle globale de HunyuanVideo en termes d'architecture, tout en l'optimisant pour la tâche de génération d'images vers vidéo. Son cœur réside dans l'utilisation de la technique de concaténation d'espace latent d'image pour injecter les informations clés de l'image de référence dans le processus de génération vidéo, tout en réalisant une fusion intermodale profonde des informations textuelles et visuelles via le MLLM.
Comment utiliser HunyuanVideo-I2V
1. Installation et dépendances
Installez PyTorch et les autres dépendances. Le guide d'installation détaillé est disponible sur la page GitHub.
Il est recommandé d'utiliser un GPU NVIDIA avec au moins 80 Go de mémoire vidéo.
2. Téléchargement du modèle pré-entraîné
Les poids du modèle pré-entraîné peuvent être téléchargés depuis la page GitHub ou la page Hugging Face.
3. Code d'inférence
Utilisez le code d'inférence fourni (tel que sample_video.py) pour générer des vidéos.
4. Entraînement LoRA
Un code d'entraînement LoRA est fourni, permettant aux utilisateurs d'entraîner des modèles de génération vidéo avec des effets spécifiques à partir d'une petite quantité de données.
Cas d'utilisation de HunyuanVideo-I2V
Création de contenu vidéo : Fournit aux créateurs vidéo des outils de génération vidéo efficaces et de haute qualité.
Production cinématographique et télévisuelle : Génération de contenus vidéo de qualité cinématographique.
Vidéos personnalisées : Génération de vidéos personnalisées à partir des images et descriptions téléchargées par l'utilisateur.
Site officiel :https://video.hunyuan.tencent.com/
GitHub :https://github.com/Tencent/HunyuanVideo-I2V
Hugging Face : https://huggingface.co/tencent/HunyuanVideo-I2V









