
 Assistant scénario▸
 Apps AI
 Actualités AI
CSM : le modèle de synthèse vocale de Sesame, comme parler à une vraie personne
小编 ·

CSM : le modèle de synthèse vocale de Sesame, comme parler à une vraie personne
Qu'est-ce que le CSM ?
Le CSM (Conversational Speech Model) est un modèle de synthèse vocale conversationnelle développé par l'entreprise Sesame. Il repose sur une architecture Transformer et adopte une méthode d'apprentissage multimodal de bout en bout, capable d'intégrer le contexte et les nuances émotionnelles pour produire une voix humaine extrêmement réaliste, ce qui le distingue dans le domaine de la synthèse vocale.
Fonctionnalités et caractéristiques du CSM
Expression vocale naturelle : imite l'intonation, le rythme et le timbre d'une véritable voix humaine, résolvant le problème des intonations monotones des systèmes de synthèse vocale traditionnels, rendant la voix synthétique quasiment indiscernable d'une voix humaine.
Expression émotionnelle subtile : peut intégrer des éléments naturels tels que les émotions, les pauses et l'accentuation, transmettant des sentiments comme la colère, la tristesse ou l'excitation, rendant les conversations plus expressives.
Réponse à faible latence : grâce à des méthodes de calcul optimisées, la conversation reste fluide, avec un temps de réponse de l'ai extrêmement court, proche de la réaction humaine instantanée.
Interaction multimodale : peut traiter simultanément du texte et l'historique vocal, dispose d'une capacité de compréhension contextuelle, comprend le contexte et les émotions de la conversation, rendant la voix plus naturelle et l'interaction plus riche.
Cohérence de la personnalité : maintient des caractéristiques vocales stables, évitant les incohérences selon les situations et éliminant l'intonation robotique des systèmes TTS traditionnels.
Modélisation dynamique de la conversation : simule les pauses naturelles, le débit et l'accentuation propres aux conversations humaines, renforçant le réalisme et l'interactivité des échanges vocaux.
Points forts technologiques du CSM
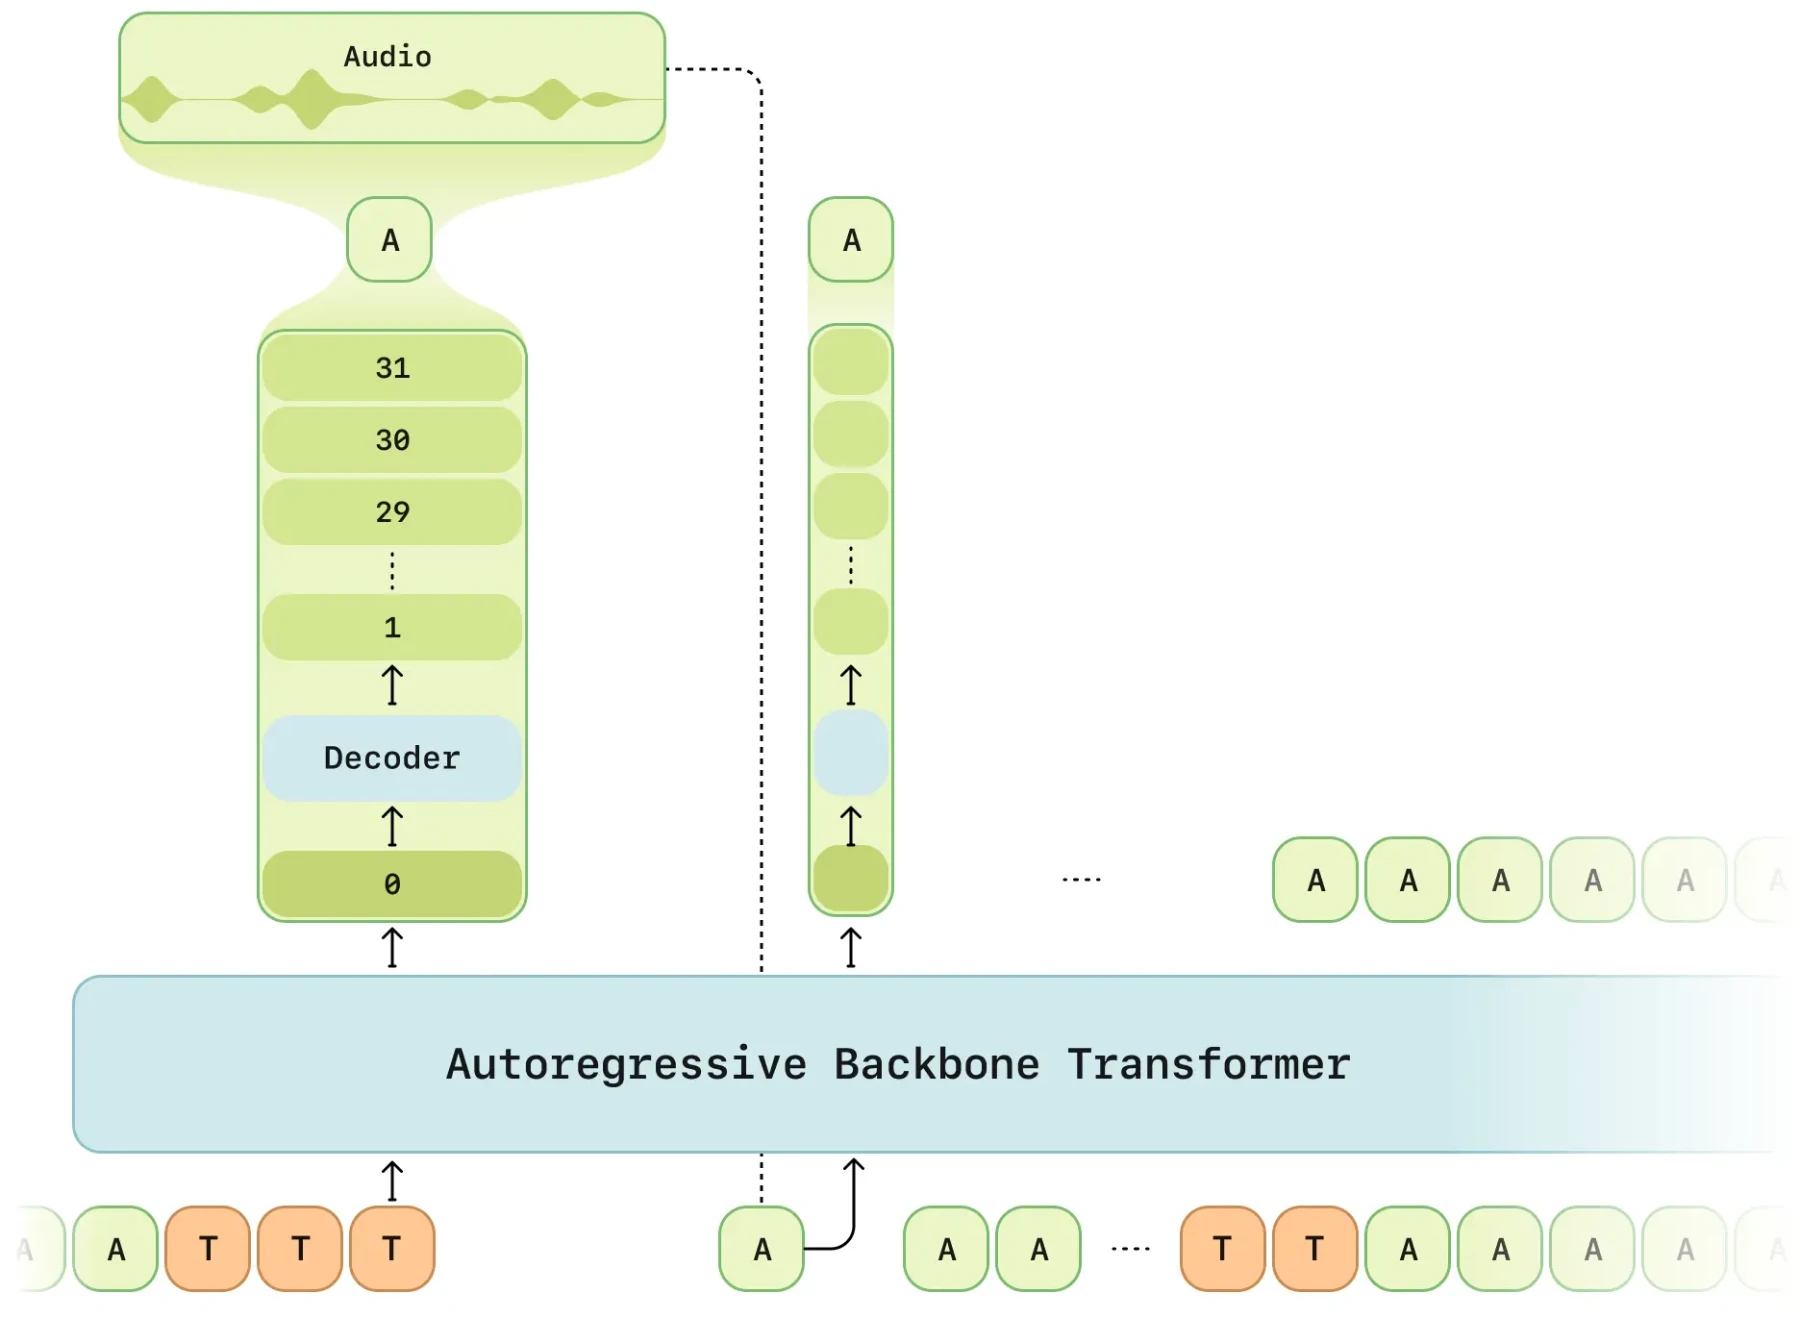
Architecture Transformer multimodale de bout en bout : génère directement une voix de haute qualité à partir du texte, sans étape de traitement intermédiaire. Avec le Transformer au cœur du système, la voix IA dispose d'une capacité de compréhension contextuelle. Le texte est traité par le LLaMA Tokenizer, la voix est encodée par le Mimi Tokenizer, et la quantification RVQ est utilisée.
Encodage audio basé sur la Residual Vector Quantization (RVQ) : utilise deux types de tokens audio : les tokens sémantiques, qui représentent la sémantique vocale et les caractéristiques de prononciation, et les tokens acoustiques, qui représentent les détails tels que la hauteur, le timbre et la prosodie. Grâce à un entraînement RVQ hiérarchique, les différentes couches prédisent les caractéristiques essentielles et les détails fins, évitant la perte d'information et améliorant le naturel de la voix.
Optimisation des calculs et inférence à faible latence
Optimisation du mode de latence : les couches RVQ de niveau inférieur sont d'abord calculées, puis les caractéristiques détaillées des couches supérieures sont calculées successivement, accélérant la vitesse d'inférence.
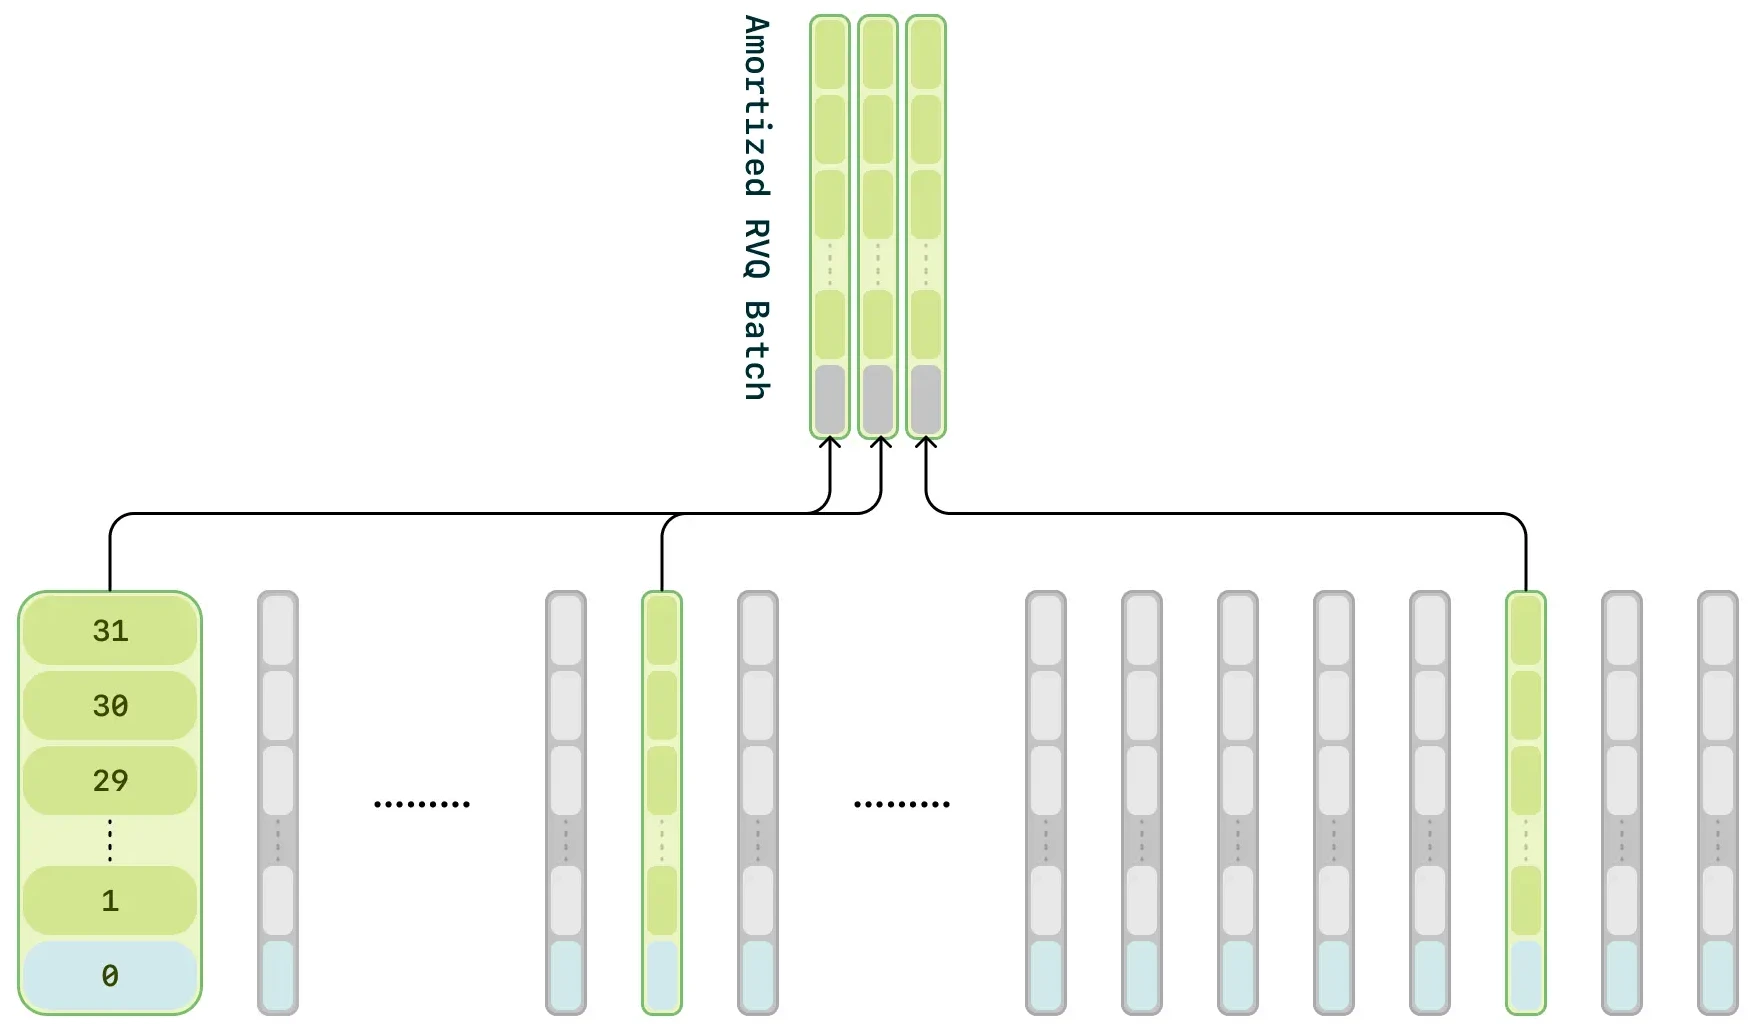
Amortissement des calculs : lors de la phase d'entraînement, 1/16 des trames audio sont échantillonnées de manière aléatoire pour optimisation, réduisant les besoins en calcul sans affecter la qualité audio.
Structure Transformer en deux étapes : un Transformer principal traite les informations textuelles et audio et prédit la structure de base ; un décodeur léger affine l'audio, réduisant la charge de calcul et améliorant la vitesse d'inférence.
Applications étendues du CSM
Assistants intelligents : rend les interactions vocales des enceintes intelligentes et des assistants virtuels plus naturelles et chaleureuses, comme si l'on conversait avec une vraie personne.
Service client : utilisé dans les systèmes de service client pour offrir aux utilisateurs une expérience d'interaction plus fluide et améliorer leur satisfaction.
Éducation et formation : crée un environnement conversationnel réaliste dans les applications d'apprentissage des langues, aidant les apprenants à comprendre et à pratiquer les connaissances linguistiques.
Industrie du divertissement : donne aux personnages des jeux et des animations une voix vivante et réaliste, rendant les histoires plus captivantes.
Création d'assistants virtuels : permet de créer des assistants virtuels à la voix plus naturelle, offrant des services attentionnés.
Optimisation des outils de traduction : génère des conversations naturelles et fluides lors de la traduction vocale en temps réel, améliorant l'expérience de traduction.
Interactivité sur les plateformes éducatives : joue un rôle dans les dialogues vocaux interactifs des plateformes éducatives, renforçant le caractère ludique et l'efficacité de l'apprentissage.
Comment utiliser le CSM
Expérience en ligne
Vous pouvez visiter le site officiel de Sesame (sesame.com/voicedemo) pour découvrir les effets de la technologie de synthèse vocale.
Intégration dans un produit
Les développeurs peuvent intégrer le modèle vocal Sesame dans des produits ou services tels que des assistants vocaux ou des systèmes de service client intelligents, afin d'améliorer les capacités d'interaction vocale.
Recherche et développement
La société Sesame prévoit d'agrandir la taille du modèle et d'augmenter le volume des jeux de données. Les chercheurs peuvent suivre les présentations et démonstrations officielles (https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice ) pour découvrir les derniers résultats et avancées technologiques.
Pour une expérience en ligne, vous pouvez consulter :https://www.sesame.com/research/crossing_the_uncanny_valley_of_voice#demo









