
 Assistant scénario▸
 Apps AI
 Actualités AI
Migician : modèle multimodal de l'Université Tsinghua et collaborateurs pour la localisation d'objets sur plusieurs images dans des scènes complexes
小编 ·

Migician : modèle multimodal de l'Université Tsinghua et collaborateurs pour la localisation d'objets sur plusieurs images dans des scènes complexes
Qu'est-ce que Migician ?
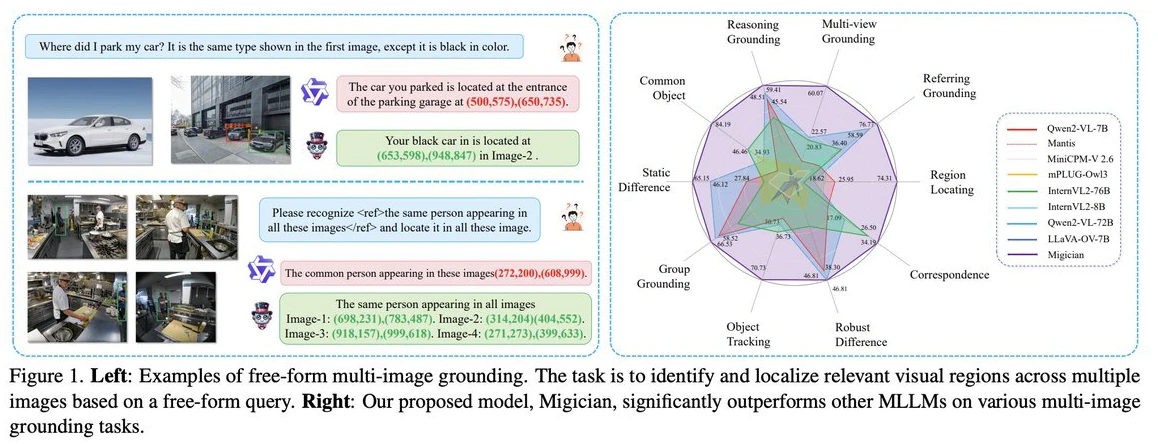
Migician est un grand modèle de langage multimodal développé conjointement par l'Université Tsinghua, l'Université Jiaotong de Pékin et l'Université des sciences et technologies de Huazhong, capable de réaliser un positionnement libre (free-form) et précis dans des scénarios multi-images. Il prend en charge la localisation rapide de zones cibles dans plusieurs images grâce à des descriptions textuelles, des images ou une combinaison des deux, améliorant ainsi les capacités de localisation dans les scénarios multi-images.
Fonctionnalités principales de Migician
Localisation inter-images : Migician prend en charge plusieurs méthodes de localisation inter-images, notamment la recherche par image et les requêtes combinées « texte + image ». Par exemple, dans le cadre de la vidéosurveillance, en saisissant une description textuelle telle que « un homme portant un haut noir, un jean bleu et une casquette de baseball blanche », le modèle peut localiser rapidement la personne correspondant à cette description parmi de nombreuses images de surveillance.
Fusion multimodale : grâce à une architecture de réseau neuronal avancée, Migician intègre efficacement les informations visuelles et linguistiques, et explore en profondeur les associations sémantiques entre les images. Par exemple, pour la tâche « trouver l'image contenant une voiture rouge dans un ensemble de vues de rues urbaines », le modèle extrait les caractéristiques visuelles telles que la couleur et la forme des images, tout en analysant les informations sémantiques de « voiture rouge » dans le texte, puis fusionne les deux pour localiser plus précisément la cible.
Optimisation du raisonnement CoT (Chain-of-Thought) : Migician introduit une optimisation du raisonnement CoT, décomposant les problèmes complexes en plusieurs sous-problèmes simples afin de déduire progressivement la réponse finale. Par exemple, pour localiser un objet dans une pièce spécifique, le modèle détermine d'abord la zone où cette pièce peut se trouver en fonction de la description textuelle, puis localise précisément l'objet dans les images de cette zone.
Cadre de bout en bout : Migician adopte un cadre de bout en bout, traitant directement les entrées multi-images, évitant ainsi l'accumulation d'erreurs et le manque d'efficacité des méthodes de raisonnement traditionnelles en plusieurs étapes.
Performances du modèle
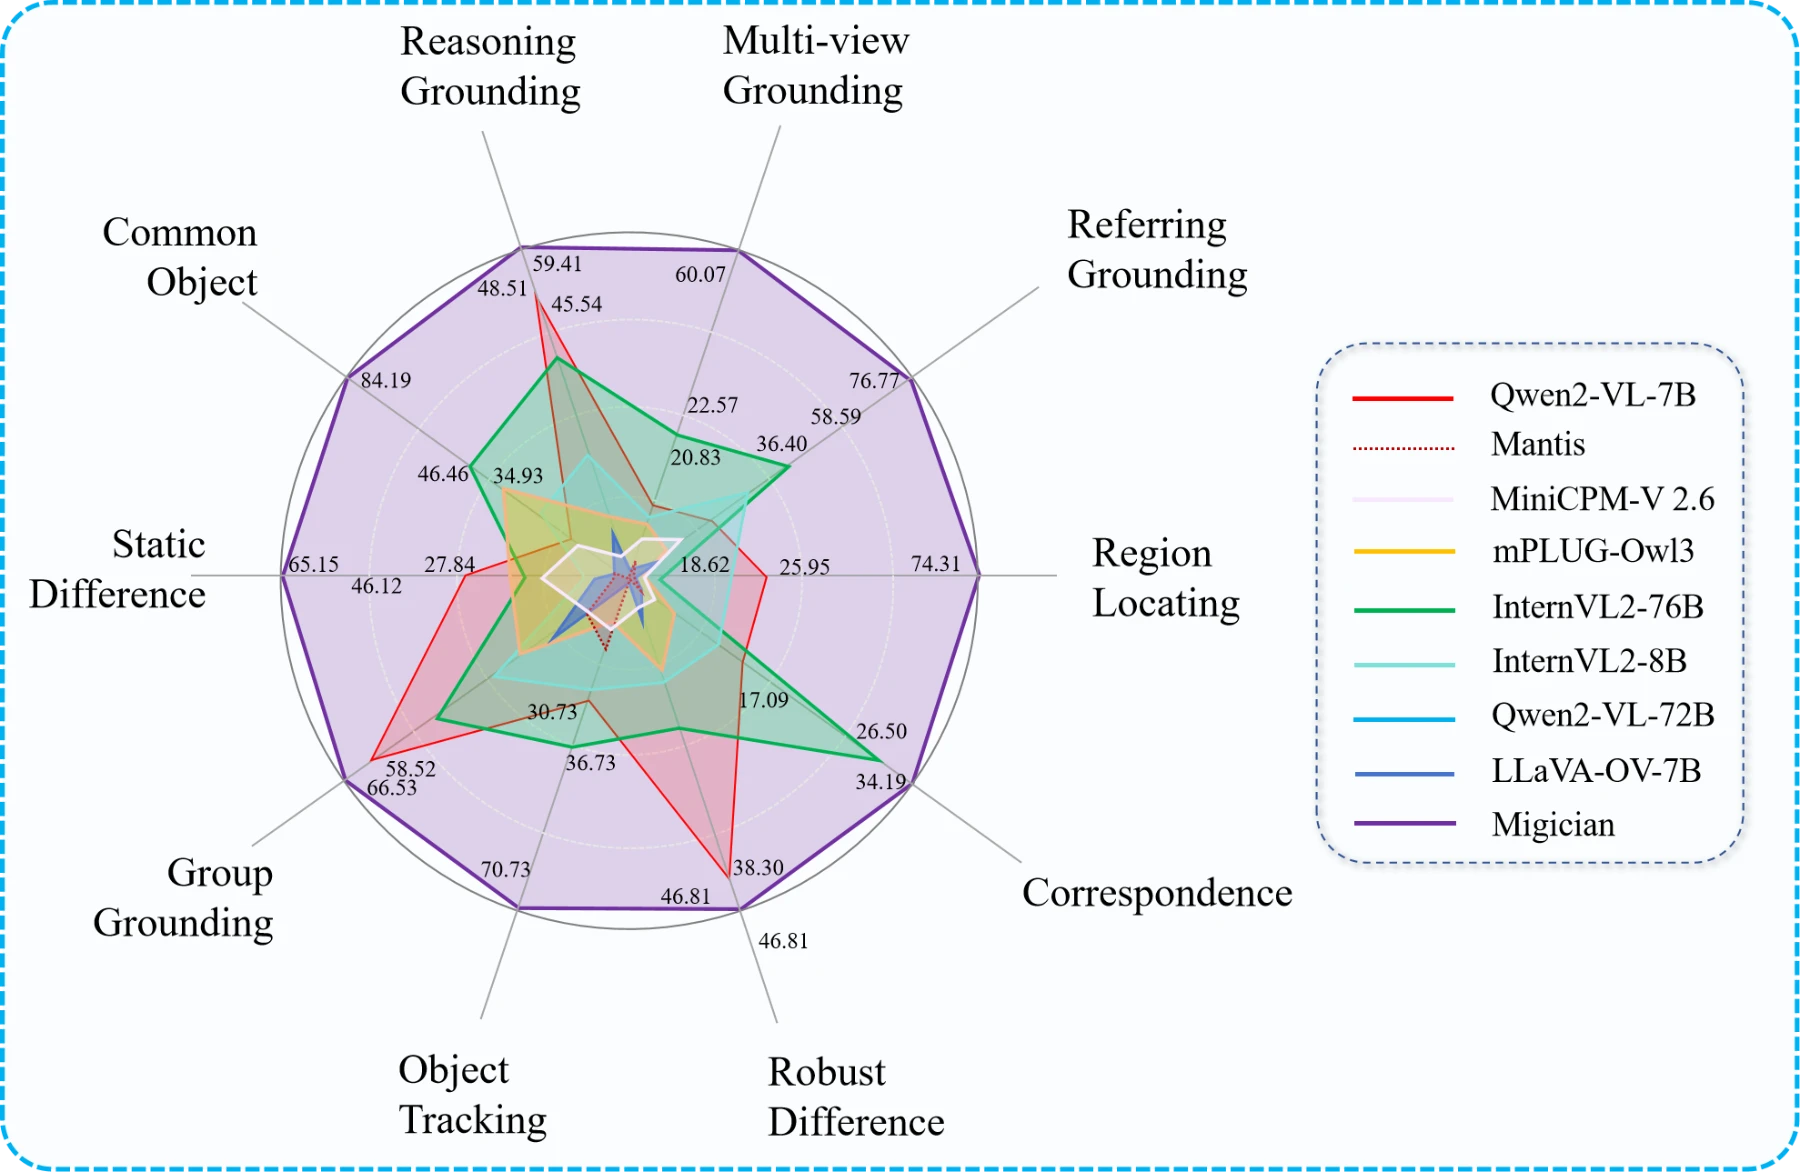
Performances : Migician obtient d'excellents résultats dans les tâches de localisation multi-images, surpassant nettement les MLLM existants, et dépasse même plusieurs modèles plus grands de 70B sur de nombreuses tâches. Concrètement, Migician obtient un score supérieur de 21,61 % au meilleur MLLM existant sur MIG-Bench.
Indicateurs d'évaluation : MIG-Bench fournit des indicateurs d'évaluation tels que [email protected], [email protected], [email protected] et l'IOU moyenne. Les utilisateurs peuvent effectuer une évaluation en un clic en exécutant le script MIG_bench_eval.py.
Scénarios d'application de Migician
Vidéosurveillance : analyse en temps réel des images de plusieurs caméras de surveillance, localisation rapide de personnes suspectes, de véhicules ou d'événements anormaux.
Conduite autonome : fusion des informations issues de plusieurs capteurs d'imagerie du véhicule, combinée à des descriptions textuelles de la route, des obstacles, des panneaux de signalisation, etc., afin d'aider le véhicule à percevoir plus précisément son environnement.
Imagerie médicale : localisation rapide des zones lésées dans plusieurs images médicales, pour aider au diagnostic des maladies.
Intelligence incarnée des robots : aide les robots à localiser rapidement des objets cibles dans des environnements complexes, afin d'accomplir des tâches de préhension et de manutention.
Ressources du projet Migician
Dépôt GitHub :https://github.com/thunlp/Migician
Adresse de l'article :https://arxiv.org/pdf/2501.05767
Migician est un puissant outil spécialement conçu pour les tâches de localisation multi-images. Grâce au jeu de données à grande échelle MGrounding-630k et au benchmark complet MIG-Bench, ses capacités de localisation dans les scénarios multi-images ont été considérablement améliorées.









