
 Assistant scénario▸
 Apps AI
 Actualités AI
Mercury : le premier grand modèle de langage à diffusion (dLLM) de qualité commerciale
小编 ·

Mercury : le premier grand modèle de langage à diffusion (dLLM) de qualité commerciale
Qu'est-ce que Mercury ?
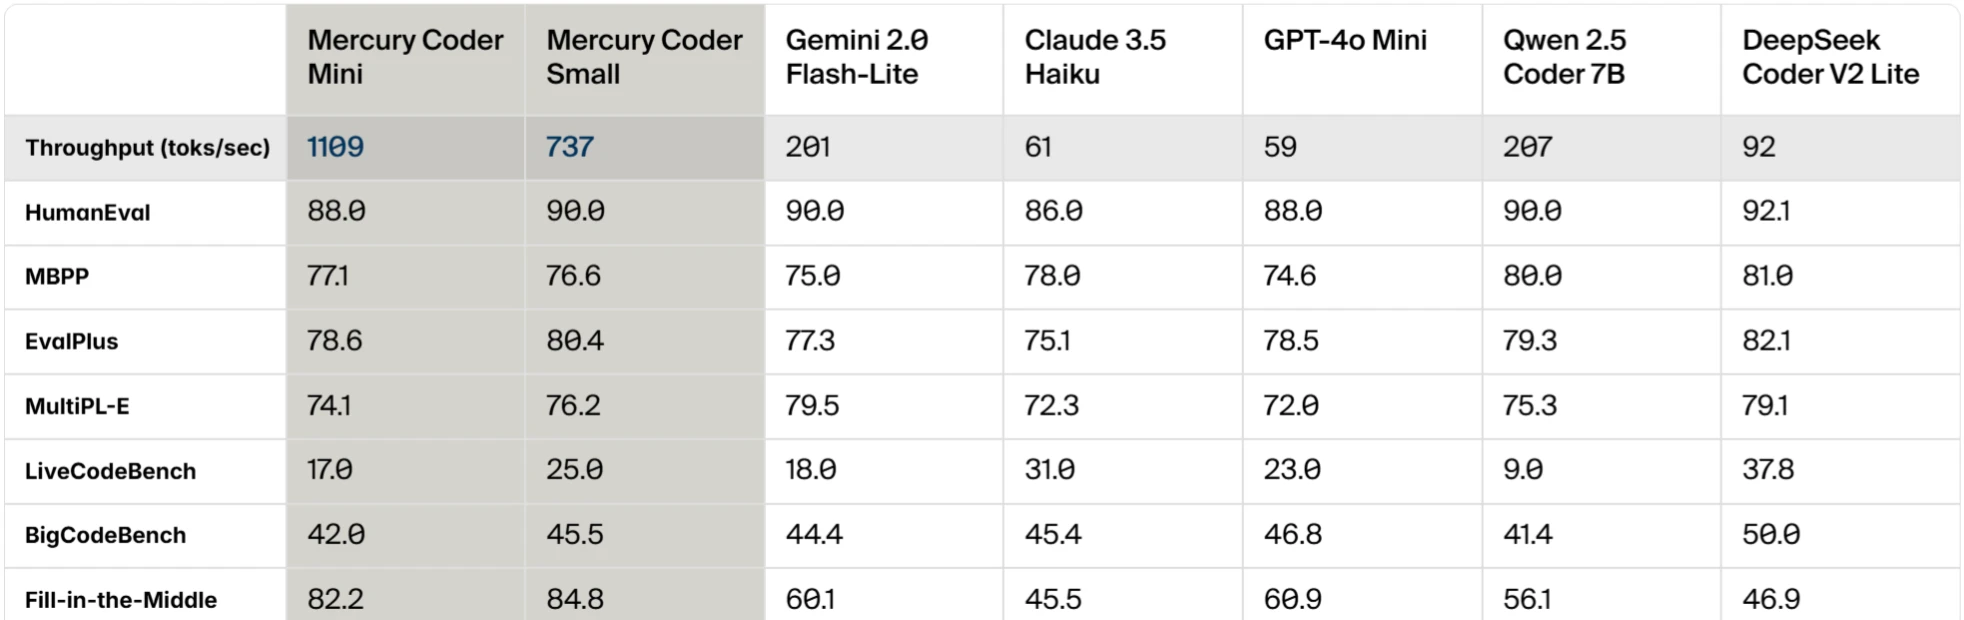
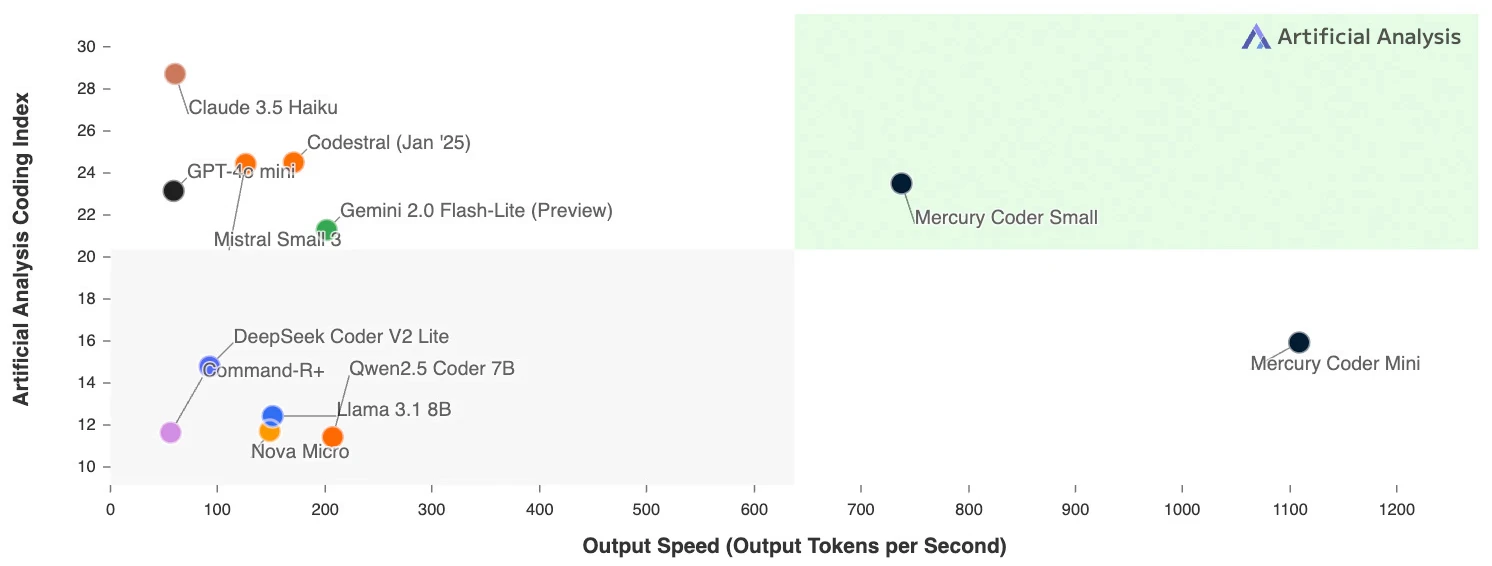
Mercury est le premier modèle de langage large à diffusion (dLLM) de niveau commercial lancé par la startup Inception Labs. Dans le benchmark Copilot Arena, Mercury Coder a surpassé en vitesse plusieurs modèles existants, notamment GPT-4o Mini et Claude 3.5 Haiku. En utilisation réelle, Mercury Coder est capable de générer du code de haute qualité à une vitesse extrêmement rapide.
Principe technique
Modèle de diffusion : Mercury adopte la technologie des modèles de diffusion. Contrairement aux modèles autorégressifs traditionnels, il génère du texte de manière « du grossier au fin », en partant d'un bruit pur et en produisant progressivement un texte significatif via plusieurs étapes de débruitage.
Génération parallèle : En exploitant le mécanisme de génération parallèle des GPU, Mercury peut modifier plusieurs tokens simultanément lors de la génération de texte, améliorant ainsi de manière significative la vitesse et l'efficacité de génération.
Innovations
Avantage de vitesse : Mercury peut fonctionner à plus de 1000 tokens par seconde sur NVIDIA H100, soit 5 à 10 fois plus rapide que les LLM existants optimisés pour la vitesse.
Rentabilité : Grâce à une nouvelle méthode de génération de langage, Mercury réduit les coûts d'inférence d'un facteur 10, tout en maintenant des performances comparables à celles des modèles de pointe.
Capacité de correction d'erreurs : Les caractéristiques du modèle de diffusion permettent à Mercury d'améliorer continuellement ses sorties pendant la génération, en corrigeant les erreurs et les hallucinations.
Fonctionnalités de Mercury
Technologie de modèle de diffusion : Mercury adopte un modèle de diffusion qui, par un processus de génération « du grossier au fin », part d'un bruit pur pour produire progressivement un texte significatif.
Génération parallèle : Grâce au mécanisme de génération parallèle des GPU, Mercury peut modifier plusieurs tokens en même temps lors de la génération de texte, améliorant considérablement la vitesse et l'efficacité.
Avantage de vitesse : Il peut fonctionner à plus de 1000 tokens par seconde sur NVIDIA H100, soit 5 à 10 fois plus rapide que les LLM existants optimisés pour la vitesse.
Rentabilité : Grâce à une nouvelle méthode de génération de langage, Mercury réduit les coûts d'inférence d'un facteur 10, tout en maintenant des performances comparables à celles des modèles de pointe.
Capacité de correction d'erreurs : Les caractéristiques du modèle de diffusion permettent à Mercury d'améliorer continuellement ses sorties pendant la génération, en corrigeant les erreurs et les hallucinations.
Applications de Mercury
Programmation et génération de code : Mercury Coder est spécialement optimisé pour la génération de code et obtient d'excellents résultats sur les benchmarks de codage standard, avec une vitesse plus de 10 fois supérieure à celle des modèles traditionnels.
Applications d'agents : La grande vitesse et l'efficacité de Mercury lui permettent d'exceller dans les applications nécessitant une planification importante et des générations longues, telles que le service client intelligent et les assistants de code.
Applications en périphérie : Grâce à son efficacité, Mercury performs également très bien dans les environnements aux ressources limitées, comme les applications sur smartphones ou ordinateurs portables.
Raisonnement avancé : Mercury peut exploiter la correction d'erreurs pour réparer les hallucinations et améliorer la qualité des réponses, ce qui le rend adapté aux tâches nécessitant un raisonnement approfondi.
Génération contrôlée : Mercury peut éditer ses sorties et générer des mots dans un ordre arbitraire, ce qui convient aux scénarios nécessitant une génération de contenu flexible.
Comment utiliser Mercury ?
Installation et configuration :Mercury Coder est déjà disponible et peut être essayé publiquement. Les utilisateurs peuvent découvrir ses fonctionnalités via le playground fourni par Inception Labs, ou via des API et des services de déploiement interne pour des applications de niveau entreprise.
Expérience et test :Les utilisateurs peuvent découvrir la puissance de Mercury Coder sur le site officiel d'Inception Labs, en saisissant leurs besoins en code pour générer instantanément du code de haute qualité.
Expérience en ligne :https://chat.inceptionlabs.ai/
Présentation officielle :https://www.inceptionlabs.ai/news









