
 Assistant scénario▸
 Apps AI
 Actualités AI
olmOCR : puissant outil OCR open-source pour une conversion haute précision des PDF et documents
小编 ·

olmOCR : puissant outil OCR open-source pour une conversion haute précision des PDF et documents
Qu'est-ce qu'OLMOCR ?
OLMOCR est un outil open source capable de convertir des fichiers PDF en texte avec une grande précision. La conversion préserve l'ordre de lecture du document et prend en charge la reconnaissance des tableaux, des équations et du contenu manuscrit, tout en offrant une capacité de traitement de documents à haut débit, une conversion de texte conservant l'ordre de lecture naturel et une grande précision réduisant les hallucinations.
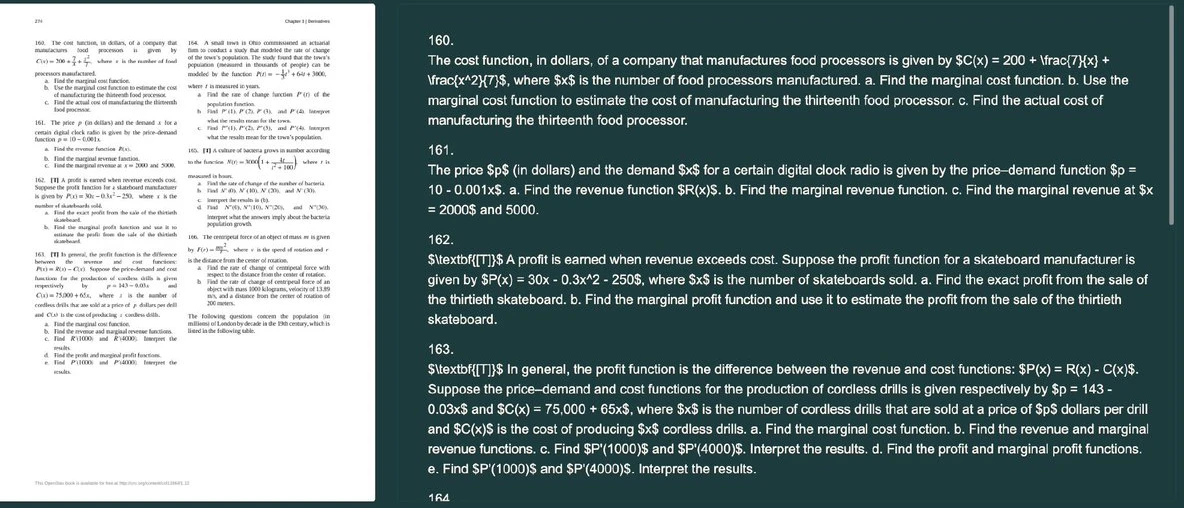
Fonctionnalités et caractéristiques d'olmOCR
Haute précision : OLMOCR fournit une technologie OCR avancée, garantissant la préservation maximale de l'exactitude du contenu pendant la conversion.
Prise en charge de plusieurs formats : cet outil peut traiter différents types de PDF, y compris des documents contenant des formats complexes.
Kit de développement : outre les fonctionnalités OCR de base, OLMOCR inclut également une suite d'outils permettant de linéariser les PDF, facilitant ainsi la génération de jeux de données adaptés à l'entraînement des modèles linguistiques d'IA.
Cas d'utilisation d'olmOCR
Peut être utilisé pour numériser des images de documents papier en texte, facilitant ainsi la gestion documentaire.
Les fonctionnalités intégrées permettent d'extraire des données clés, telles que le contenu des tableaux, pour une analyse et une utilisation ultérieures.
Convient aux entreprises et aux institutions de recherche nécessitant un traitement de documents à grande échelle.
Peut être utilisé dans le domaine de l'éducation pour convertir les supports d'examens et les notes manuscrites au format numérique.
Le secteur médical peut utiliser cet outil pour traiter les dossiers médicaux et les formulaires numérisés.
Le domaine juridique peut l'utiliser pour gérer et rechercher efficacement les documents juridiques.
Adapté aux projets de recherche historique nécessitant la numérisation et l'archivage de documents papier.
Avantages d'olmOCR
Reconnaissance haute précision : capacité à reconnaître des structures complexes (telles que tableaux, équations, etc.).
Rentable : coût de conversion de seulement 190 dollars par million de pages PDF.
Capacité de traitement à grande échelle : permet la conversion par lots de fichiers à grande échelle.
Compatible avec divers matériels : peut s'adapter à différentes configurations matérielles.
Composants complets fournis : fournit les poids du modèle, les données et le code d'entraînement, offrant aux utilisateurs une grande flexibilité.
Questions fréquemment posées sur olmOCR
Q : La reconnaissance de texte manuscrit est-elle prise en charge ?
R : Oui, olmOCR peut reconnaître du texte manuscrit.
Q : Y a-t-il une limite pour le traitement par lots ?
R : olmOCR prend en charge le traitement par lots à grande échelle, s'adaptant avec flexibilité à différents environnements matériels.
Q : Une version d'essai gratuite est-elle proposée ?
R : La présentation et tous les composants sont open source et accessibles sur GitHub.
Q : Quel est le temps moyen de traitement d'une page PDF ?
R : Le temps exact dépend de la configuration matérielle, mais le coût global de fonctionnement est très faible.
Q : Quelles langues sont prises en charge ?
R : olmOCR prend en charge plusieurs langues, y compris les contenus à structures complexes.
Démonstration en ligne :accédez à olmocr.allenai.org
Dépôt GitHub :https://github.com/allenai/olmocr









