
 Assistant scénario▸
 Apps AI
 Actualités AI
Le guide ultime d'entraînement des LLM : entraîner de grands modèles de langage sur des clusters GPU massifs (édition chinoise)
小编 ·

Le guide ultime d'entraînement des LLM : entraîner de grands modèles de langage sur des clusters GPU massifs (édition chinoise)
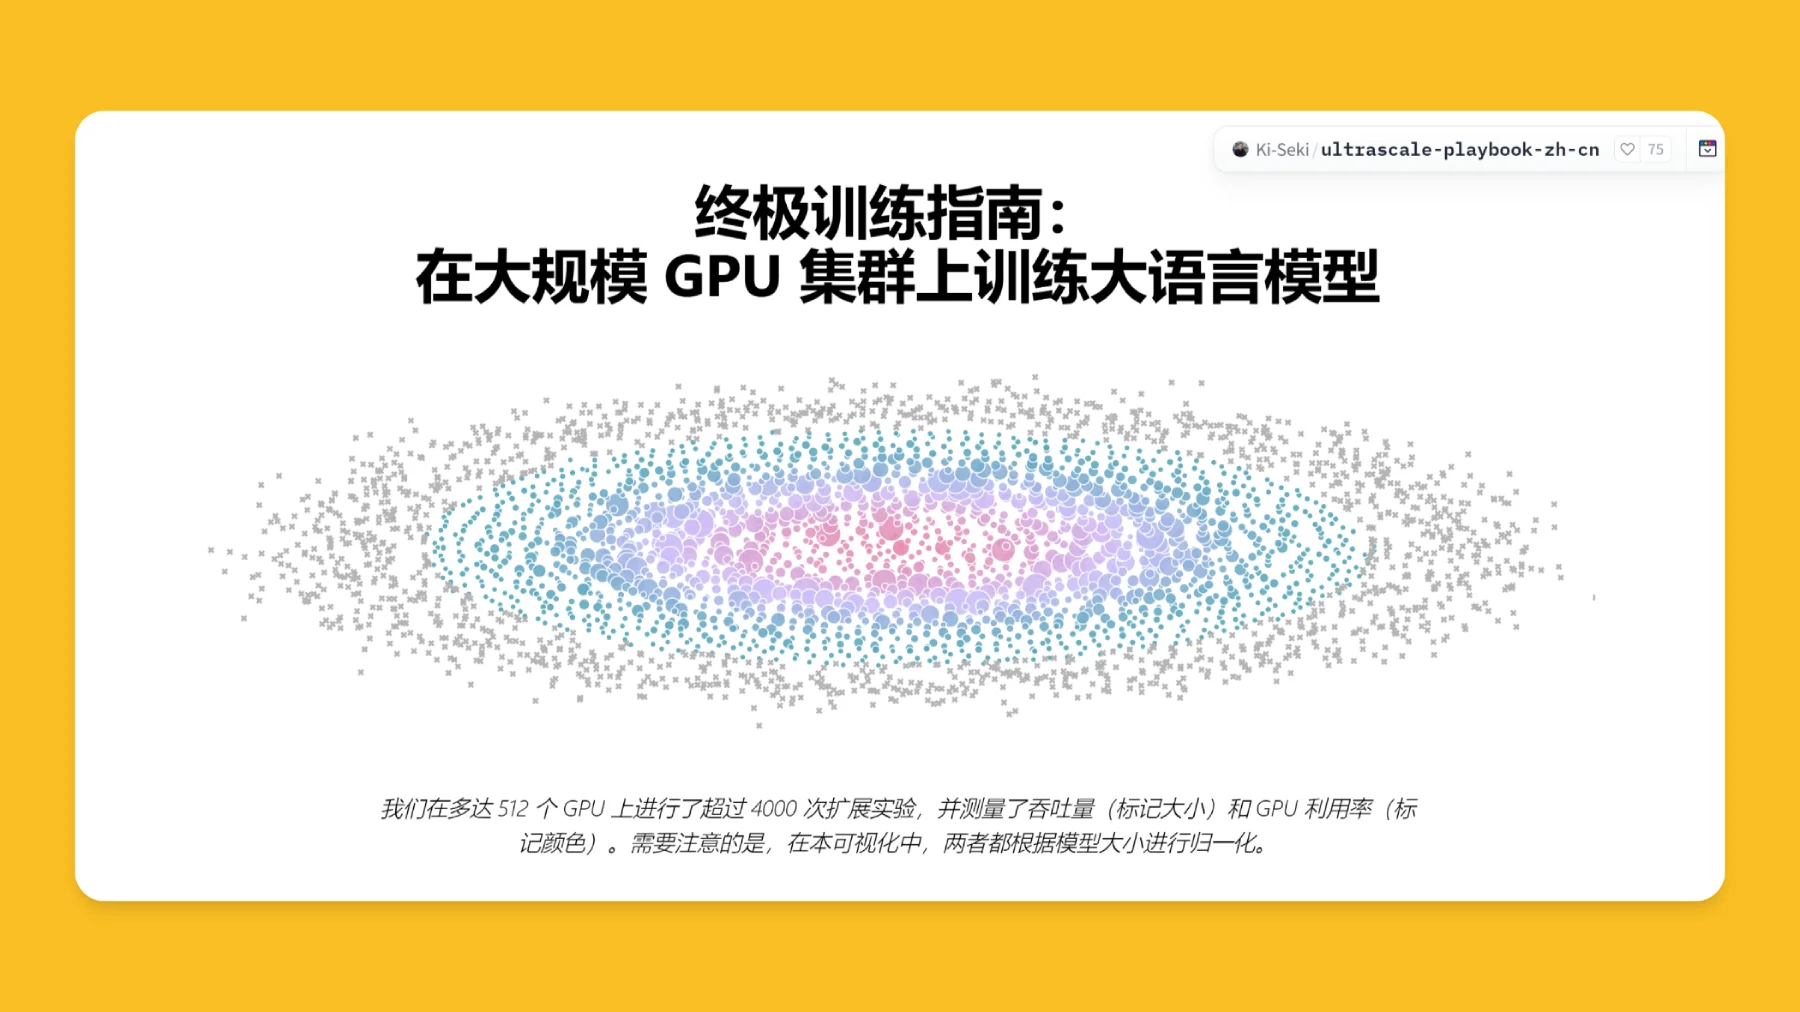
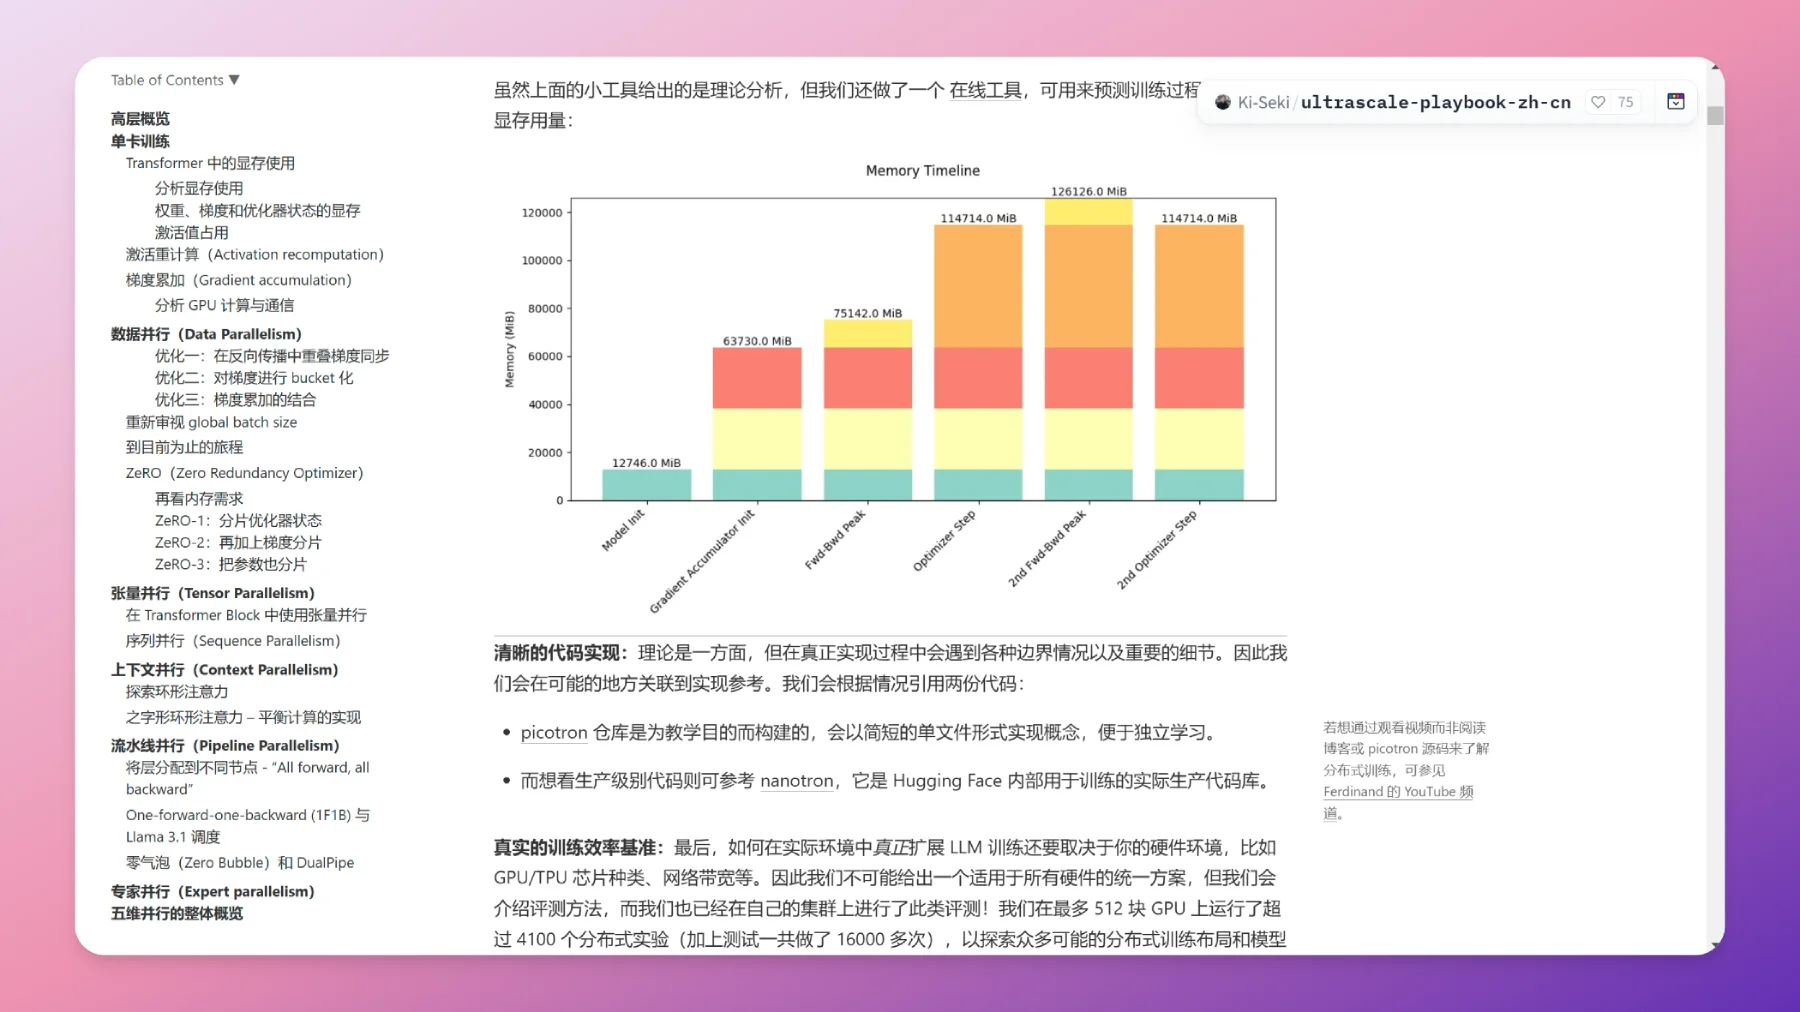
Hugging Face a publié le guide Ultra-Scale Playbook, dont le titre en chinois est LLM终极训练指南:在大规模GPU集群上训练ai大语言模型 (Guide ultime d'entraînement des LLM : entraîner des grands modèles de langage sur des clusters GPU à grande échelle). Il part des bases pour orienter les utilisateurs sur la mise à l'échelle de l'entraînement des grands modèles de langage (LLM) sur des clusters GPU à grande échelle. Ce guide offre des conseils complets pour l'entraînement sur des clusters allant de 1 à plus de 1000 GPU, et présente également les résultats d'expériences de mise à l'échelle sur jusqu'à 512 GPU, avec une analyse détaillée du débit et du taux d'utilisation des GPU.
Texte original : The Ultra-Scale Playbook: Training LLMs on GPU Clusters
Outils de traduction :o1, o3-mini
Relecteur : @Ki_Seki_here
URL de la version chinoise du LLM终极训练指南 :https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
Relecture toujours en cours...
Origines de la recherche
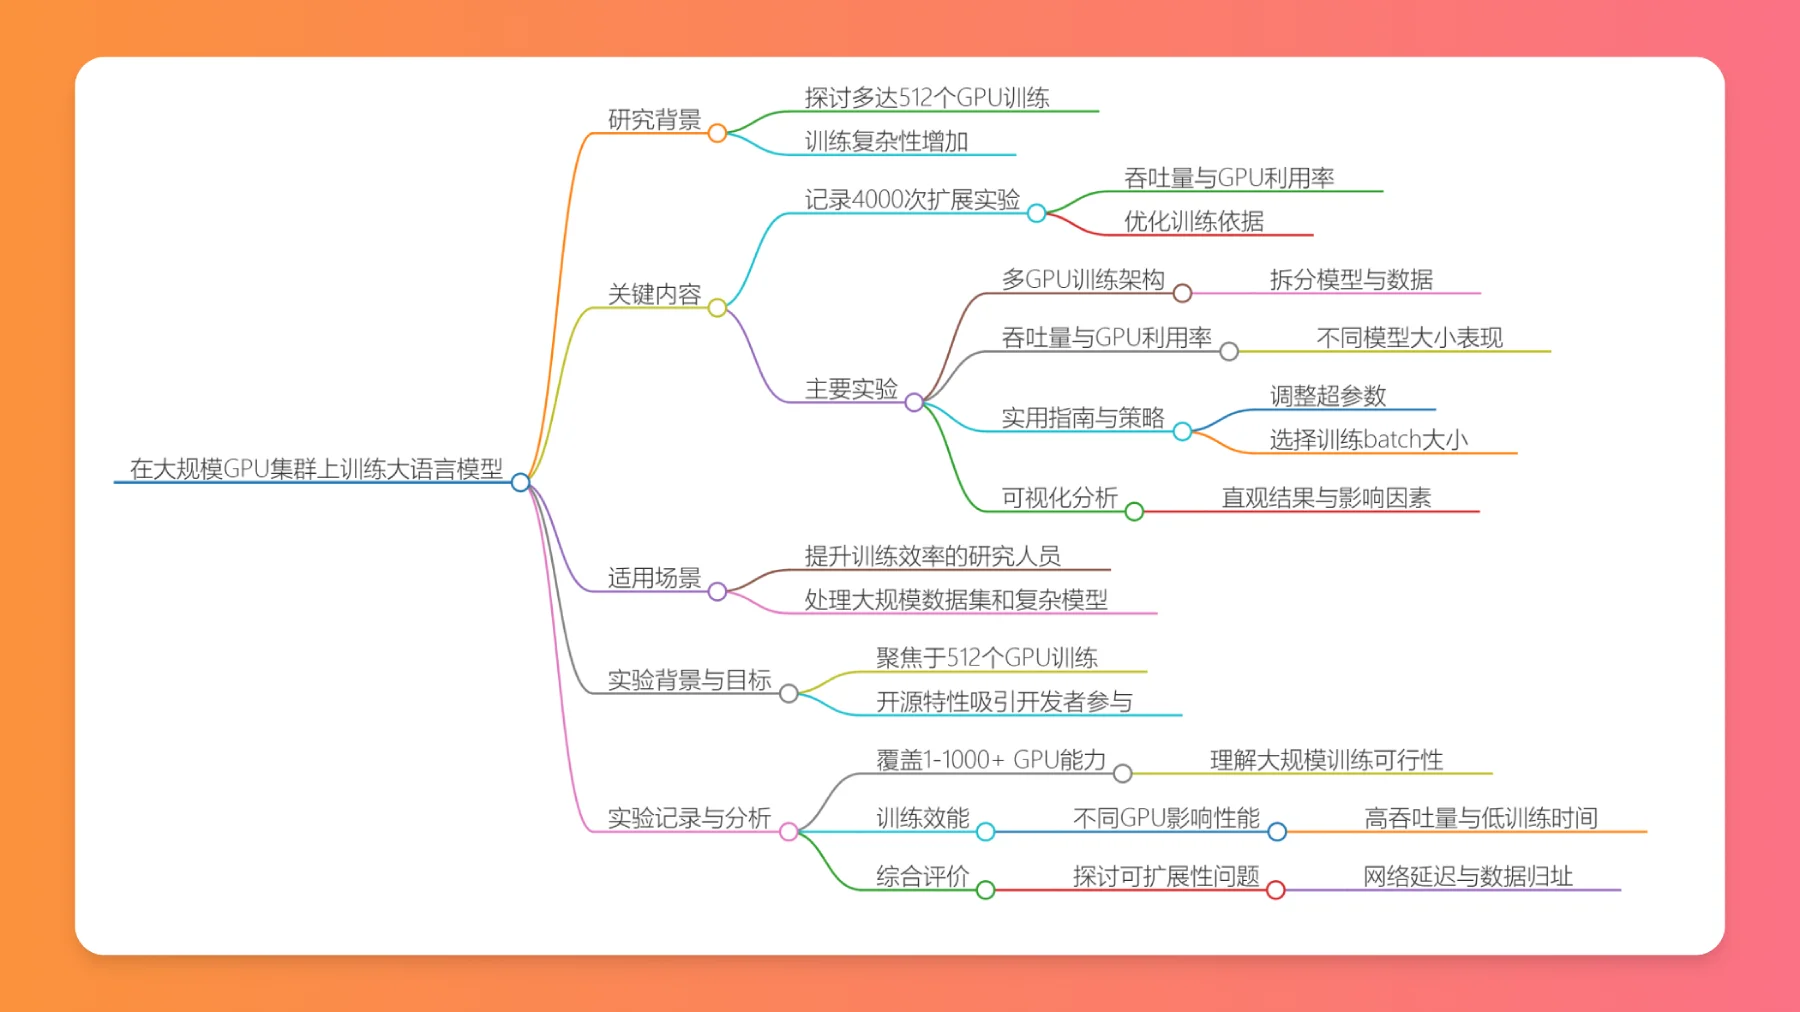
À mesure que l'échelle des modèles de langage ne cesse de croître, la demande en ressources de calcul pour l'entraînement augmente et les stratégies deviennent de plus en plus complexes. C'est pourquoi ce document se concentre principalement sur la manière de mener un entraînement de grands modèles de langage (LLM) à grande échelle sur des clusters pouvant aller jusqu'à 512 GPU.
Contenu principal
Nombreux enregistrements expérimentaux
Le document consigne en détail 4000 expériences de mise à l'échelle. Dans ces expériences, le débit (taille des tokens) et le taux d'utilisation des GPU (couleur des tokens) constituent les indicateurs principaux. Ces données offrent un soutien fiable pour l'optimisation du processus d'entraînement.
Principaux contenus expérimentaux
Architecture d'entraînement multi-GPU : l'architecture adoptée permet de répartir efficacement les modèles et les données, afin que plusieurs GPU puissent traiter en parallèle les tâches associées, ce qui fournit une base architecturale pour un entraînement efficace.
Débit et taux d'utilisation des GPU : grâce à l'analyse effective des données expérimentales, les performances varient selon la taille des modèles. Cette analyse aide les développeurs à comprendre comment exploiter au mieux les ressources, afin de trouver la méthode d'entraînement qui leur convient.
Stratégies et conseils pratiques
Visualisation et analyse : le document contient de nombreux résultats visuels. Ces résultats permettent aux utilisateurs de comprendre intuitivement les résultats des expériences de mise à l'échelle ainsi que les facteurs sous-jacents, rendant ainsi facile l'interprétation de résultats expérimentaux complexes.
Stratégies et conseils pratiques
Le document résume des stratégies d'entraînement pratiques, telles que la façon d'ajuster les hyperparamètres et de choisir une taille de lot d'entraînement appropriée, qui sont tous des facteurs importants pour atteindre les meilleures performances.
Public concerné
Ce guide est particulièrement adapté aux chercheurs et ingénieurs qui souhaitent améliorer l'efficacité de l'entraînement des grands modèles de langage, notamment lorsqu'ils traitent des jeux de données volumineux et des modèles complexes.
Considérations relatives aux expérimentations
Caractéristiques et objectifs du document
Ce document ne se contente pas d'expliquer comment entraîner sur 512 GPU, il met également l'accent sur sa nature open source. Cela permet à un plus grand nombre de développeurs de participer et d'utiliser ces méthodes d'entraînement.
Étendue des enregistrements expérimentaux
Les enregistrements expérimentaux couvrent des capacités de mise à l'échelle allant de 1 GPU à plus de 1000 GPU. Cela constitue un cadre complet, qui aide à comprendre s'il est possible et efficace d'entraîner des LLM sur des clusters à grande échelle.
Analyse de l'efficacité de l'entraînement
En observant l'impact de différents nombres de GPU sur les performances d'entraînement, les auteurs ont constaté que certains modèles peuvent obtenir un débit plus élevé et un temps d'entraînement plus court au cours du processus de mise à l'échelle. Cette découverte peut fournir aux développeurs des recommandations plus ciblées lors du choix du nombre et de la configuration des GPU.
Facteurs de considération globaux
Outre l'attention portée aux indicateurs de performance, cette expérimentation explore également en profondeur les problèmes de scalabilité dans des applications concrètes. Elle étudie également certains défis pouvant être rencontrés dans des environnements réels, tels que la latence réseau, le placement des données et d'autres facteurs complexes, qui ne sauraient être négligés lors d'entraînements à grande échelle.









