
 Assistant scénario▸
 Apps AI
 Actualités AI
SWE-Lancer : le benchmark open source d'OpenAI pour évaluer les capacités en ingénierie logicielle
小编 ·

SWE-Lancer : le benchmark open source d'OpenAI pour évaluer les capacités en ingénierie logicielle
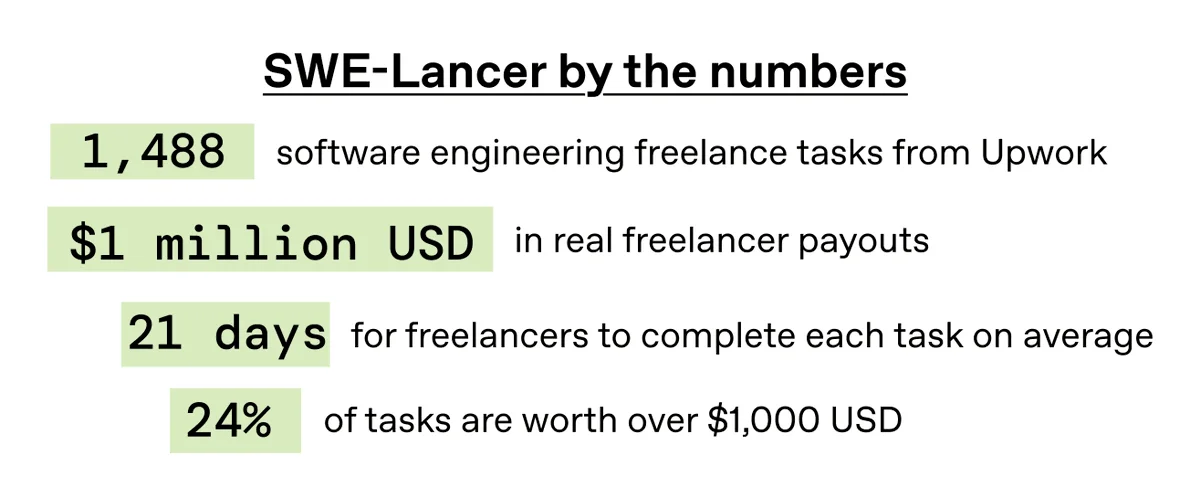
SWE-Lancer est un benchmark lancé par Openai, principalement utilisé pour évaluer les performances des modèles dans la gestion de tâches d'ingénierie logicielle open source. Ce benchmark rassemble plus de 1400 tâches provenant d'Upwork, représentant une valeur totale d'environ 1 million de dollars. SWE-Lancer se concentre sur l'évaluation des correctifs de code et des décisions de gestion, en demandant au modèle de choisir la meilleure proposition parmi plusieurs options, simulant ainsi aussi fidèlement que possible les scénarios de travail d'une équipe d'ingénierie.
Dimensions d'évaluation principales :
Diversité des tâches d'évaluation
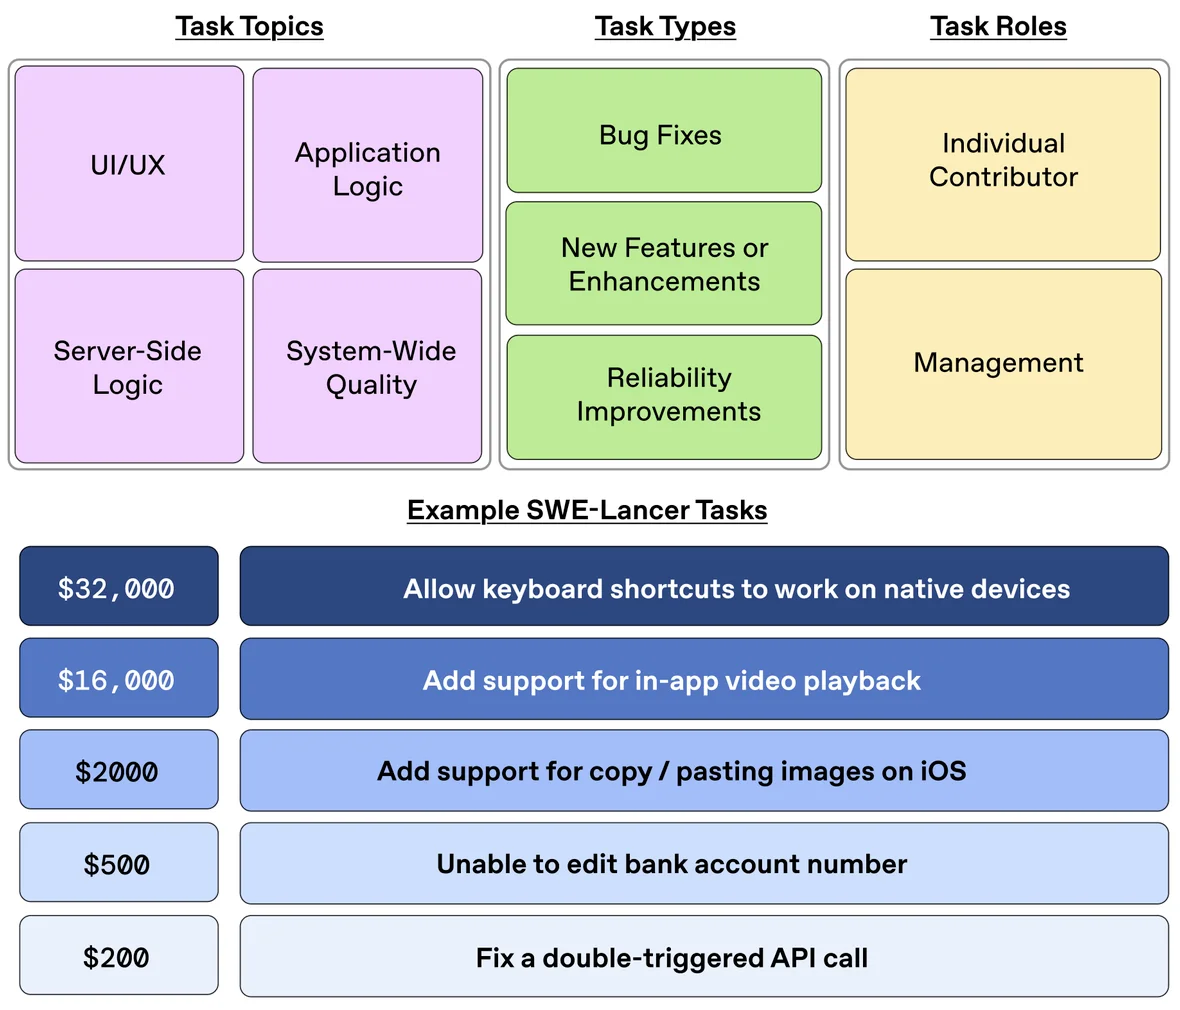
SWE-Lancer couvre une grande variété de types de tâches de développement logiciel, ce qui en fait un outil très efficace pour analyser les capacités des modèles. Il demande au modèle de choisir la meilleure solution parmi plusieurs options proposées, une approche qui permet au benchmark de refléter plus fidèlement les flux de travail réels des équipes d'ingénierie.
Évaluation de la valeur économique
Ce benchmark ne se limite pas à évaluer les capacités techniques, il prend également en compte la valeur économique des tâches. Cette méthode d'évaluation ouvre de nouvelles perspectives pour mesurer l'efficacité des modèles dans les applications du monde réel, permettant aux développeurs de mieux comprendre les avantages économiques potentiels que les modèles d'IA peuvent apporter.
Caractéristiques fonctionnelles de SWE-Lancer :
Tâches du monde réel : SWE-Lancer comprend une série de tâches réelles de développement logiciel, allant de la correction de bugs mineurs à la mise en œuvre de fonctionnalités à grande échelle, ce qui garantit une évaluation efficace des modèles dans des scénarios de développement concrets.
Tests de bout en bout : Contrairement aux tests unitaires traditionnels, SWE-Lancer adopte une approche de test de bout en bout, exigeant que le modèle soit capable de traiter des problèmes complets, se rapprochant ainsi davantage du processus de décision d'un ingénieur logiciel dans son travail réel.
Évaluation à choix multiples : Le modèle doit choisir la meilleure proposition parmi plusieurs solutions possibles, ce qui simule le processus de décision d'une équipe d'ingénierie face à un problème.
Mappage de la valeur économique : La valeur totale des tâches s'élève à 1 million de dollars, ce qui reflète d'une part la complexité et l'importance des tâches, et d'autre part l'impact économique potentiel que les performances des modèles peuvent générer.
Applications de SWE-Lancer :
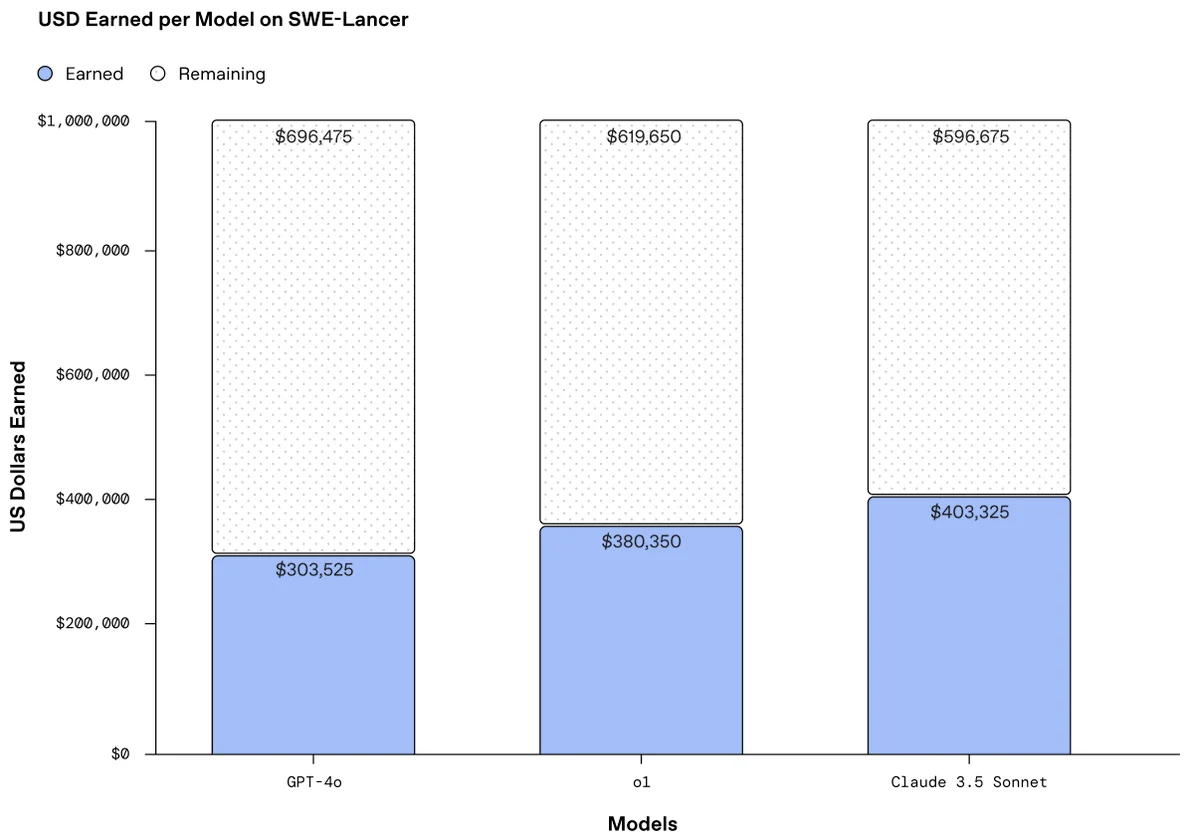
Évaluation des performances des modèles : Fournit aux chercheurs et aux développeurs une plateforme de test pour évaluer et comparer les performances des grands modèles de langage sur des tâches d'ingénierie logicielle.
Assistance au développement logiciel : À long terme, SWE-Lancer pourrait aider à optimiser l'application de l'intelligence artificielle dans le développement logiciel, par exemple la révision automatique de code, les suggestions de correction d'erreurs, etc.
Éducation et formation : Peut servir d'outil pédagogique pour aider les étudiants et les développeurs à comprendre les meilleures pratiques et les défis de l'ingénierie logicielle.
Norme sectorielle : A le potentiel de devenir une norme sectorielle pour évaluer l'utilité de l'IA dans le domaine de l'ingénierie logicielle.
Comment utiliser SWE-Lancer :
Sélection des tâches : Choisir une ou plusieurs tâches à évaluer dans la liste fournie par SWE-Lancer.
Traitement par le modèle : Saisir les tâches sélectionnées dans le modèle d'intelligence artificielle, qui exécutera les tâches en fonction de son entraînement et de ses capacités.
Évaluation des résultats : Évaluer les résultats générés par le modèle pour vérifier s'ils répondent aux critères de qualité prédéfinis et les analyser en fonction de la valeur économique des tâches.
Article :https://arxiv.org/abs/2502.12115
Détails :https://openai.com/index/swe-lancer/









