
 Assistant scénario▸
 Apps AI
 Actualités AI
NSA : la technique de DeepSeek pour accélérer l'entraînement et l'inférence sur des contextes ultra-longs
小编 ·

NSA : la technique de DeepSeek pour accélérer l'entraînement et l'inférence sur des contextes ultra-longs
DeepSeek a lancé le 18 février 2025 un mécanisme d'attention innovant appelé NSA (Native Sparse Attention). NSA est dédié à résoudre les obstacles d'efficacité de calcul et de performance rencontrés lors du traitement de textes longs. Grâce à une conception cohérente avec le matériel et un support d'entraînement natif, cette technologie peut considérablement améliorer la vitesse d'inférence et réduire les coûts de pré-entraînement.
Principales caractéristiques de NSA :
Convivialité matérielle : conçue en tenant compte de la compatibilité avec diverses architectures matérielles, visant à améliorer l'efficacité de l'entraînement.
Capacité d'entraînement local : prend en charge l'entraînement directement sur les données, renforçant l'adaptabilité et la flexibilité du modèle.
Inférence et entraînement efficaces : accélère le traitement de longs contextes, facilite l'application de modèles complexes et gère efficacement des données de séquences plus longues, telles que les textes et les vidéos.
Stratégie de parcimonie hiérarchique dynamique : exploite la sélection fine des tokens et la compression grossière des tokens pour réduire la complexité de calcul tout en préservant l'information.
Réduction des coûts : grâce à une conception optimisée, réduit considérablement la consommation de ressources lors de l'entraînement des modèles d'apprentissage profond, y compris le temps et les coûts de calcul, ce qui est précieux pour les chercheurs et les développeurs.
Composants principaux de NSA :
Stratégie de parcimonie hiérarchique dynamique : combine la compression grossière des tokens et la sélection fine des tokens, améliorant l'efficacité tout en garantissant la perception par le modèle du contexte global et des détails locaux.
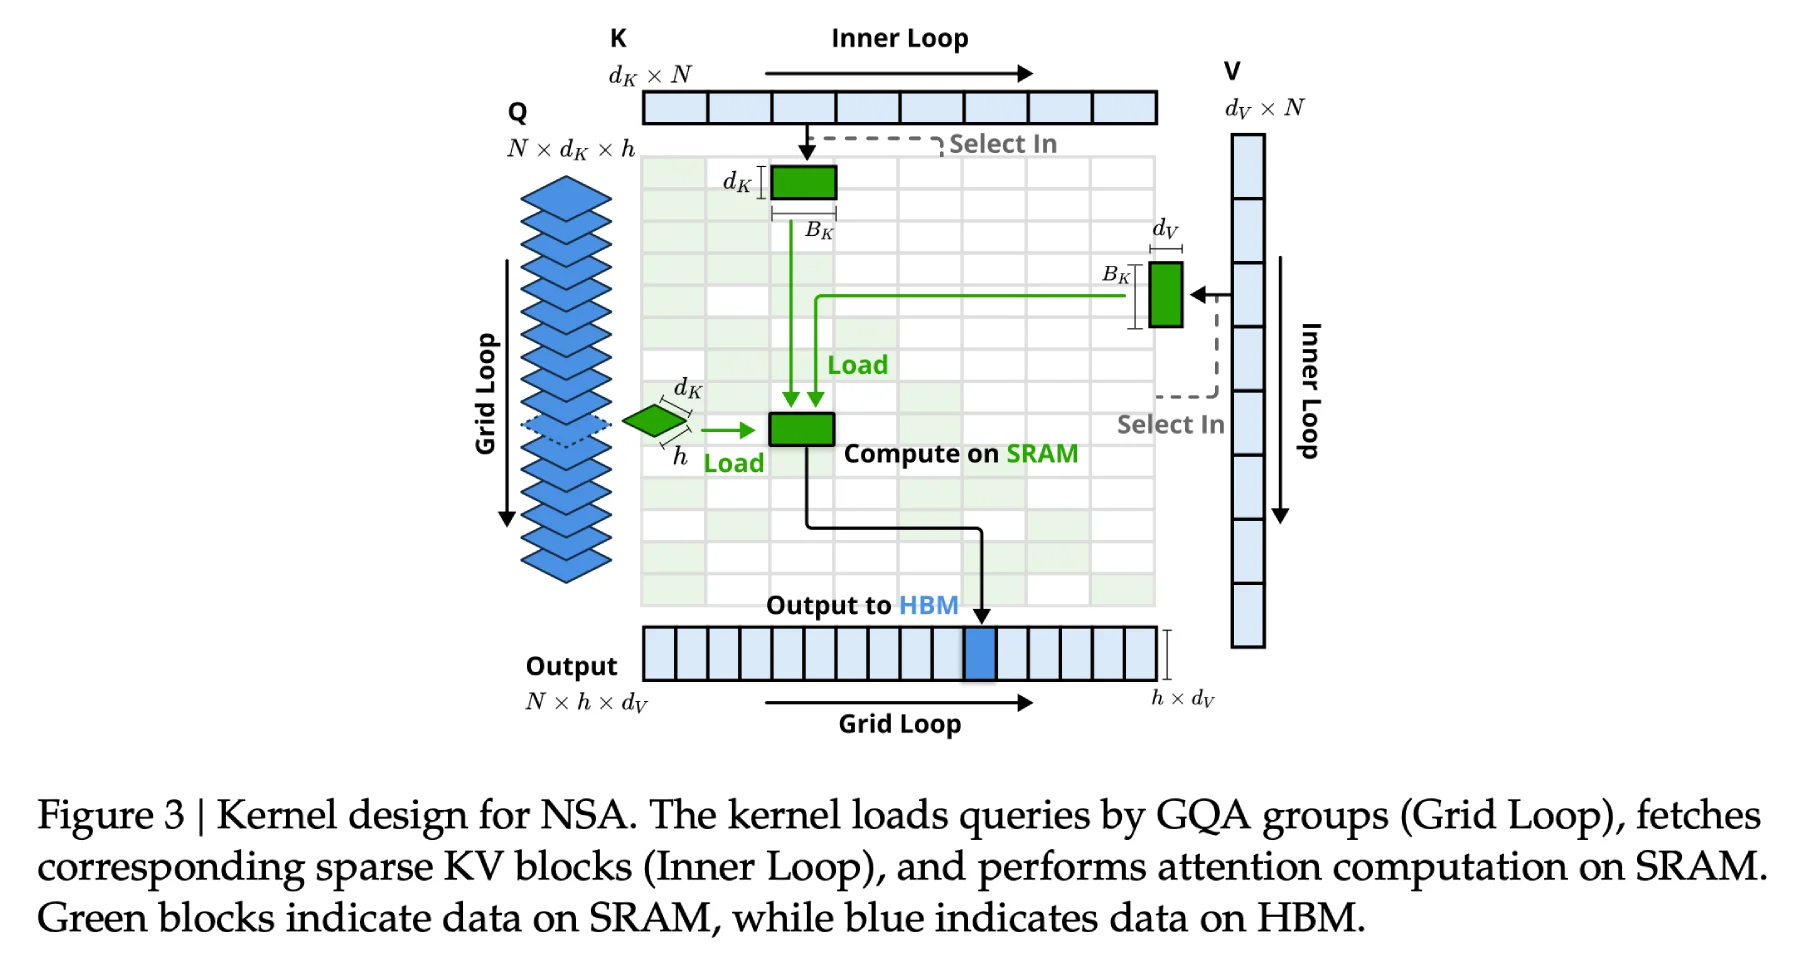
Conception alignée sur le matériel : optimise l'accès à la mémoire, s'adapte aux cœurs tenseurs des GPU, charge les données par blocs, réduit les transferts redondants et améliore l'efficacité du parallélisme.
Entraînable de bout en bout : prend en charge l'intégralité du processus de calcul parcimonieux, de la pré-formation à l'inférence, en maintenant la stabilité de la rétropropagation et en évitant le problème de « retard d'entraînement » des méthodes de parcimonie traditionnelles.
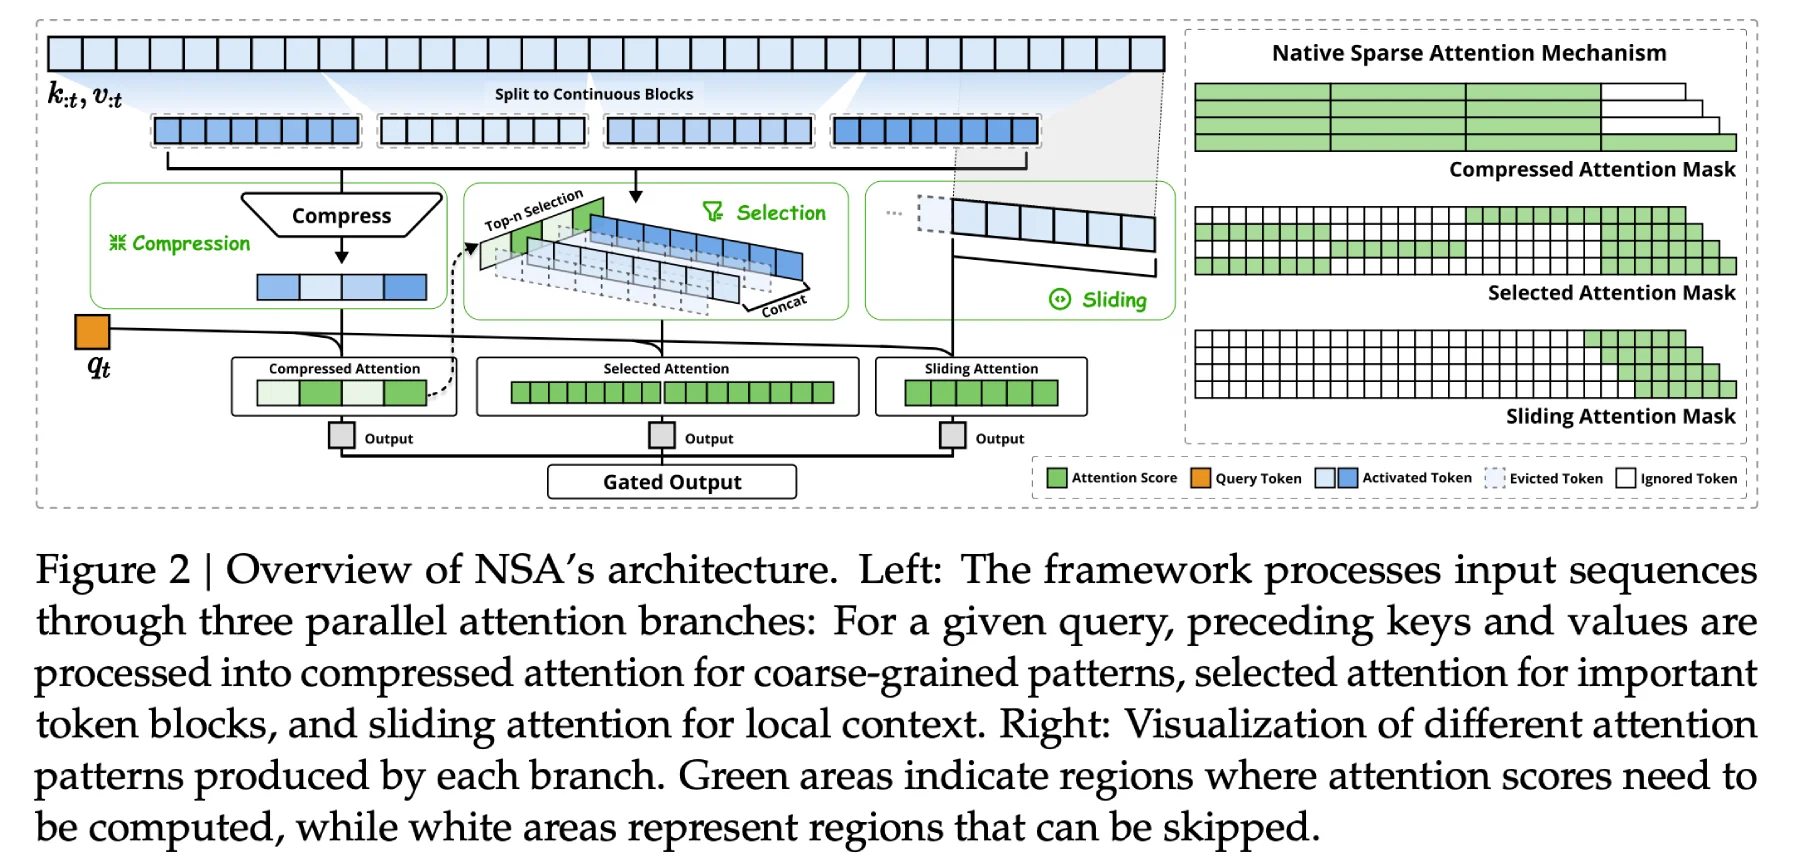
Détails techniques de NSA :
Stratégie de parcimonie hiérarchique dynamique : détermine de manière flexible les informations clés et les informations négligeables, optimise le traitement de l'information et garantit que le modèle capture les sémantiques globales essentielles lors du traitement de longs contextes, tout en allégeant la charge de calcul.
Compression grossière des tokens : en agrégeant les tokens similaires ou non importants, réduit le volume de données à traiter et accélère le calcul, tout en maintenant la compréhension de la sémantique grossière du texte.
Sélection fine des tokens : filtre davantage les tokens importants dans les données compressées, garantissant que le modèle se concentre sur les détails, maintient la précision locale et empêche la perte d'informations importantes.
Fenêtre glissante : utilise un mécanisme de fenêtre glissante pour capturer les informations de contexte local, évitant ainsi d'ignorer les relations de proximité.
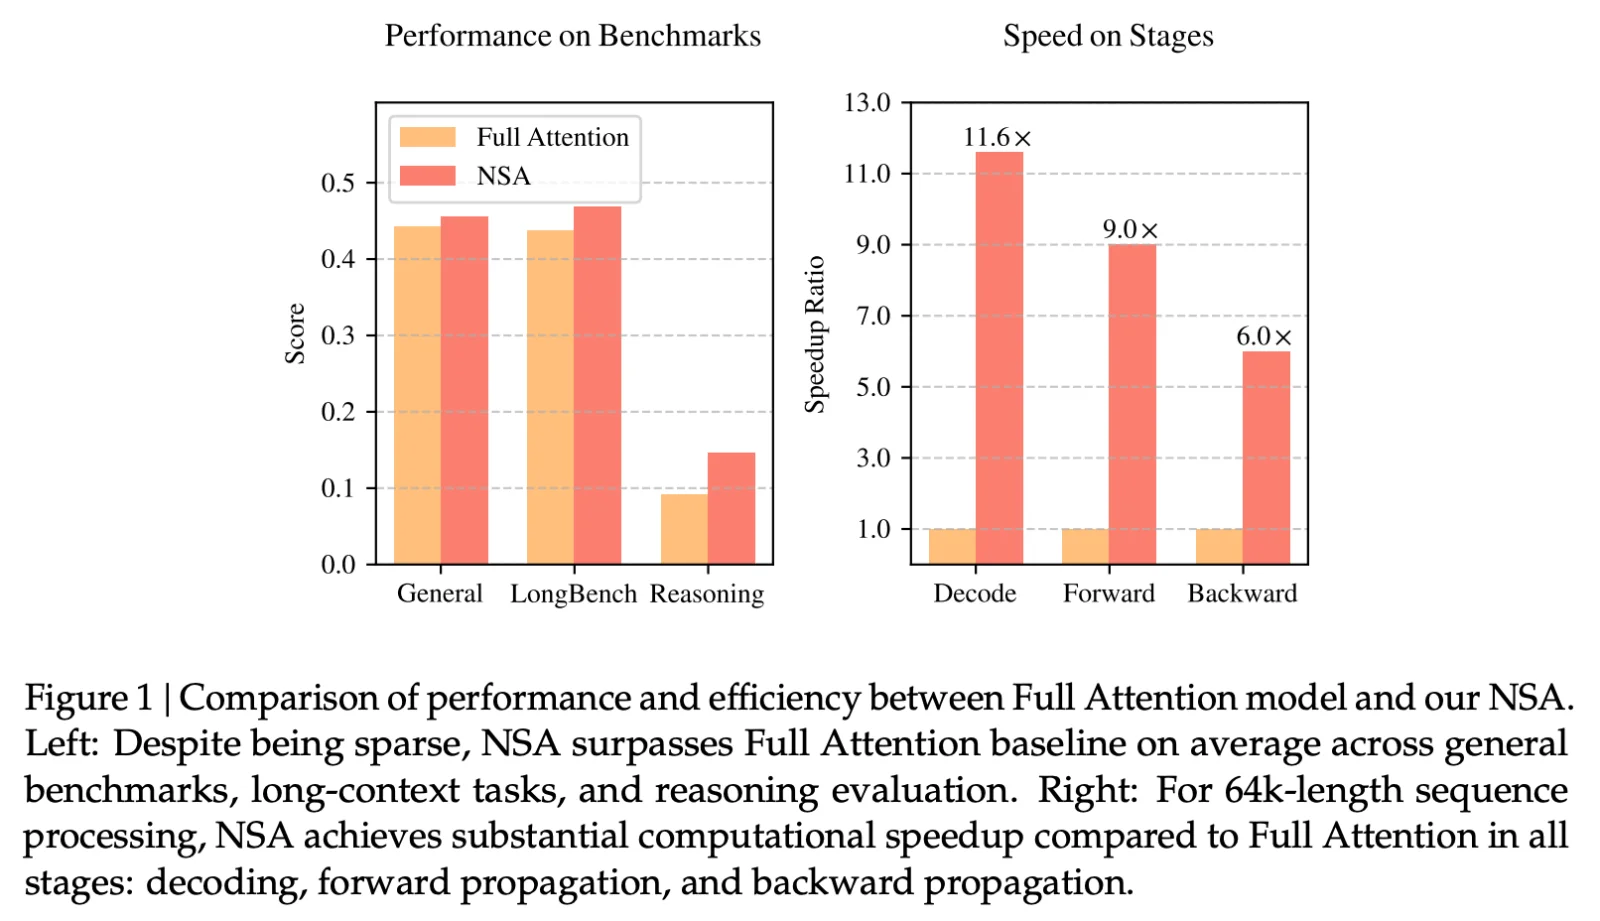
Résultats de performance de NSA :
Accélération : lors du traitement de séquences d'une longueur de 64k, NSA atteint des accélérations significatives dans les phases de décodage, de propagation avant et de rétropropagation, pouvant aller jusqu'à 11,6 fois.
Performances supérieures : sur plusieurs benchmarks, NSA obtient des résultats comparables, voire supérieurs, à ceux des modèles d'attention complète, en particulier dans les tâches à long contexte et le raisonnement d'instructions.
Domaines d'application de NSA :
Assistants intelligents : permet des dialogues multi-tours plus complexes et des services personnalisés.
Calcul scientifique : par exemple, le traitement de données de séquences longues dans la simulation physique et la modélisation en ingénierie.
Génération et débogage de code : compréhension de longs bases de code et génération de solutions de haute qualité.
Article scientifique de NSA :https://arxiv.org/abs/2502.11089
DeepSeek est une entreprise chinoise spécialisée dans l'intelligence artificielle générale, dédiée à l'exploration des technologies de base de l'AGI et à leur mise en produit. DeepSeek a lancé plusieurs grands modèles IA open source haute performance, tels que DeepSeek-V2, qui prend en charge la compréhension de longs textes avec un contexte de 128k, ainsi que DeepSeek-R1-Lite-Preview, qui a obtenu d'excellents résultats lors de l'évaluation chinoise MT-Bench.









