
 Assistant scénario▸
 Apps AI
 Actualités AI
MILS : la méthode de Meta qui donne des capacités multimodales aux LLM sans entraînement
小编 ·

MILS : la méthode de Meta qui donne des capacités multimodales aux LLM sans entraînement
MILS (Meta Interpretive Learning System), un modèle d'ia open source publié par Meta qui permet aux LLM d'acquérir des capacités multimodales sans entraînement. Contrairement aux méthodes d'entraînement traditionnelles, MILS vise à doter les grands modèles de langage (LLM) de la capacité à traiter des tâches visuelles et auditives sans nécessiter d'entraînement spécifique à une tâche supplémentaire. Il peut comprendre les images et les vidéos, interpréter les sons, et apprend en zero-shot.
MILS combine les avantages de l'apprentissage profond et de l'apprentissage interprétatif, et peut obtenir d'excellentes performances dans de nombreuses tâches, en particulier dans des scénarios complexes nécessitant compréhension et raisonnement.
MILS comprend principalement deux modules : un générateur, chargé de produire des solutions candidates, et un évaluateur, utilisé pour évaluer la qualité des solutions candidates générées par le générateur. Grâce à un processus itératif, il résout des tâches multimodales sans entraînement supplémentaire.
Les caractéristiques de MILS incluent la prise en charge de plusieurs langues et entrées multimodales, capable de traiter des données textuelles,图像 et音频. MILS peut être utilisé pour diverses tâches multimodales, telles que la description d'images/vidéos/audios, l'amélioration de la génération d'images, le transfert de style, etc.
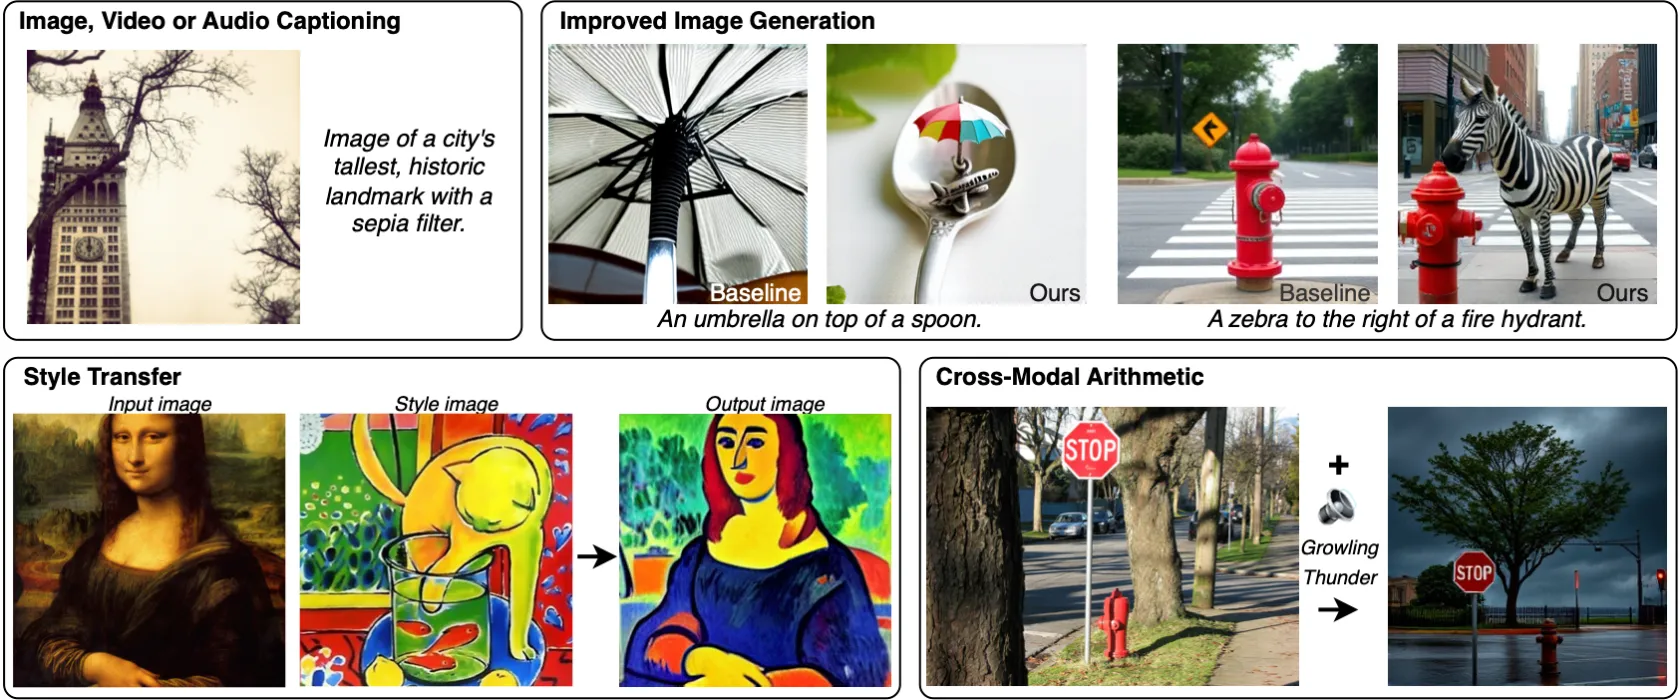
Caractéristiques clés et principe de fonctionnement de MILS
Génération zero-shot : le cœur de MILS réside dans sa capacité d'apprentissage zero-shot, ce qui signifie que le modèle peut résoudre des problèmes multimodaux sans avoir été directement entraîné pour des tâches modales spécifiques. Grâce à un mécanisme de rétroaction itératif, il améliore progressivement les sorties générées pour atteindre une description ou une génération multimodale de haute qualité.
Boucle de rétroaction itérative : lors du processus de génération, MILS demande d'abord au modèle de langage de produire une sortie multimodale initiale (comme une description d'image) basée sur une invite textuelle. Ensuite, cette sortie est utilisée comme entrée, et le modèle tente à nouveau de générer ou d'optimiser. Grâce à une auto-rétroaction et des corrections continues, une solution satisfaisante est finalement atteinte.
Exploitation du potentiel des modèles pré-entraînés : MILS s'appuie sur les connaissances pré-entraînées des grands modèles de langage, qui ont déjà appris une grande quantité de données textuelles, leur permettant ainsi de comprendre des sémantiques et des contextes complexes. De cette manière, MILS peut exploiter les capacités intrinsèques de ces modèles pour s'étendre à la compréhension et à la génération de données non textuelles telles que les images et les sons.
Article : https://arxiv.org/pdf/2501.18096
Github : https://github.com/facebookresearch/MILS









