
 Assistant scénario▸
 Apps AI
 Actualités AI
Qu'est-ce que la distillation de grands modèles et de quoi parle-t-on avec les accusations de « distillation de modèle » visant DeepSeek ?
小编 ·

Qu'est-ce que la distillation de grands modèles et de quoi parle-t-on avec les accusations de « distillation de modèle » visant DeepSeek ?
DeepSeek est une entreprise émergente d'intelligence artificielle qui a récemment suscité beaucoup d'attention après avoir été accusée d'utiliser la technologie d'Openai pour effectuer une distillation de modèles. OpenAI affirme que DeepSeek pourrait avoir extrait les connaissances de ses modèles par la technique de distillation, afin de développer des produits concurrents.
Qu'est-ce que la distillation (Distillation) des grands modèles ?
La distillation des grands modèles est une technique de compression de modèles qui vise à transférer les connaissances d'un modèle grand et complexe (appelé modèle enseignant) vers un modèle plus petit et plus efficace (appelé modèle étudiant). Ce processus consiste à entraîner le modèle étudiant à imiter les sorties du modèle enseignant, permettant ainsi de réduire la consommation de ressources de calcul tout en maintenant les performances.
Ce concept a été proposé par Hinton et al. en 2015 et est couramment utilisé pour la compression de modèles, l'accélération de l'inférence et la réduction des coûts de déploiement, tout en préservant autant que possible les performances du modèle d'origine. La technique de distillation est largement appliquée en apprentissage profond, notamment dans des domaines tels que le traitement du langage naturel et la vision par ordinateur.
Voici une carte mentale tirée d'une vidéo YouTube de « Jeff 科技视角 » Jeff Li pour mieux comprendre. M. Jeff Li l'explique de manière très détaillée dans l'épisode n° 379 : « La distillation (Distillation) des grands modèles et les accusations contre DeepSeek » (vidéo).
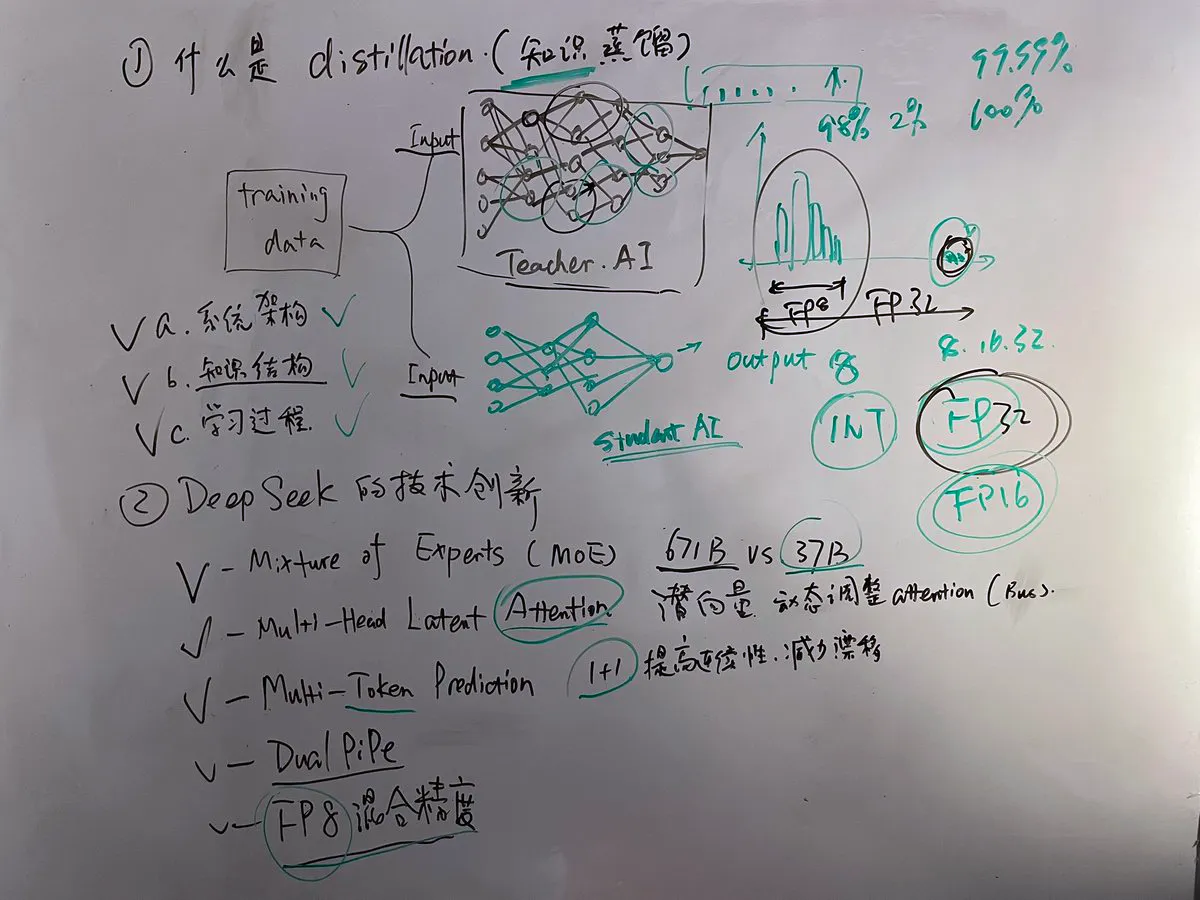
Méthodes de mise en œuvre de la distillation des grands modèles :
Étiquettes souples (Soft Labels) : utiliser les distributions de probabilité générées par le modèle enseignant au lieu des étiquettes dures pour l'entraînement.
Activations cachées (Hidden Activations) : utiliser les sorties de certaines couches intermédiaires du modèle enseignant comme signaux auxiliaires pour le modèle étudiant.
Poids d'attention (Attention Weights) : dans le cas de modèles séquentiels, les informations liées au mécanisme d'attention peuvent également être transférées.
Les accusations de « distillation de modèle » auxquelles DeepSeek fait face
Contexte :
DeepSeek est une entreprise en démarrage qui propose ses propres produits de grands modèles de langage.
Le développement de modèles à faible coût par DeepSeek, ainsi que ses stratégies d'open source et de gratuité, pourraient menacer la position sur le marché d'entreprises telles qu'OpenAI et Anthropic, ce qui a conduit les concurrents à la critiquer, estimant que DeepSeek utilise de manière abusive leurs technologies et leurs données.
Points clés :
La position d'OpenAI
OpenAI accuse DeepSeek d'avoir extrait et utilisé sans autorisation des données pour entraîner ses propres modèles.
Problèmes internes d'OpenAI : OpenAI a elle-même été critiquée pour avoir illégalement extrait des données sur Internet afin d'entraîner ses modèles, notamment des articles protégés par le droit d'auteur. De plus, OpenAI a fait l'objet de poursuites judiciaires de la part d'éditeurs tels que le New York Times pour des comportements similaires.
Le point de vue d'Anthropic
Contestation de la gravité : Anthropic estime que DeepSeek ne représente pas une véritable menace pour ses produits, affirmant que son niveau technologique équivaut à celui de versions datant de quelques mois auparavant.
La position de Microsoft
Microsoft a mis en ligne les modèles DeepSeek sur ses plateformes Azure AI et GitHub, affichant ainsi une certaine forme de soutien, ce qui a également suscité des discussions sur les conflits d'intérêts.
Controverses spécifiques concernant la distillation de modèle
Légitimité et conformité : la distillation de modèle est une pratique technique courante, mais elle est soumise à des règles strictes dans sa mise en œuvre. En particulier, concernant les usages commerciaux et les accords de partage de technologie, chaque entreprise a sa propre lecture et son propre niveau d'application.
Comment définir l'acquisition de données « sans autorisation » ?
Est-il permis d'utiliser les données issues de certaines sorties d'API pour entraîner de nouveaux modèles concurrents ?
Preuves et éléments à l'appui : à l'heure actuelle, aucune des deux parties n'a rendu publiques des preuves détaillées pour étayer ses affirmations, ce qui accroît la complexité et l'incertitude de l'affaire.
Réactions du secteur et opinion publique
Les avis au sein et en dehors de la communauté sont partagés : certains y voient une manifestation de la concurrence sur le marché ; mais de nombreuses personnes s'inquiètent de savoir si l'éthique et les dispositions légales sous-jacentes à cette affaire ont été pleinement respectées.
Les accusations de « distillation de modèle » auxquelles DeepSeek fait face reflètent l'intense concurrence qui règne actuellement dans le secteur de l'IA, ainsi que les défis posés par les zones d'ombre juridiques concernant les droits d'utilisation des données et les limites de l'innovation technologique.









