
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba Qwen dévoile son modèle vision-langage de nouvelle génération : Qwen2.5-VL
小编 ·

Alibaba Qwen dévoile son modèle vision-langage de nouvelle génération : Qwen2.5-VL
Alibaba Qwen2.5-VL est un nouveau modèle de compréhension visuelle lancé par l'équipe Tongyi Qianwen d'Alibaba. Ce modèle possède de puissantes capacités de compréhension visuelle, d'agent, de compréhension de longues vidéos et de capture d'événements, visant à promouvoir l'application et le développement de l'IA dans de nombreux domaines.
Fonctionnalités principales de Qwen2.5-VL
Compréhension visuelle : Qwen2.5-VL est capable d'identifier avec précision les objets courants dans les images, tels que les fleurs, les oiseaux, les poissons et les insectes, et peut analyser le texte, les graphiques, les icônes, les figures et la mise en page présents dans les images. Cela lui permet d'exceller dans le traitement des informations visuelles et de fournir aux utilisateurs des résultats d'analyse d'images détaillés.
Compréhension vidéo : ce modèle prend en charge de manière révolutionnaire la compréhension de vidéos de plus d'une heure, et peut identifier et analyser des événements spécifiques dans les vidéos. Cette fonctionnalité offre à Qwen2.5-VL un avantage significatif dans l'analyse et le traitement de contenu vidéo.
Capacité de raisonnement dynamique : Qwen2.5-VL dispose d'une capacité de raisonnement dynamique, lui permettant de prendre des décisions et d'effectuer des opérations complexes en fonction de l'environnement visuel et des instructions textuelles. Il peut ainsi agir comme un agent intelligent visuel IA, contrôlant directement des appareils tels que des téléphones et des ordinateurs.
Versions multi-tailles : Qwen2.5-VL propose trois modèles de tailles différentes : 3B, 7B et 72B. Les utilisateurs peuvent choisir la version adaptée à leurs besoins afin de répondre à différentes ressources de calcul et scénarios d'application.
Caractéristiques principales
Versions multi-tailles
Trois versions avec différents nombres de paramètres (3B, 7B et 72B) sont proposées, adaptées à différents scénarios d'application et configurations matérielles.
Version 3B : adaptée aux appareils mobiles et autres environnements aux ressources limitées.
Version 7B : un bon équilibre entre performance et consommation de ressources, adaptée à la plupart des scénarios d'application.
Version 72B : la version la plus performante, adaptée aux applications nécessitant une grande précision et des fonctionnalités puissantes.
Fonctionnalités avancées
Capacité de localisation visuelle : permet d'identifier avec précision les objets dans une image et de renvoyer les informations de position sous forme de coordonnées.
Reconnaissance d'images généraliste : peut non seulement identifier des objets courants (comme les fleurs, les oiseaux, les poissons), mais aussi analyser des éléments tels que le texte, les graphiques et les icônes présents dans les images.
Analyse de documents : amélioration significative de la compréhension des documents et des tableaux, avec d'excellentes performances notamment dans la résolution de problèmes académiques, les capacités mathématiques et la vérification de documents.
Compréhension vidéo : prend en charge la compréhension de vidéos de longue durée (pouvant atteindre l'échelle d'une heure), avec une capacité de localisation d'événements à la seconde près, capable de résumer les points clés de la vidéo et d'extraire les informations importantes.
Agent visuel : capable d'exploiter ordinateurs et téléphones sans nécessiter de réglage spécifique pour une tâche donnée, et d'exécuter des tâches complexes de raisonnement et de prise de décision.
Reconnaissance et compréhension de texte : capacités OCR améliorées, prenant en charge la reconnaissance de texte et l'extraction d'informations dans plusieurs scénarios, plusieurs langues et plusieurs orientations.
Améliorations apportées
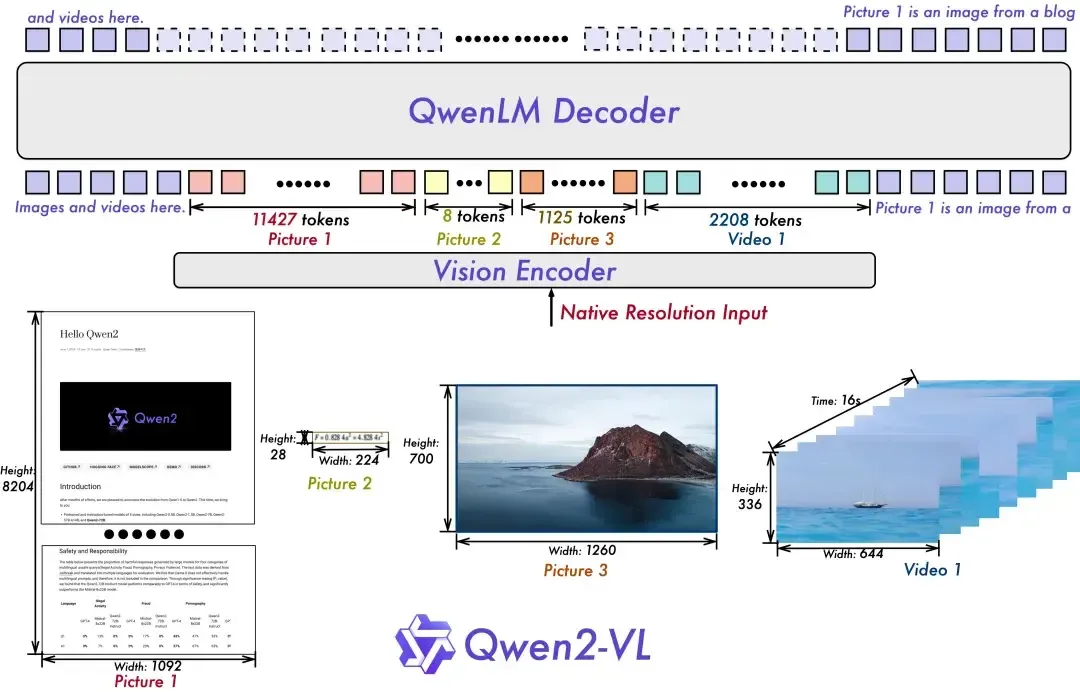
Capacité de perception spatio-temporelle : renforcement de la capacité du modèle à percevoir les échelles temporelles et spatiales, lui permettant de mieux comprendre et traiter différents types de données.
Simplification de l'architecture réseau : introduction d'un mécanisme d'attention par fenêtres, réduisant la charge de calcul et améliorant l'efficacité du modèle.
Résolution dynamique : utilisation d'un ViT à résolution dynamique native, garantissant que le modèle conserve la résolution native tout en réduisant la pression de calcul.
Performances
Leader sur plusieurs benchmarks : le modèle affiche d'excellentes performances sur des benchmarks dans de nombreux domaines, surpassant notamment les modèles concurrents sur plusieurs tâches telles que la compréhension de documents, le问答 visuel (VQA), la compréhension vidéo et l'agent visuel.
Cas concrets :
Compréhension de documents : excellentes performances sur des tâches telles que DocVQA.
Compréhension vidéo : capable de comprendre avec précision des contenus vidéo de plusieurs heures, et de localiser et résumer rapidement les événements importants.
Agent visuel : capable d'exécuter des tâches d'automatisation complexes, telles que le contrôle d'appareils et d'interfaces logicielles, sans aucun ajustement supplémentaire.
Scénarios d'application de Qwen2.5-VL
Service client intelligent : Qwen2.5-VL peut être appliqué aux scénarios de service client vidéo, en analysant en temps réel les images de produits ou les codes-barres présentés par les utilisateurs et en fournissant des informations produit pertinentes.
Secteur financier et commercial : le modèle prend en charge les sorties structurées, adaptées au traitement de données telles que les factures et les formulaires, et convient particulièrement aux applications dans les domaines financier et commercial.
Éducation et formation : dans le domaine de l'éducation, Qwen2.5-VL peut être utilisé pour analyser des vidéos pédagogiques et aider les étudiants à comprendre des concepts et contenus complexes.
Analyse d'imagerie médicale : la capacité de compréhension visuelle du modèle peut également être appliquée à l'analyse d'imagerie médicale, aidant les médecins à mieux interpréter les données d'imagerie.
Le modèle Qwen2.5-VL prolonge l'architecture de la génération précédente Qwen-VL, en adoptant une structure en série ViT (Vision Transformer) + Qwen2, prenant en charge une entrée unifiée d'images et de vidéos. Cette conception permet au modèle de mieux fusionner les informations visuelles et linguistiques, améliorant ainsi la compréhension des données multimodales. De plus, Qwen2.5-VL introduit un codage positionnel rotationnel multimodal (M-ROPE), qui décompose le codage positionnel en trois parties : temporelle et spatiale (hauteur et largeur), renforçant ainsi les capacités de traitement multimodal et de raisonnement du modèle. Le modèle dispose également d'une capacité de reconnaissance d'images à résolution任意, pouvant traiter des images de différentes résolutions et ratios d'aspect, garantissant la cohérence entre l'entrée et les informations de l'image.
Comment obtenir Qwen2.5-VL :
Adresse open source : Hugging Face
Github : Qwen2.5-VL
Expérience en ligne : Qwen Chat









