
 Assistant scénario▸
 Apps AI
 Actualités AI
DeepSeek R1 : modèle de raisonnement open source par DeepSeek, rivalisant avec OpenAI o1
小编 ·

DeepSeek R1 : modèle de raisonnement open source par DeepSeek, rivalisant avec OpenAI o1
Qu'est-ce que DeepSeek R1 ?
DeepSeek R1est un grand modèle de raisonnement open source lancé par l'entreprise chinoise d'intelligence artificielle DeepSeek. Grâce à une approche technique pilotée par l'apprentissage par renforcement, il atteint des performances comparables à la version officielle d'o1 d'Openai sur des tâches complexes telles que les mathématiques, le code et le raisonnement en langage naturel, se distinguant particulièrement sur les tâches de raisonnement. Il utilise une technologie d'apprentissage par renforcement qui améliore considérablement les capacités de raisonnement du modèle et permet un entraînement efficace avec très peu de données annotées. Cette approche confère également à DeepSeek-R1 un avantage en termes de coût, son coût de fonctionnement étant annoncé comme seulement 3 % de celui d'OpenAI.
Technologies clés de DeepSeek R1 :
I. Capacités de raisonnement pilotées par l'apprentissage par renforcement
Entraînement par apprentissage par renforcement pur (RL) : DeepSeek R1-Zero applique directement un apprentissage par renforcement à grande échelle sur le modèle de base, sans nécessiter de fine-tuning supervisé (SFT), validant pour la première fois que le RL pur peut激发 les capacités de raisonnement des LLM. Le modèle utilise l'algorithme GRPO (Group Relative Policy Optimization) pour réduire les coûts d'entraînement, et s'appuie sur un système de récompenses basé sur des règles (récompense d'exactitude et récompense de format) pour guider la génération de chaînes de pensée structurées (CoT).
Optimisation par données de démarrage à froid : pour résoudre les problèmes de lisibilité et de mélange de langues de R1-Zero, DeepSeek R1 introduit une petite quantité de données de démarrage à froid (exemples de CoT longs), et améliore la lisibilité et la généralisation des sorties grâce à un entraînement en plusieurs étapes (fine-tuning de démarrage à froid → RL orienté raisonnement → RL tous scénarios).
Raisonnement à longue chaîne et distillation de modèles
Prise en charge de chaînes de pensée ultra-longues : prend en charge une fenêtre de contexte de 128K et peut décomposer des problèmes complexes en raisonnements en plusieurs étapes, par exemple en générant des processus de dérivation détaillés de plusieurs dizaines de milliers de caractères pour des problèmes mathématiques.
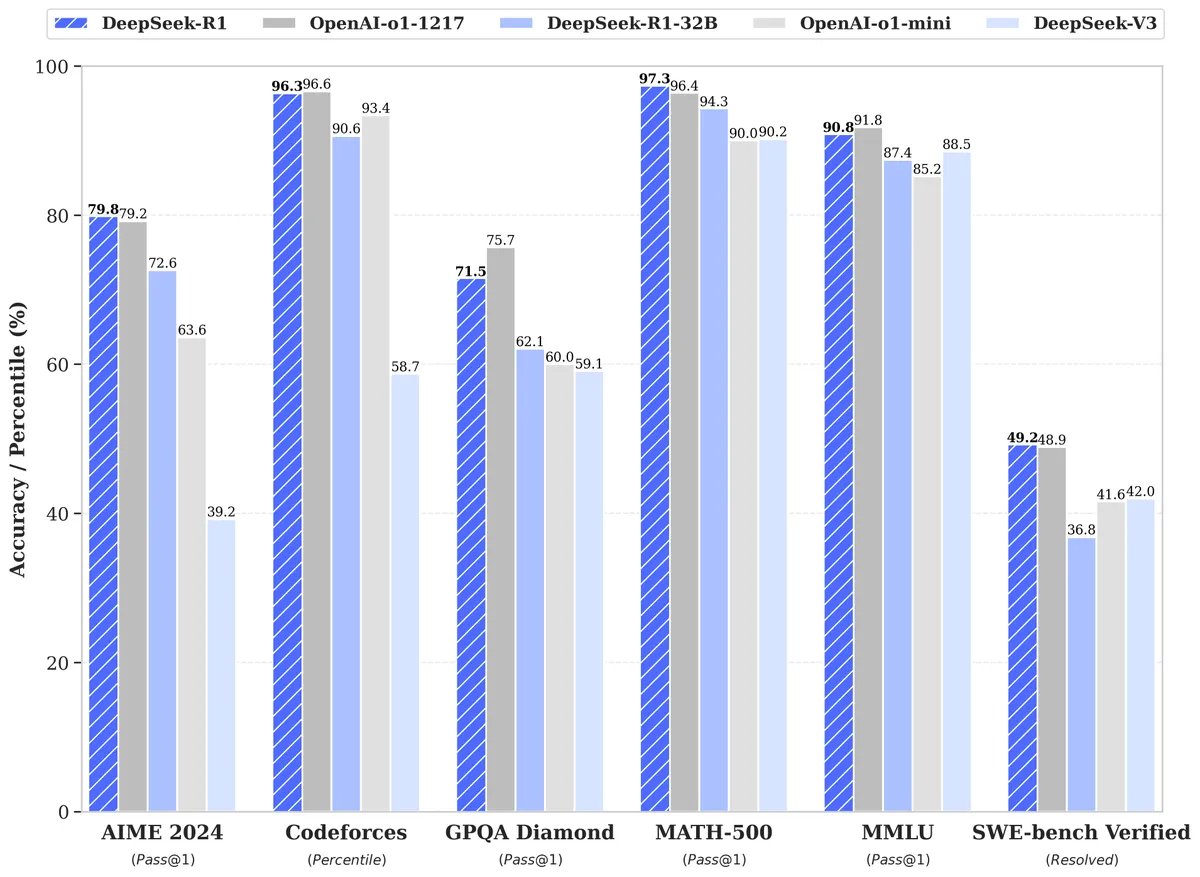
Technique de distillation efficace : les capacités de raisonnement de R1 sont distillées vers les petits modèles des séries Qwen et Llama (tels que 7B, 32B, 70B) à travers 800k échantillons. La version distillée de Qwen-32B atteint un taux de précision pass@1 de 72,6 % au test AIME 2024, une performance proche de celle d'o1-mini.
II. Performances et benchmarks
Capacités en mathématiques et en code
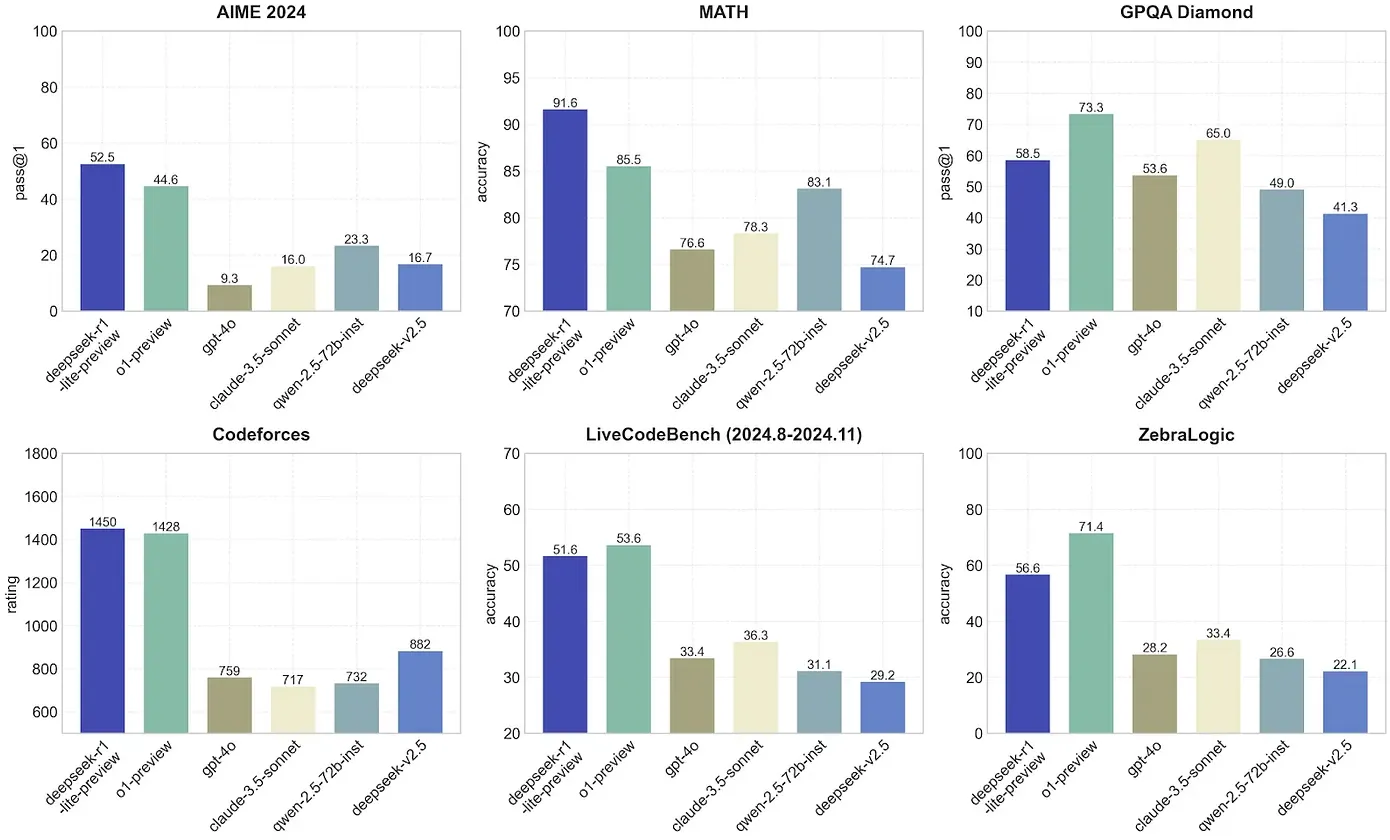
Performances de niveau compétition mathématique : sur l'AIME 2024 (American Invitational Mathematics Examination), R1 atteint un taux de précision pass@1 de 79,8 %, et sur le benchmark MATH-500, il obtient un score de 97,3 %, surpassant OpenAI-o1-1217. Lors d'un test portant sur l'épreuve de mathématiques du gaokao, R1 a résolu le problème en seulement 83 secondes, bien qu'il présente des lacunes dans la normalisation des étapes.
Niveau expert en génération de code : il obtient une note Elo de 2029 au concours Codeforces (surpassant 96,3 % des participants humains) et un pass@1 de 65,9 % au test LiveCodeBench. Des tests utilisateurs montrent que R1 génère du code de visualisation en mécanique quantique en seulement 9 minutes et qu'il est directement exécutable.
Tâches de langage général et de connaissances
Capacités multidisciplinaires : il obtient un score de 90,8 % au test MMLU (Multi-task Language Understanding), 84 % au MMLU-Pro et 71,5 % au GPQA Diamond, surpassant nettement DeepSeek-V3 et approchant OpenAI-o.
Raisonnement en sciences humaines et en histoire : taux de réussite de 100 % sur des devinettes chinoises, et fournit des réponses logiquement claires et riches en informations sur des questions historiques complexes telles que l'histoire de l'Égypte ancienne ou les peuples autochtones d'Afrique, surpassant les modèles non dédiés au raisonnement en termes de richesse informationnelle.
III. Écosystème open source et avantage en termes de faible coût
Stratégie open source et compatibilité commerciale
Open source sous licence MIT : le modèle complet (671B de paramètres) ainsi que 6 modèles distillés (1.5B-70B) sont tous open source, autorisant un usage commercial gratuit, la modification et le développement dérivé. Par exemple, la version distillée Qwen-14B peut fonctionner sur du matériel de bureau, avec un score LiveCodeBench de 53,1 %.
Révolution tarifaire de l'API : coût des tokens d'entrée aussi bas que 1 yuan/million (en cas de cache hit), tokens de sortie à seulement 16 yuans/million, soit environ 3,7 % du prix d'OpenAI-o1. Des tests utilisateurs montrent qu'un seul appel d'API peut coûter aussi peu que 0,06 dollar.
Outils pour développeurs et support d'intégration
Déploiement multi-plateforme : prend en charge Hugging Face, le framework vLLM et l'intégration Spring AI. Les développeurs peuvent invoquer le modèle via une configuration simple. Par exemple, les utilisateurs de Spring AI n'ont qu'à ajouter la dépendance et à configurer la clé d'API pour s'y connecter.
Optimisation de la stabilité du raisonnement : l'API désactive par défaut le paramètre temperature afin de garantir la stabilité des sorties, et renvoie respectivement la chaîne de pensée et la réponse finale via les champs reasoning_content et content.
IV. Cas d'utilisation
Recherche scientifique et éducation : assiste la modélisation mathématique, la génération de code et l'analyse historique, fournit des processus de raisonnement détaillés et facilite la recherche académique. Par exemple, génération de code d'animation en mécanique quantique ou résolution de problèmes mathématiques complexes.
Intelligence d'entreprise : intégration dans les systèmes de service client, les outils d'analyse de données ou les plateformes de décision automatisée, réduisant les coûts de déploiement de l'IA.
Avec sa stratégie open source et son coût extrêmement bas (coût d'entraînement de 5,576 millions de dollars, soit environ 1/10 de celui de GPT-4), R1 déclenche une guerre des prix dans le secteur. Des entreprises comme Meta ont déjà constitué des équipes dédiées pour étudier son approche technique.
Des experts tels que Yann LeCun estiment que le succès de R1 marque le passage des modèles open source du statut de « suiveurs » à celui de « leaders », favorisant la collaboration mondiale des développeurs et l'innovation technologique.
Avec ses capacités de raisonnement pilotées par l'apprentissage par renforcement et sa stratégie open source à faible coût, DeepSeek R1 constitue une avancée majeure dans le domaine de l'IA. Non seulement il excelle dans les tâches spécialisées telles que les mathématiques et le code, mais il favorise également l'innovation technologique mondiale à travers son écosystème open source, offrant un nouveau paradigme pour le développement de l'AGI.









