
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba lance officiellement le grand modèle open source Qwen2.5-1M
小编 ·

Alibaba lance officiellement le grand modèle open source Qwen2.5-1M
Alibaba a officiellement lancé le 27 janvier 2025 la série de grands modèles open source Qwen2.5-1M. Il s'agit de la première fois que l'équipe Tongyi Qianwen étend la longueur de contexte d'un modèle open source à 1 million de tokens (équivalent à environ 10 longs romans ou 30 000 lignes de code), réalisant ainsi une avancée significative en termes de performances dans le traitement de longs textes.
I. Principales caractéristiques de Qwen2.5-1M
Prise en charge de contexte ultra-long : le modèle Qwen2.5-1M prend en charge le traitement d'un contexte allant jusqu'à 1 million de tokens, ce qui équivaut à environ 1 million de mots en anglais ou 1,5 million de caractères chinois. Cette fonctionnalité permet au modèle de traiter des documents longs, tels que des livres, des documents juridiques et des rapports détaillés, sans avoir besoin d'effectuer une segmentation de texte fastidieuse.
Plusieurs tailles de modèle : les modèles publiés cette fois incluent Qwen2.5-7B-Instruct-1M et Qwen2.5-14B-Instruct-1M, offrant différentes échelles de paramètres pour répondre aux besoins de divers scénarios d'application.
Cadre d'inférence efficace : l'équipe Qwen a open sourcé un cadre d'inférence basé sur vLLM, intégrant un mécanisme d'attention sparse, ce qui permet une accélération de 3 à 7 fois lors du traitement d'entrées de 1M tokens. Cette efficacité permet aux développeurs de déployer et d'appliquer le modèle plus rapidement.
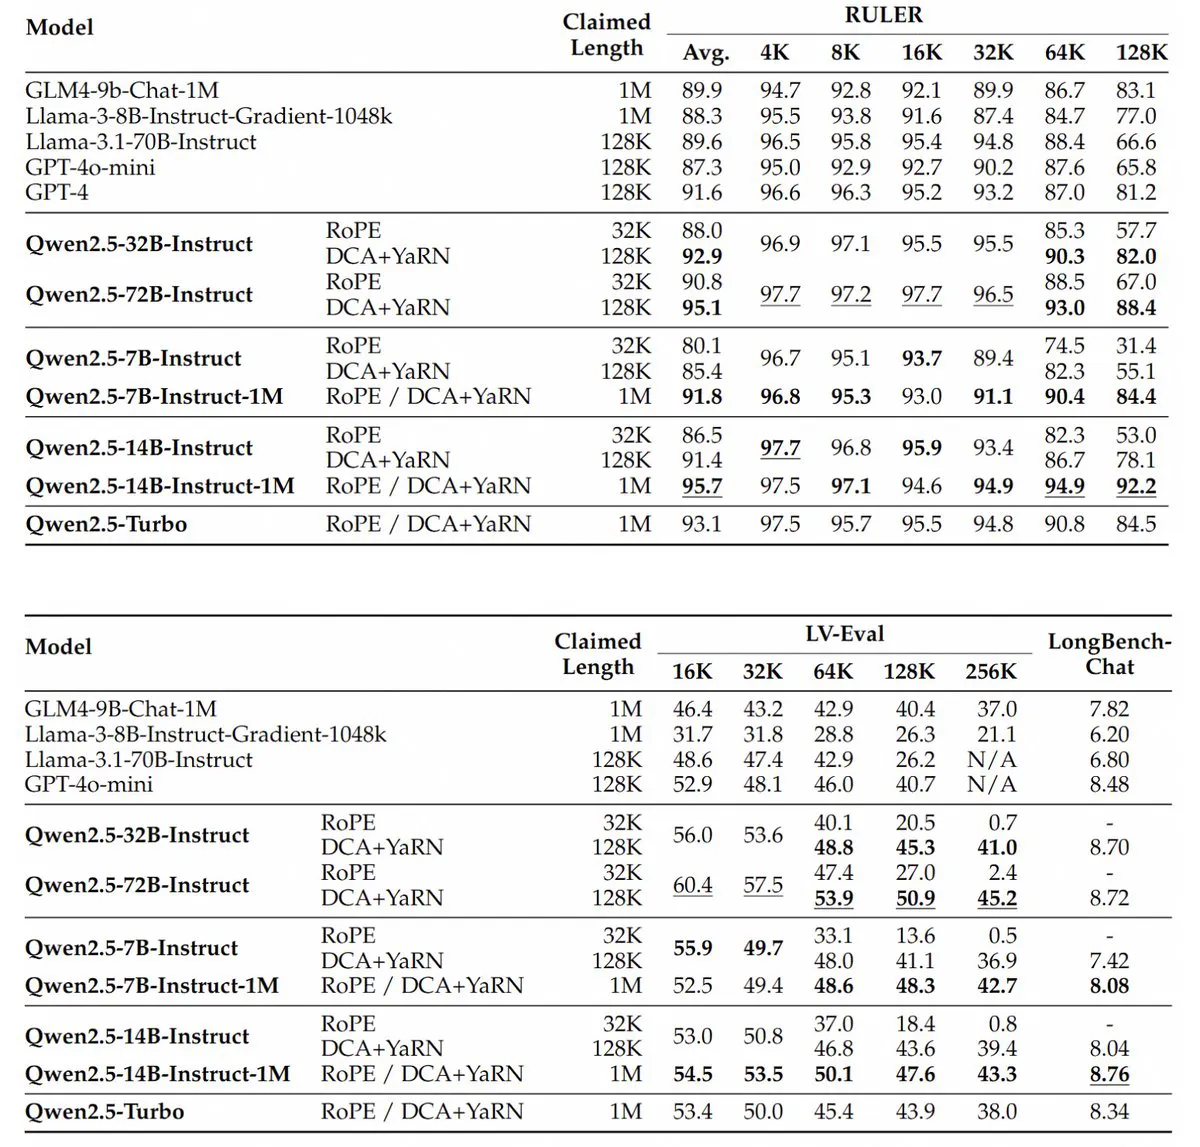
Avantages en termes de performances : sur les tâches de texte long, le modèle Qwen2.5-1M obtient des résultats nettement supérieurs à ceux de la version 128K précédente, en particulier lors du traitement de tâches dépassant 64K de longueur, démontrant ainsi des capacités plus solides.
II. Caractéristiques du modèle et performances
Capacité de traitement de longs contextes
Prise en charge d'un million de tokens : la série Qwen2.5-1M comprend deux versions, 7B et 14B, prenant en charge nativement une longueur de contexte de 1M tokens, capable de traiter des documents longs, des dépôts de code ou des dialogues complexes à plusieurs tours sans saisie segmentée.
Recherche et compréhension précises : dans la tâche « Passkey Retrieval » (recherche d'aiguille dans une botte de foin), le modèle peut extraire avec précision des informations cachées à partir de documents de 1M tokens, avec seulement quelques erreurs dans la version 7B ; lors des tests de référence sur la compréhension de longs textes tels que RULER et LV-eval, la version 14B surpasse de manière stable son propre modèle fermé Qwen2.5-Turbo ainsi que le GPT-4o-mini d'OpenAI.
Compatibilité avec les tâches de texte court
Les modèles 7B et 14B obtiennent des performances comparables à celles de la version 128K sur les tâches de texte court (telles que les questions-réponses et les résumés), sans sacrifier les performances de base au profit de capacités améliorées de contexte long. Par exemple, le modèle 14B affiche des performances proches de celles du GPT-4o-mini sur les tâches de texte court, mais avec une longueur de contexte 8 fois supérieure.
III. Percées techniques et cadre open source
Entraînement progressif et extrapolation de longueur
Extension par étapes : du pré-entraînement au fine-tuning supervisé, la longueur du contexte est progressivement étendue de 4K à 256K, puis optimisée par apprentissage par renforcement pour l'alignement sur les textes courts.
Dual Chunk Attention (DCA) : introduction d'une technique novatrice d'extrapolation d'encodage positionnel, permettant d'étendre la longueur de contexte prise en charge par le modèle de 256K à 1M sans entraînement supplémentaire, résolvant ainsi le problème de la dégradation de l'attention pour les encodages positionnels à longue distance.
Optimisation de l'inférence efficace
Mécanisme d'attention sparse : basé sur le cadre vLLM et intégrant l'attention sparse (MInference), combiné à un pré-remplissage par blocs et à des techniques de parallélisme dynamique, la vitesse d'inférence pour les entrées de 1M tokens est multipliée par 3,2 à 6,7, réduisant considérablement l'occupation mémoire (par exemple, réduction de 96,7 % de la mémoire d'activation pour le modèle 7B).
Prise en charge du cadre open source : le cadre d'inférence et le rapport technique d'entraînement sont entièrement open source, permettant aux développeurs de déployer rapidement le modèle, avec prise en charge de la quantification FP8 pour réduire les exigences matérielles.
IV. Scénarios d'application
Génération de texte : le modèle Qwen2.5-1M peut être utilisé pour générer de longs articles, rapports et histoires, adaptés à des domaines tels que la création de contenu, le journalisme et la rédaction.
Recherche d'informations : grâce à sa capacité de traitement de contexte ultra-long, le modèle peut effectuer une recherche d'informations efficace dans des textes longs, ce qui le rend adapté aux secteurs nécessitant le traitement d'un grand volume de documents, tels que le droit et la santé.
Systèmes de dialogue : ce modèle peut être utilisé pour construire des systèmes de dialogue intelligents, capables de comprendre et de générer des contenus de dialogue complexes, améliorant ainsi l'expérience utilisateur.
Applications multimodales : la conception du modèle Qwen2.5-1M lui permet de se combiner avec d'autres modalités (telles que l'image et l'audio), étendant ainsi son champ d'application aux tâches de compréhension et de génération multimodales.
La sortie de Qwen2.5-1M comble non seulement le vide dans le domaine du traitement de contexte ultra-long pour les modèles open source, mais offre également, grâce à l'innovation technologique et à l'ouverture de l'écosystème, un choix d'outils performant et accessible aux développeurs. Son succès pourrait accélérer l'exploration des applications de texte long par l'industrie mondiale de l'IA et promouvoir le rôle de la communauté open source dans la course à l'AGI.









