
 Assistant scénario▸
 Apps AI
 Actualités AI
FunAudioLLM : la percée d'Alibaba dans l'IA vocale
小编 ·

FunAudioLLM : la percée d'Alibaba dans l'IA vocale
FunAudioLLM est une suite de modèles de traitement de la voix développée par Alibaba, conçue pour améliorer l'interaction vocale entre les humains et les grands modèles de langage. Elle se compose de deux modèles principaux : SenseVoice et CosyVoice.
SenseVoice :un modèle de reconnaissance vocale capable de reconnaître la parole dans plusieurs langues, d'identifier les émotions du locuteur et de détecter des événements particuliers dans l'audio (comme la musique, les rires, etc.). Il peut transcrire le contenu vocal rapidement et avec précision.
CosyVoice :un modèle de génération vocale qui produit principalement une parole naturelle et riche en émotions. Il peut imiter différents locuteurs et même cloner la voix d'une personne à partir de quelques secondes d'échantillon audio.
Grâce à la combinaison de SenseVoice et de CosyVoice, FunAudioLLM offre des capacités complètes de compréhension et de génération vocale, rendant l'interaction vocale entre les humains et les grands modèles de langage plus naturelle et plus riche.
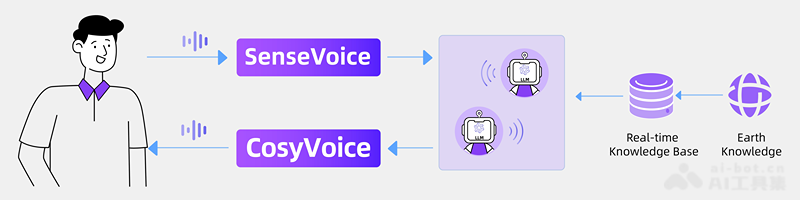
Principales caractéristiques de SenseVoice et CosyVoice :
SenseVoice se concentre sur la reconnaissance vocale multilingue, la reconnaissance des émotions et la détection d'événements audio, offrant une capacité de traitement vocal à haute précision et à faible latence. CosyVoice se concentre sur la génération et le contrôle de la parole naturelle, prenant en charge la génération en plusieurs langues, voix et styles de parole, permettant l'apprentissage zero-shot et un contrôle vocal fin. La combinaison des deux permet à FunAudioLLM de fournir une expérience d'interaction vocale exceptionnelle dans de nombreux scénarios d'application.
Principales caractéristiques de SenseVoice
1. Reconnaissance vocale multilingue
SenseVoice-Small : prend en charge cinq langues : chinois, anglais, cantonais, japonais et coréen. Il adopte une architecture de bout en bout non autorégressive, avec une latence de reconnaissance extrêmement faible. Il est 5 fois plus rapide que Whisper-small et 15 fois plus rapide que Whisper-large.
SenseVoice-Large : reconnaissance vocale de haute précision, prenant en charge plus de 50 langues.
2. Reconnaissance des émotions
Identifie les émotions dans la parole, telles que la joie, la tristesse, la colère, etc., en détectant les variations de hauteur, de rythme et d'intonation.
3. Détection d'événements audio
Détecte les événements particuliers dans la voix, tels que la musique, les rires, les applaudissements, etc., et prédit les heures de début et de fin de l'événement.
SenseVoice-Small peut détecter divers événements d'interaction homme-machine, tels que la musique de fond, les applaudissements, les rires, les pleurs, la toux, les éternuements, etc.
4. Identification de la langue
Capable d'identifier la langue utilisée par le locuteur afin de garantir la précision de la reconnaissance vocale et de la compréhension contextuelle.
5. Normalisation inverse du texte (ITN)
Fournit des résultats de transcription avec ponctuation et formatage afin d'améliorer la lisibilité et la précision du texte transcrit.
Principales caractéristiques de FunAudioLLM :
Reconnaissance vocale multilingue : plus de 400 000 heures de données d'entraînement, avec des performances de reconnaissance supérieures à celles des modèles Whisper.
Inférence efficace : le modèle SenseVoice-Small adopte un cadre de bout en bout non autorégressif, avec une latence d'inférence extrêmement faible. Le traitement de 10 secondes d'audio ne nécessite que 70 millisecondes, soit 15 fois plus rapide que Whisper-Large.
Reconnaissance des émotions : atteint les meilleurs résultats actuels parmi les modèles de reconnaissance des émotions sur plusieurs ensembles de données de test.
Détection d'événements : prend en charge la détection de nombreux événements audio courants.
Fine-tuning pratique : fournit des scripts et des stratégies de fine-tuning pratiques, permettant aux utilisateurs de résoudre facilement les problèmes d'échantillons à longue traîne en fonction de leur scénario métier.
Déploiement de services : fournit un pipeline de déploiement de services prenant en charge plusieurs requêtes simultanées, avec des langages clients incluant Python, C++, HTML, Java, C#, etc.
Principales caractéristiques de CosyVoice :
1. Génération vocale
Prend en charge la génération vocale multilingue, y compris le chinois, l'anglais, le cantonais, le japonais et le coréen.
Capable de générer une parole naturelle et riche en émotions, prenant en charge différents styles de parole et expressions émotionnelles.
2. Contrôle vocal diversifié
Contrôle de la voix : permet de contrôler précisément la voix générée pour qu'elle corresponde à celle d'un locuteur spécifique.
Contrôle du style de parole : contrôle le style de parole de la voix via des commandes textuelles, telles que l'émotion, la vitesse et le ton.
3. Apprentissage zero-shot
Il suffit de quelques secondes d'échantillon audio pour cloner une voix, sans données d'entraînement supplémentaires.
Prend en charge le clonage vocal multilingue, vous permettant de parler dans une langue avec la voix d'une autre langue.
4. Contrôle fin des caractéristiques paralinguistiques
Prend en charge l'insertion de caractéristiques vocales subtiles telles que les rires, les respirations et les particules d'intonation, rendant la voix générée plus naturelle et vivante.
Contrôle par commande textuelle : permet de contrôler précisément l'identité du locuteur, ses émotions et son style de parole via des commandes textuelles.
5. Dialogue multi-personnages
Il peut générer de la voix pour des conversations multi-personnages, adapté à des scénarios tels que les podcasts interactifs et les discussions émotionnelles.
Adresse du projet :https://github.com/FunAudioLLM









