
 Assistant scénario▸
 Apps AI
 Actualités AI
Alibaba Cloud publie le modèle open source Qwen2
小编 ·

Alibaba Cloud publie le modèle open source Qwen2
Alibaba Cloud lance le modèle open source Qwen 2, dont les performances surpassent tous les modèles open source actuels ainsi que les modèles fermés nationaux.
Le modèle Qwen 2 couvre plusieurs tailles, y compris 0.5B, 1.5B, 7B, 57B-A14B et 72B en 5 versions. Lors des évaluations de modèles de taille comparable, Qwen 2 a obtenu des résultats surpassant tous les modèles open source. Nous l'avons expérimenté sur le classement de grands modèles CompassArena, et c'est effectivement très performant, ce qui en fait probablement l'un des meilleurs actuellement pour le chinois.
Caractéristiques et fonctionnalités de Qwen 2 :
5 tailles de modèles pré-entraînés et ajustés aux instructions, dont Qwen2-0.5B, Qwen2-1.5B, Qwen2-7B, Qwen2-57B-A14B et Qwen2-72B ;
Entraîné sur des données dans 27 langues en plus de l'anglais et du chinois ;
Performances de pointe sur un grand nombre d'évaluations de référence ;
Amélioration significative des performances en codage et en mathématiques ;
Les modèles Qwen2-7B-Instruct et Qwen2-72B-Instruct prennent en charge une longueur de contexte étendue pouvant atteindre 128K tokens.
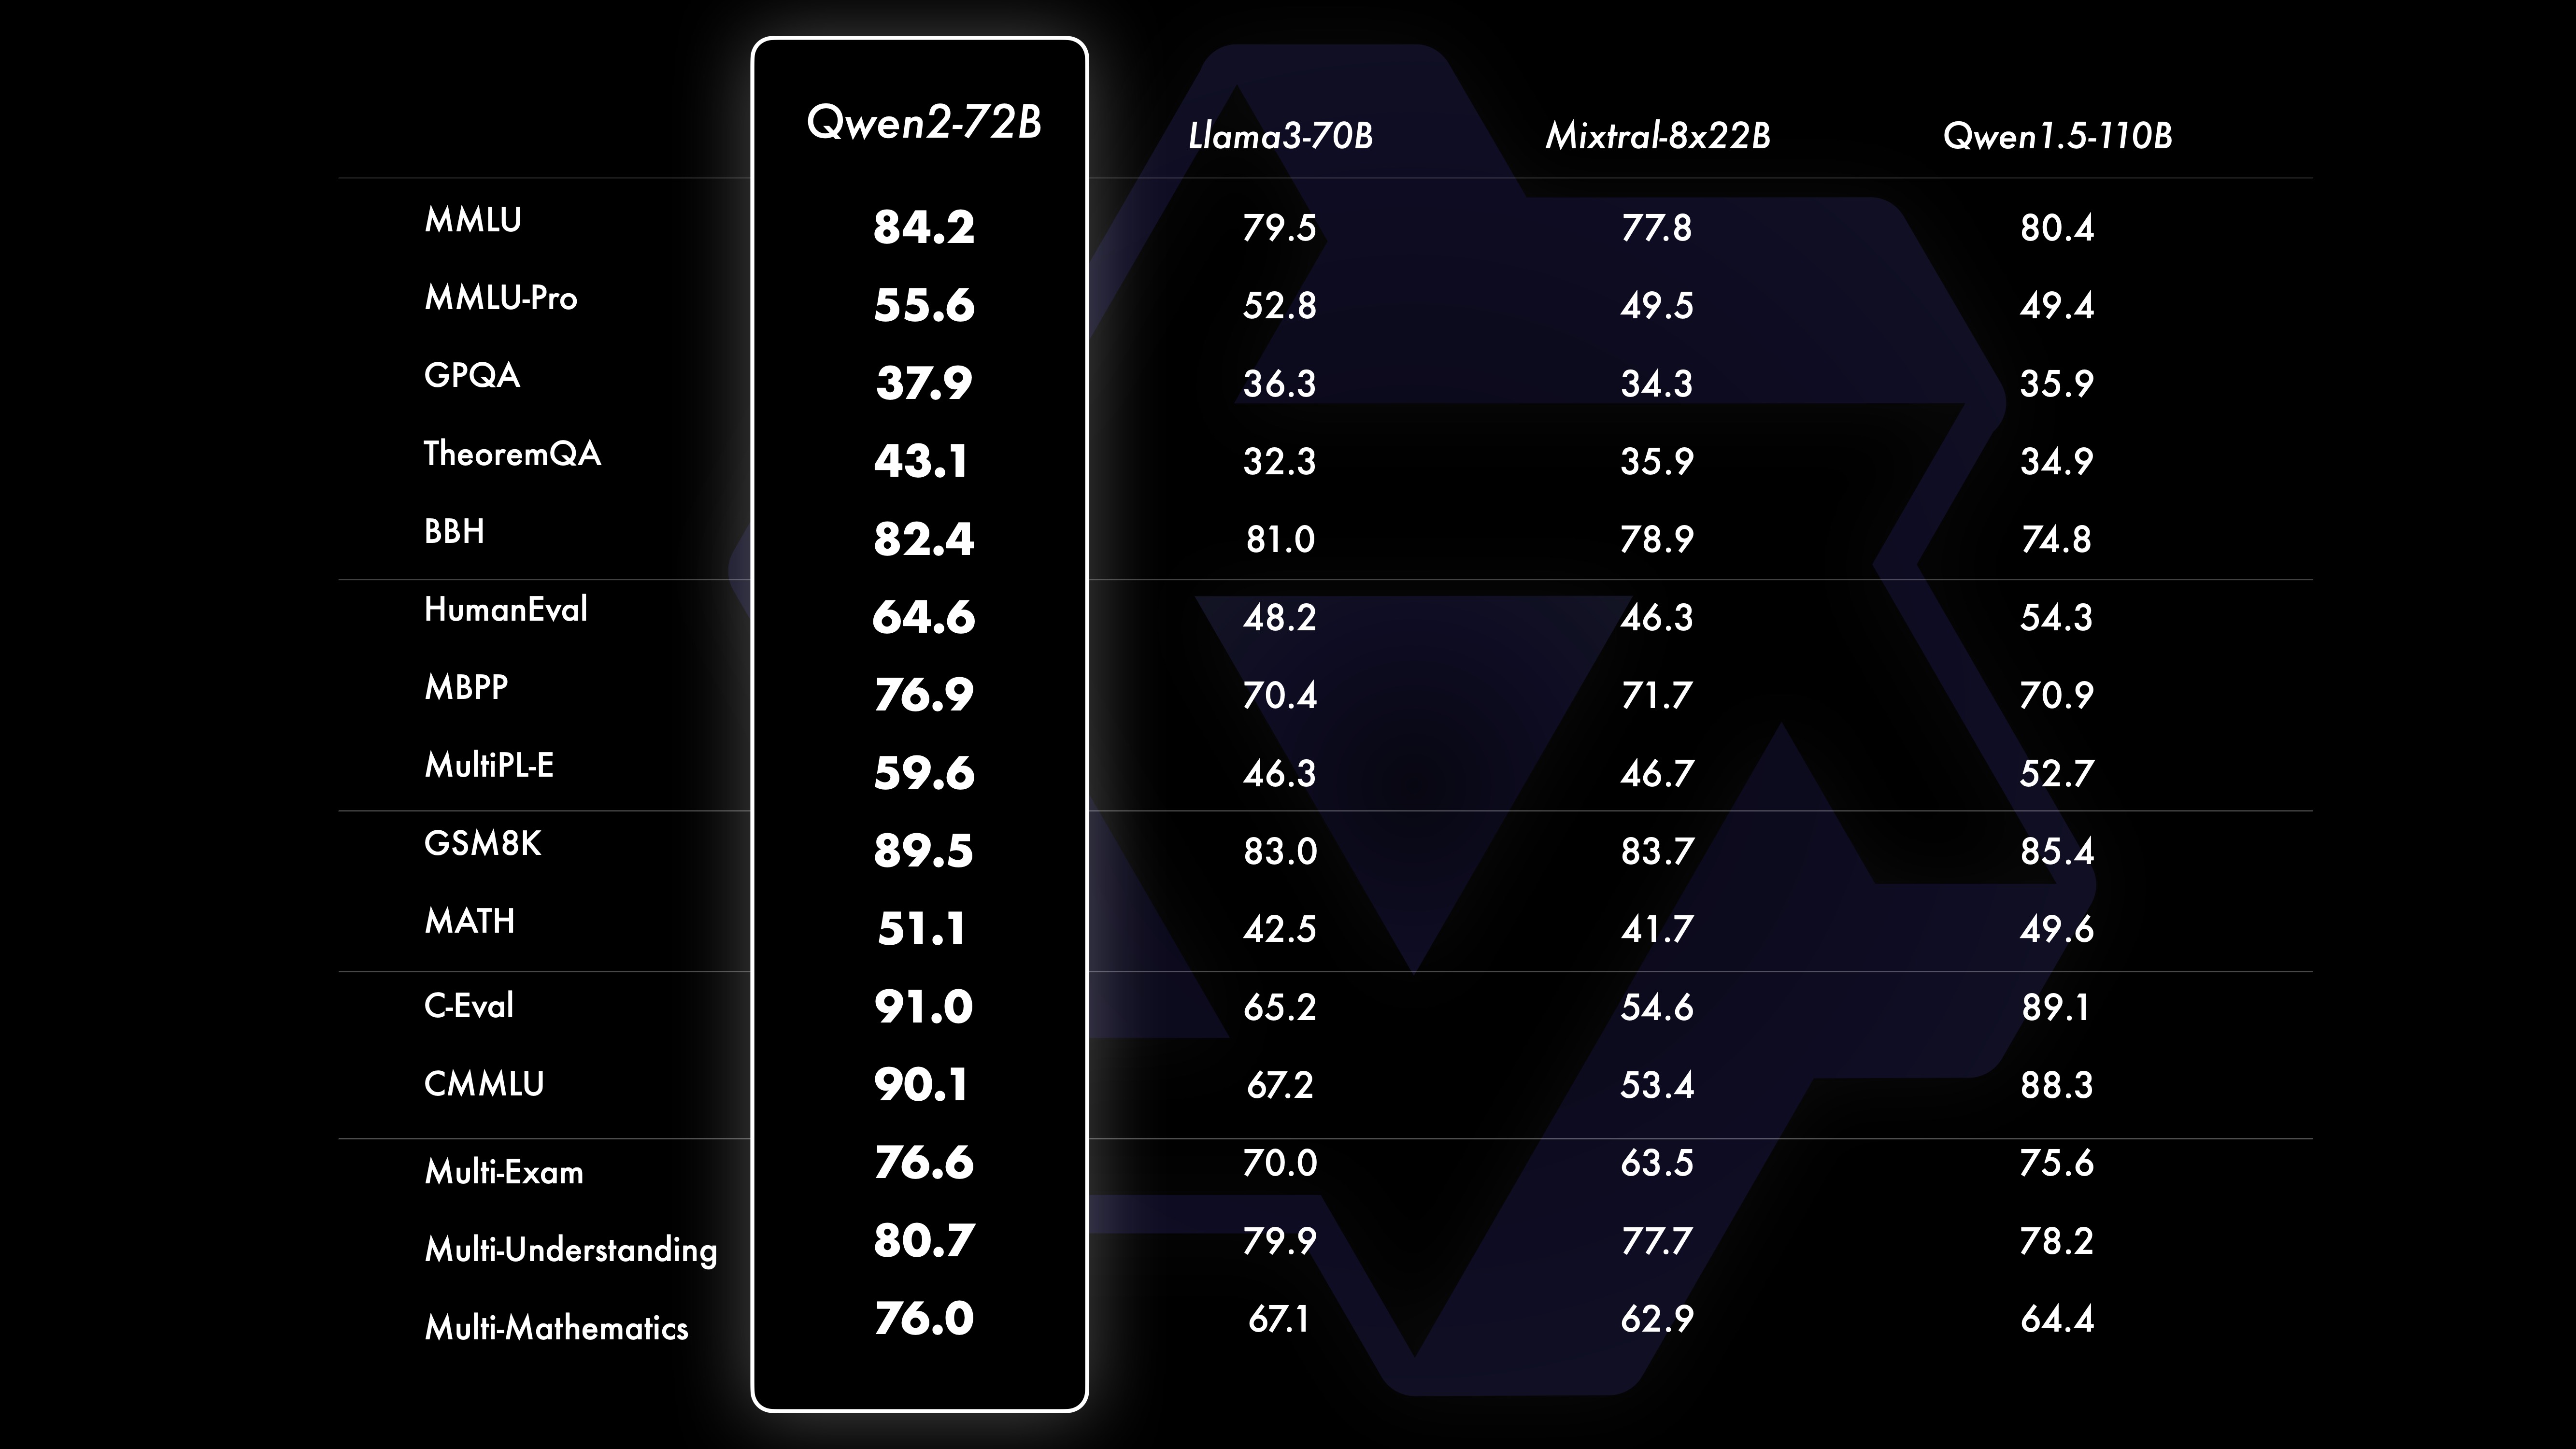
Des évaluations comparatives montrent que, par rapport à Qwen1.5, les performances des grands modèles (70B+ paramètres) ont été considérablement améliorées. L'accent de notre évaluation ici est mis sur le modèle de grande taille Qwen2-72B. En termes de modèle de langage de base, Qwen2-72B et les modèles ouverts les plus avancés ont été évalués sur différentes capacités, notamment la compréhension du langage naturel, l'acquisition de connaissances, les capacités de codage, les compétences mathématiques et les capacités multilingues. Grâce à un ensemble de données soigneusement sélectionné et à une méthode d'entraînement optimisée, Qwen2-72B présente des performances supérieures par rapport à des modèles leaders tels que Llama-3-70B. Notamment, malgré un nombre moindre de paramètres, ses performances surpassent celles de son prédécesseur Qwen1.5-110B.
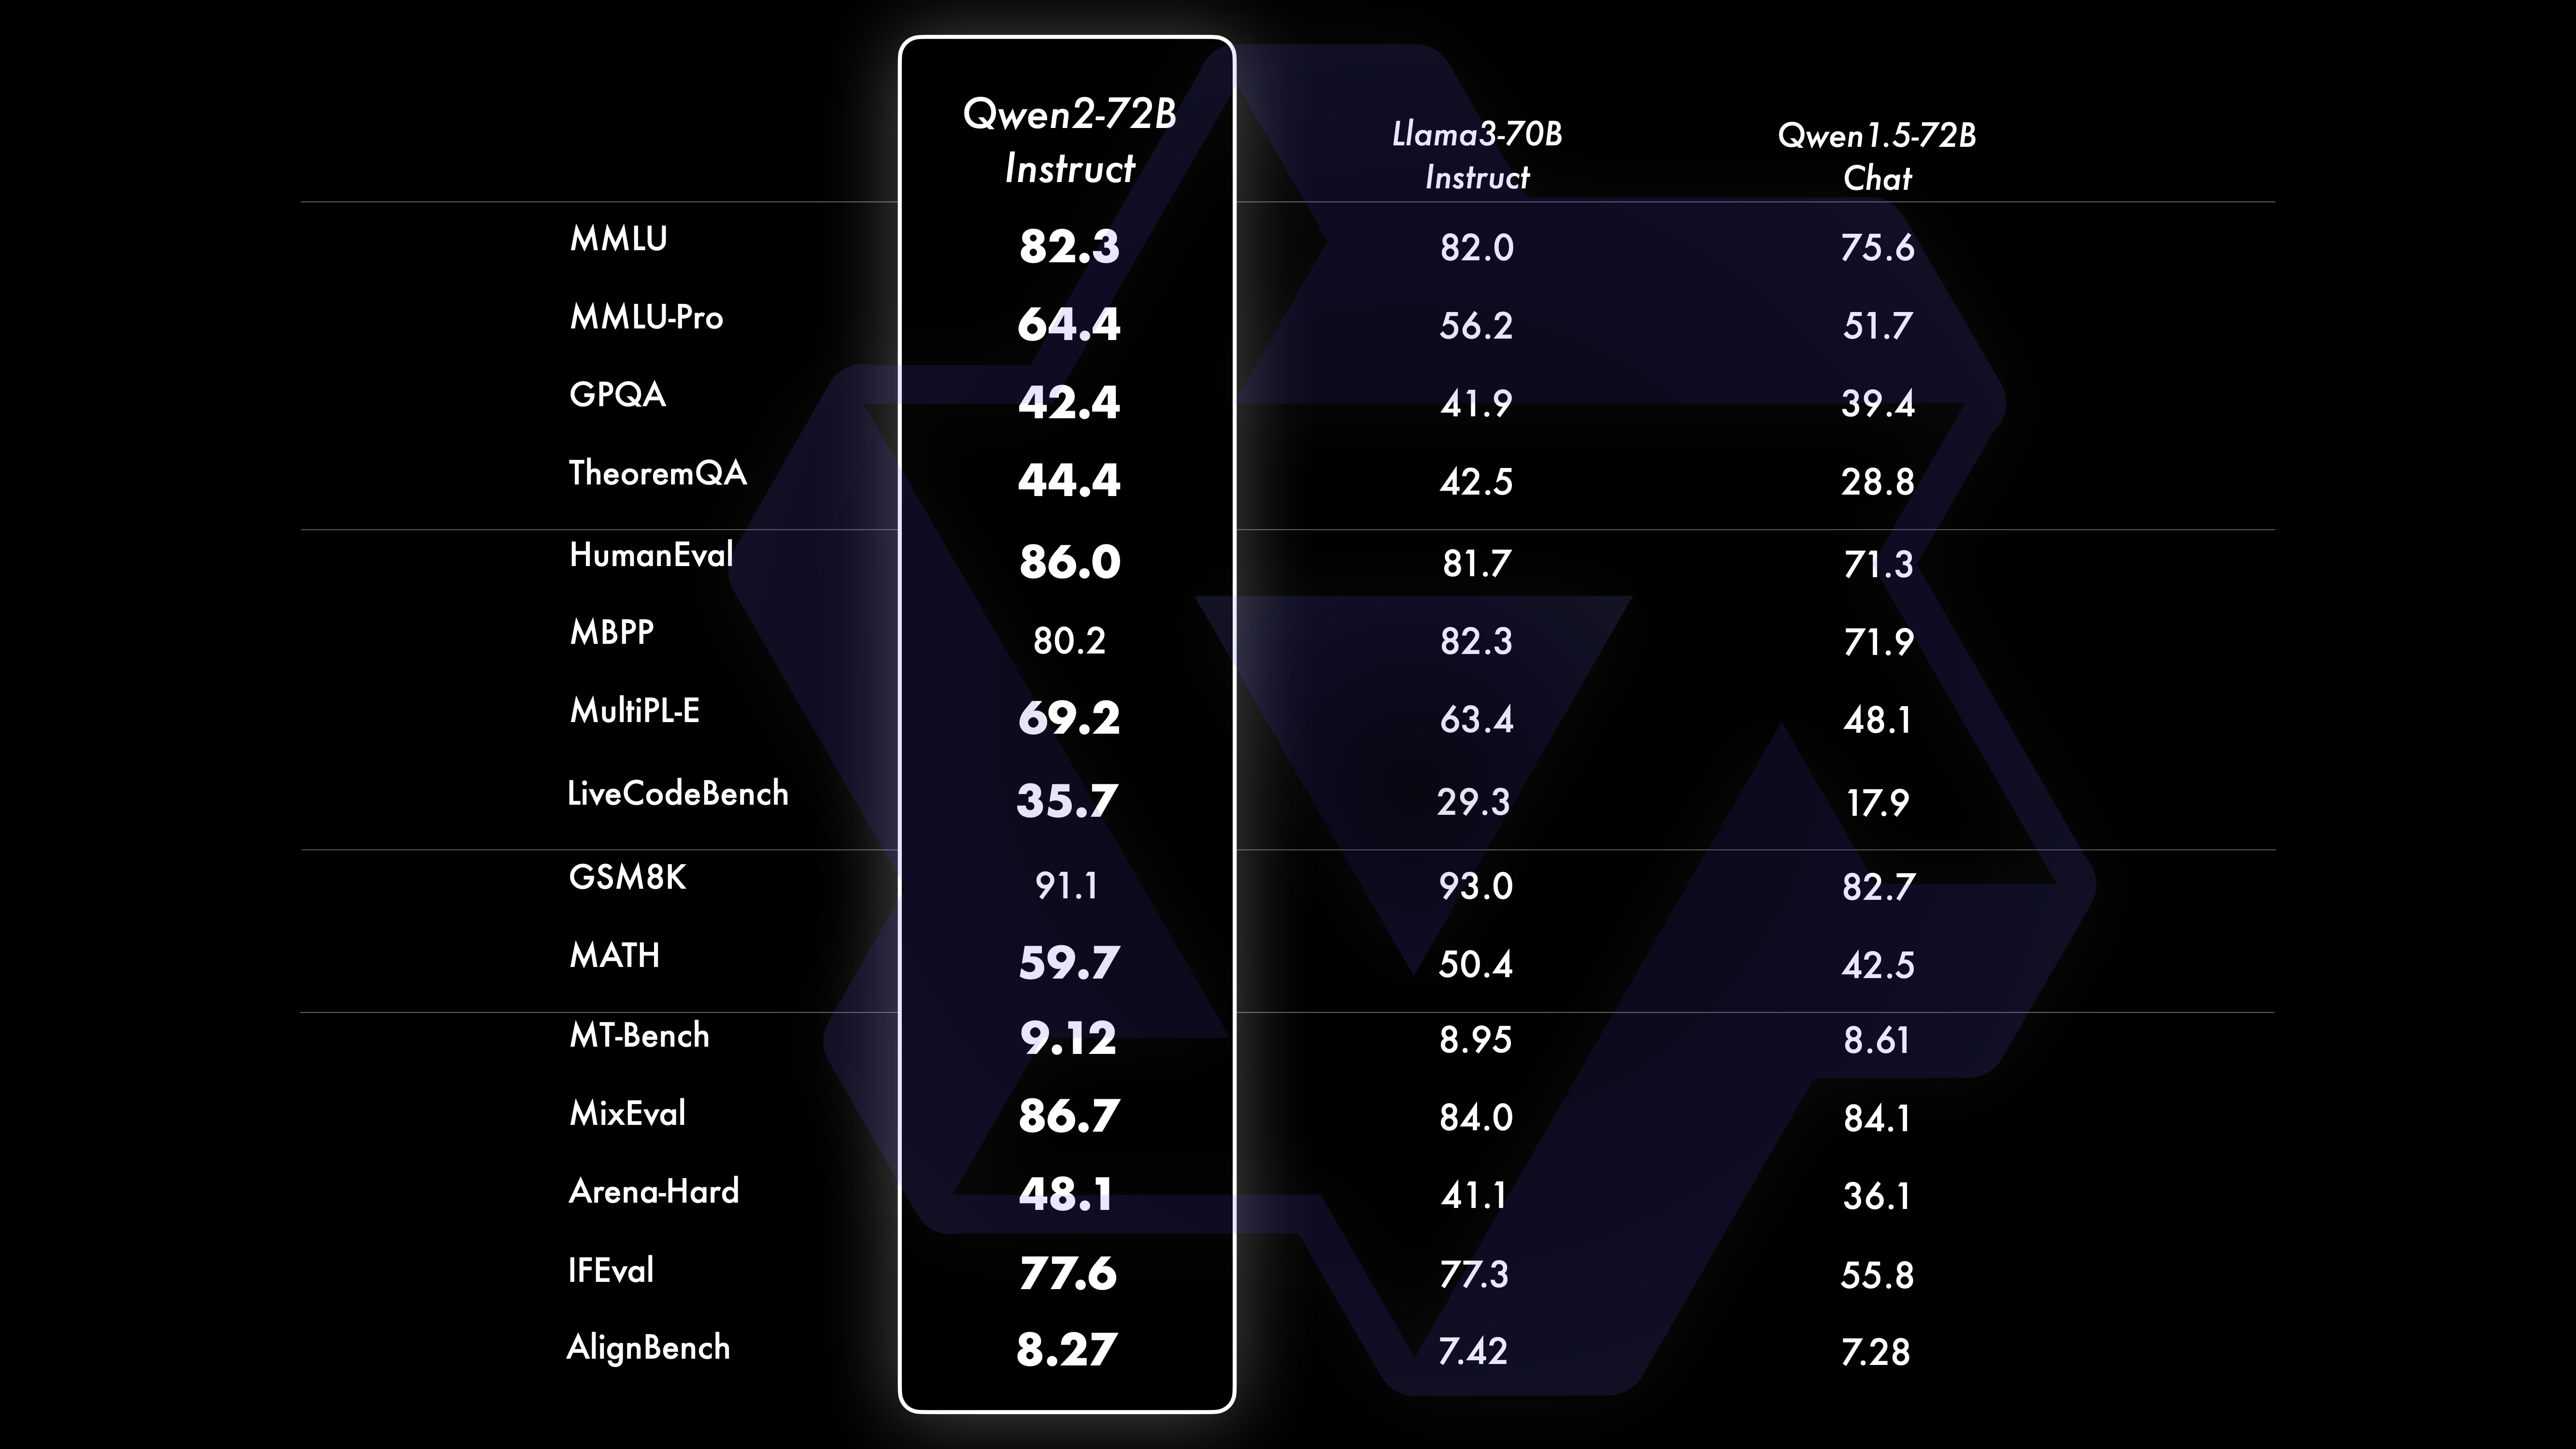
Après un vaste pré-entraînement à grande échelle, nous procédons à un post-entraînement pour améliorer davantage l'intelligence de Qwen et la rapprocher de celle de l'humain. Ce processus améliore encore les capacités du modèle dans des domaines tels que le codage, les mathématiques, le raisonnement, le suivi des instructions et la compréhension multilingue. De plus, il aligne les sorties du modèle sur les valeurs humaines, en veillant à ce qu'il soit utile, honnête et inoffensif. La conception de notre phase de post-entraînement suit le principe d'un entraînement évolutif et ne nécessite qu'un minimum d'annotations humaines. Plus précisément, nous étudions comment obtenir des données de démonstration et des données de préférence de haute qualité, fiables, diversifiées et créatives via diverses stratégies d'alignement automatique, telles que l'échantillonnage par rejet pour les mathématiques, la rétroaction d'exécution pour le codage et le suivi des instructions, la traduction inverse pour l'écriture créative, ainsi que la supervision évolutive pour le jeu de rôle, etc. En termes d'entraînement, nous avons adopté une combinaison de fine-tuning supervisé, d'entraînement de modèle de récompense et d'entraînement DPO en ligne. Nous utilisons également un nouvel optimiseur de fusion en ligne pour minimiser l'« alignment tax ». Ces efforts collectifs ont considérablement amélioré les capacités et l'intelligence de nos modèles, comme le montre le tableau ci-dessous.
Quelle est la prochaine étape pour Qwen2 ?
Nous entraînons des modèles Qwen2 encore plus grands afin d'explorer davantage la mise à l'échelle des modèles ainsi que notre récente mise à l'échelle des données. De plus, nous étendons le modèle linguistique Qwen2 au multimodal, capable de comprendre les informations visuelles et audio. Dans un avenir proche, nous continuerons à ouvrir de nouveaux modèles en open source, afin d'accélérer le développement de l'IA open source. Restez à l'écoute !
Github : https://github.com/QwenLM/Qwen2
Lien de téléchargement : https://modelscope.cn/organization/qwen
Lien d'expérience : https://modelscope.cn/studios/opencompass/CompassArena/summary
Présentation détaillée : https://qwenlm.github.io/blog/qwen2/









