
 Assistant scénario▸
 Apps AI
 Actualités AI
ViViD : vidéo d'essayage virtuel avec des modèles de diffusion
小编 ·

ViViD : vidéo d'essayage virtuel avec des modèles de diffusion
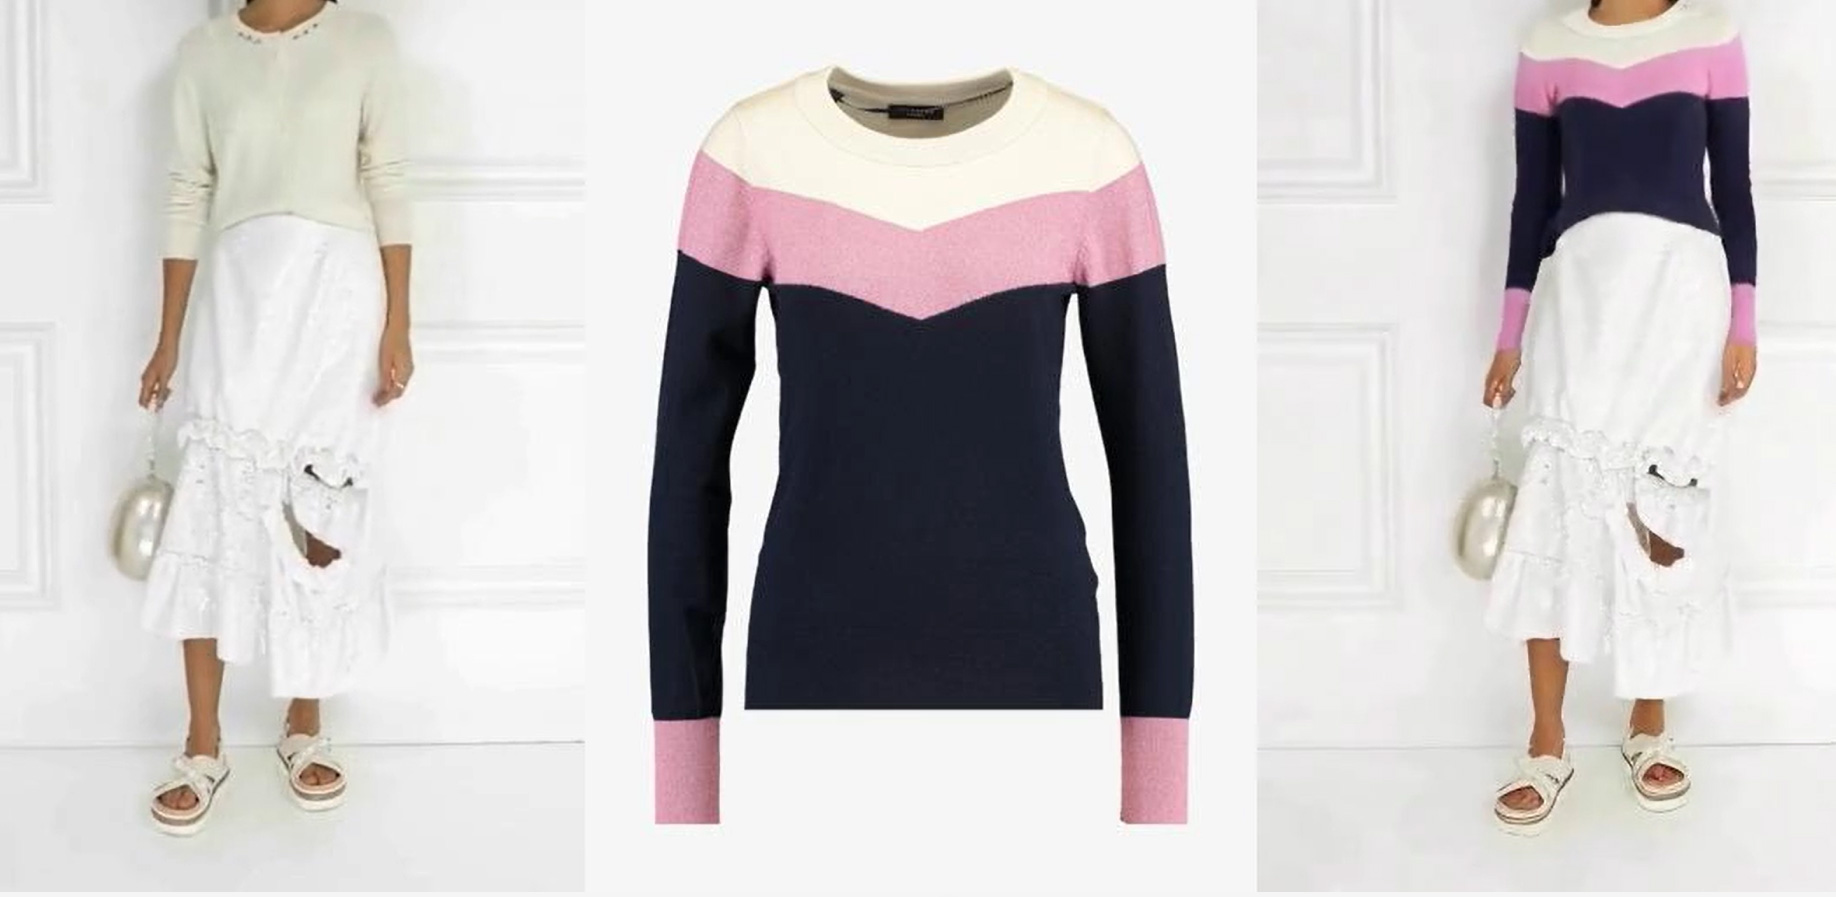
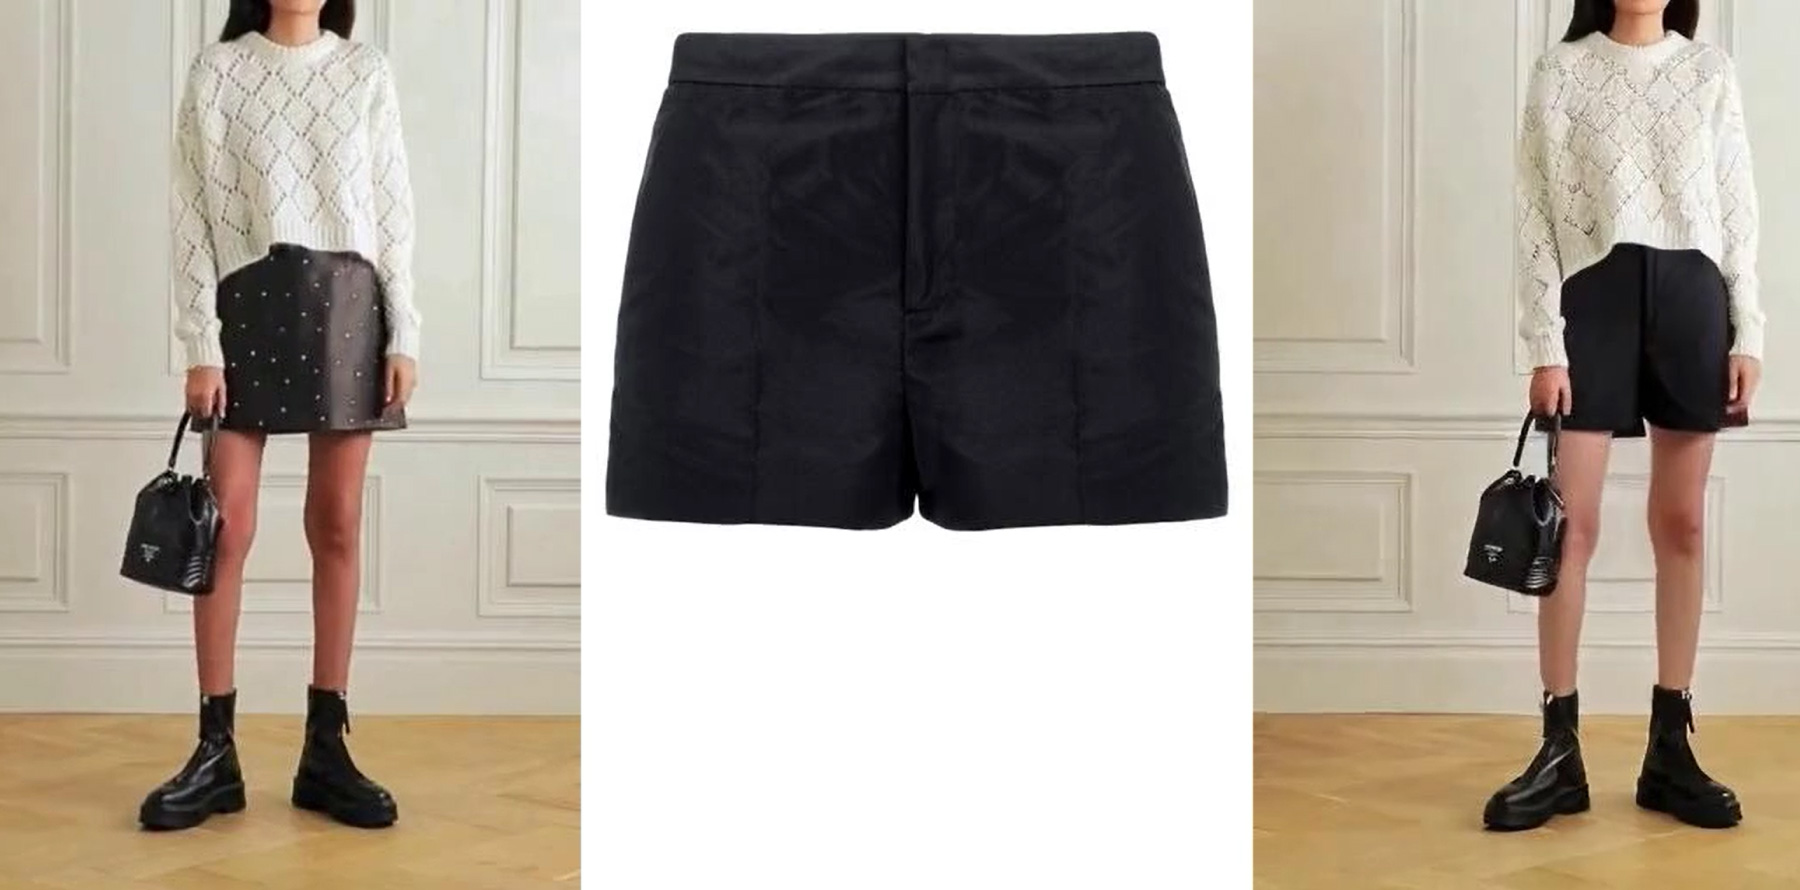
ViViD, la technologie d'essayage virtuel en vidéo développée par Alibaba, permet de remplacer à volonté les vêtements des personnes dans une vidéo. ViViD est capable de générer des vidéos d'essayage virtuel naturelles et réalistes, en transférant les vêtements sur la personne présente dans la vidéo tout en conservant le reste de la vidéo inchangé.
Site de démonstration de ViViD : https://becauseimbatman0.github.io/ViViD
Adresse du papier de ViViD : https://arxiv.org/abs/2405.11794
Avec le développement rapide du commerce électronique, les consommateurs peuvent facilement accéder à différents types de vêtements via des plateformes en ligne telles que Taobao ou JD.com. Cependant, en se basant uniquement sur les images de vêtements proposées sur ces sites, il leur est difficile d'imaginer l'effet d'un vêtement une fois porté. Bien que les techniques de changement de tenue sur image soient relativement matures, le changement de tenue en vidéo, notamment en termes d'interaction avec les mouvements du corps, reste une technologie rare.
L'essayage virtuel en vidéo consiste à transférer un vêtement sur une personne cible. L'application directe des techniques d'essayage basées sur l'image, image par image, au domaine vidéo entraîne des incohérences temporelles, tandis que les solutions précédentes d'essayage basées sur la vidéo ne permettaient d'obtenir que des résultats de faible qualité visuelle et flous.
ViViD, la technologie d'essayage virtuel en vidéo développée conjointement par l'Université des sciences et technologies de Chine et le groupe Alibaba, vise à résoudre ce problème grâce à la synthèse vidéo, permettant aux consommateurs de voir l'effet réel d'un vêtement porté sur eux. Ce cadre vidéo s'appuie sur des modèles de diffusion (Diffusion Models) pour produire des vidéos d'essayage de haute qualité et cohérentes.
Plus précisément, nous avons conçu un encodeur de vêtements pour extraire des caractéristiques sémantiques fines des vêtements, guidant le modèle à capturer les détails du vêtement et à les injecter dans la vidéo cible via le mécanisme proposé de fusion de caractéristiques par attention. Pour garantir la cohérence spatio-temporelle, nous introduisons un encodeur de pose léger pour coder les signaux de pose, permettant au modèle d'apprendre les interactions entre les vêtements et la posture humaine, et nous insérons des modules temporels hiérarchiques dans le modèle stable de diffusion texte-à-image afin d'obtenir une synthèse vidéo plus cohérente et réaliste.
De plus, nous avons collecté un nouveau jeu de données, qui est à ce jour le plus vaste, le plus diversifié en types de vêtements et le plus haute résolution pour la tâche d'essayage virtuel en vidéo. De nombreuses expériences montrent que notre méthode permet de produire des résultats d'essayage vidéo satisfaisants. Le jeu de données, le code et les poids seront rendus publics.









