
 Assistant scénario▸
 Apps AI
 Actualités AI
SignLLM : le premier modèle multilingue de génération de langue des signes
小编 ·

SignLLM : le premier modèle multilingue de génération de langue des signes
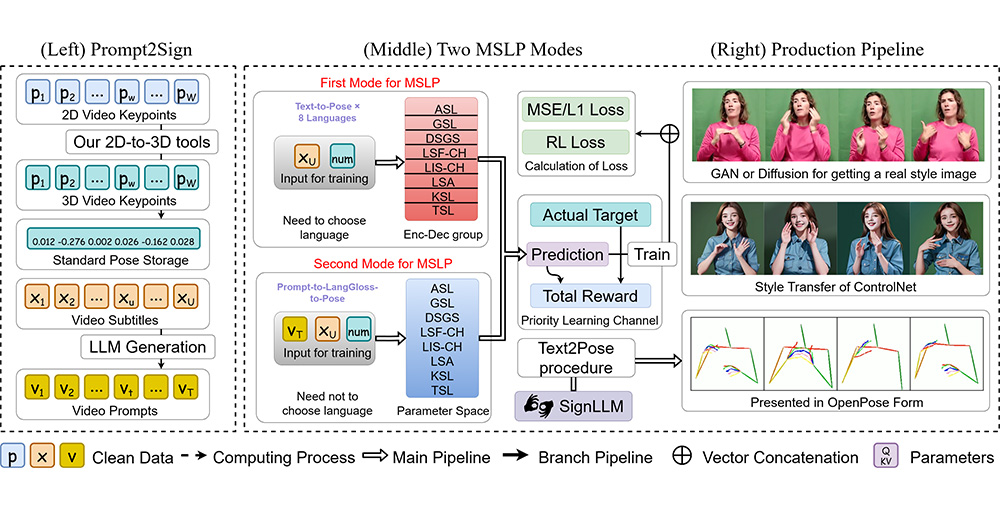
SignLLM, le premier modèle multilingue de génération de la langue des signes, peut transformer un texte ou une invite saisi(e) en gestes correspondants de la langue des signes sous forme de vidéo. SignLLM génère et traduit plusieurs langues des signes grâce à une technologie d'IA avancée. SignLLM a introduit le premier jeu de données multilingue sur la langue des signes, nommé Prompt2Sign, et a développé sur cette base plusieurs modèles de génération de la langue des signes. Ce jeu de données convertit un grand nombre de vidéos dans un format facilitant l'entraînement des modèles, optimisant l'entraînement de modèles de traduction tels que seq2seq et text2text. Sur la base de ces jeux de données, nous présentons les résultats de référence de SignLLM, montrant que notre modèle atteint des performances de pointe dans la tâche de génération de la langue des signes pour huit langues des signes.
Inspiré par les puissantes capacités de traduction des grands modèles de langage (LLMs) entraînés sur de vastes corpus textuels multilingues, SignLLM vise à exploiter les LLMs existants pour traiter la SLT (traduction en langue des signes). Dans cet article, nous normalisons les vidéos en langue des signes afin de refléter les caractéristiques linguistiques de la langue parlée, et nous proposons un nouveau cadre SignLLM qui convertit les vidéos en langue des signes en représentations de type linguistique, afin d'améliorer la lisibilité pour les LLMs existants.
SignLLM comprend deux modules clés :
1. Un module de symboles visuels par quantification vectorielle qui convertit les vidéos de signes en une séquence de jetons de symboles discrets au niveau des caractères.
2. Un module de reconstruction et d'alignement de codebook qui convertit ces jetons au niveau des caractères en représentations de symboles au niveau des mots en utilisant une formulation de transport optimal. Une perte d'alignement symbole-texte comble en outre le fossé entre les jetons de symboles et les jetons de texte, améliorant la compatibilité sémantique. Nous avons obtenu des résultats de pointe sans gloss sur deux benchmarks SLT largement utilisés.
Adresse GitHub de SignLLM : https://signllm.github.io/









