
 Assistant scénario▸
 Apps AI
 Actualités AI
Stable Diffusion 3 : quelles améliorations et nouveautés ?
小编 ·

Stable Diffusion 3 : quelles améliorations et nouveautés ?
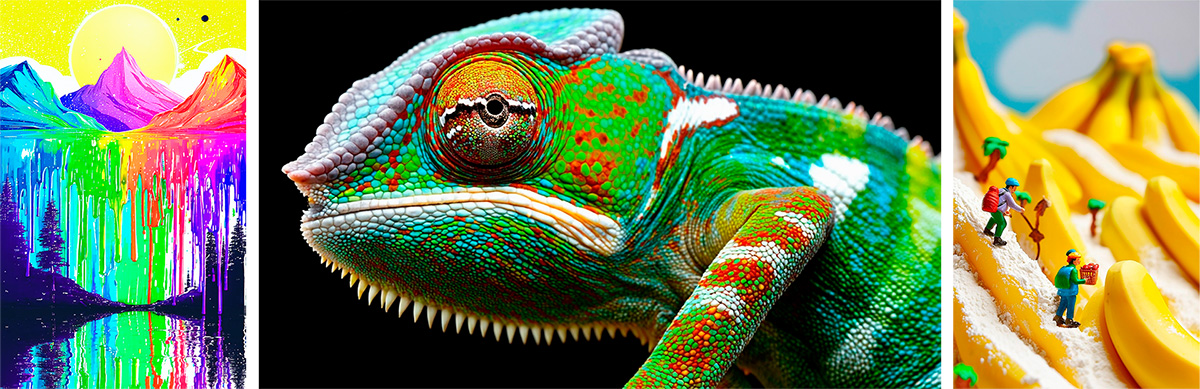
Jeudi, Stability AI a annoncé le lancement de Stable Diffusion 3, la version la plus récente et la plus puissante du modèle d'IA de génération d'images de l'entreprise. Le modèle adopte une architecture de transformeur de diffusion, améliorant considérablement les performances en matière de invites à sujets multiples, de qualité d'image et de capacité d'orthographe.
Stable Diffusion 3 utilise un « transformeur de diffusion » mis à jour, une technologie créée pour la première fois en 2022, mais révisée en 2023, et désormais rendue évolutive. Le générateur de vidéos impressionnant d'OpenAI, Sora, suit apparemment un principe similaire (l'un des co-auteurs de l'article, Will Peebles, continue de codiriger le projet Sora). La gamme de modèles Stable Diffusion 3 (qui prennent des descriptions textuelles appelées « invites » et les convertissent en images correspondantes) varie de 800 millions à 8 milliards de paramètres. Cette gamme de tailles permet à différentes versions du modèle de fonctionner localement sur divers appareils, des smartphones aux serveurs.
Améliorations et gains de performances de Stable Diffusion 3 :
1. Capacités améliorées de traitement multi-sujets : Le nouveau modèle améliore considérablement sa capacité à comprendre et à traiter des invites contenant plusieurs sujets ou éléments. Cela permet aux utilisateurs de décrire des scènes plus complexes dans une seule invite, le modèle étant capable de générer des images plus précisément à partir de ces descriptions.
2. Qualité d'image améliorée : Stable Diffusion 3 offre une amélioration significative de la qualité des images générées, avec des détails plus fins, une correspondance des couleurs plus précise et des effets de lumière et d'ombre plus naturels. Ces progrès rendent les images générées plus réalistes et permettent de mieux capturer l'intention créative de l'utilisateur.
3. Orthographe et traitement de texte améliorés : Cette version démontre une meilleure capacité d'orthographe et de compréhension du texte lors du traitement d'images contenant des éléments textuels (tels que des slogans, des étiquettes, etc.). Cela signifie que le modèle peut reconnaître et restituer plus précisément le texte contenu dans les invites, même dans des contextes visuels complexes.
4. Adoption d'une nouvelle technologie de transformeur de diffusion : Stable Diffusion 3 introduit une nouvelle technologie de transformeur de diffusion, similaire à Sora, dotant le modèle de capacités de génération d'images encore plus puissantes. Le transformeur est un modèle d'apprentissage profond conçu pour construire progressivement les détails d'une image afin de produire un contenu visuel de haute qualité.
5. Appariement de flux et autres améliorations techniques : Le modèle intègre des techniques d'appariement de flux et d'autres améliorations techniques afin d'accroître encore la qualité et la diversité des images générées. La technique d'appariement de flux aide le modèle à mieux comprendre et simuler les éléments dynamiques et les structures dans les images, rendant les images générées visuellement plus cohérentes et naturelles.
6. Exploitation des avancées de la technologie Transformer : Stable Diffusion 3 tire pleinement parti des dernières avancées de la technologie Transformer, étendant non seulement les capacités du modèle, mais lui permettant également de traiter des entrées multimodales. Cela signifie que le modèle peut gérer des types de données plus complexes et diversifiés, tels que des combinaisons d'entrées textuelles et d'images, offrant ainsi plus de flexibilité et de précision dans la compréhension et la génération de contenu visuel.
Bien que certaines innovations techniques clés aient déjà été mentionnées, Stability AI prévoit de publier prochainement davantage de détails techniques. Ces détails fourniront à la communauté technique et aux utilisateurs intéressés une compréhension approfondie des fondements techniques et des points d'innovation de Stable Diffusion 3.
Bien que Stable Diffusion 3 ne soit pas encore largement adopté, Stability indique que, dès la fin des tests, les utilisateurs pourront télécharger gratuitement ses poids et l'exécuter dans un environnement local. Stability a déclaré dans son communiqué : « Comme pour la phase de prévisualisation des modèles précédents, cette phase est extrêmement importante pour recueillir des commentaires, optimiser les performances et améliorer la sécurité avant la publication officielle. »
Récemment, Stability a exploré plusieurs techniques de synthèse d'images. Outre SDXL et SDXL Turbo, l'entreprise a également lancé la semaine dernière Stable Cascade, une technique de synthèse qui génère des images à partir de texte via un processus en trois étapes. De plus, un autre produit de Stability AI, texte en vidéo et image en vidéo, Stable Video, a également été lancé lors de cette bêta publique, offrant ainsi davantage de choix aux utilisateurs.









