
 Asistente de guiones▸
 Apps AI
 Noticias AI

Pixelle-Video: motor de vídeos cortos totalmente automatizado con IA
Pixelle-Video: motor de vídeos cortos totalmente automatizado con IAIntroducción
Qué es Pixelle-Video
Pixelle-Video es una herramienta de generación de vídeos cortos para ComfyUI, de código abierto, publicada por AIDC-AI. Solo tienes que proporcionarle un tema y se encargará automáticamente de escribir el guion, generar las imágenes, sintetizar la locución y montar el vídeo, sin que tengas que editar prácticamente nada. Es compatible con varios modelos como GPT, Tongyi Qianwen y DeepSeek, y también admite clonación de voz y presentadores virtuales, por lo que resulta ideal para operadores de medios sociales y para quienes se están iniciando en el vídeo con IA.
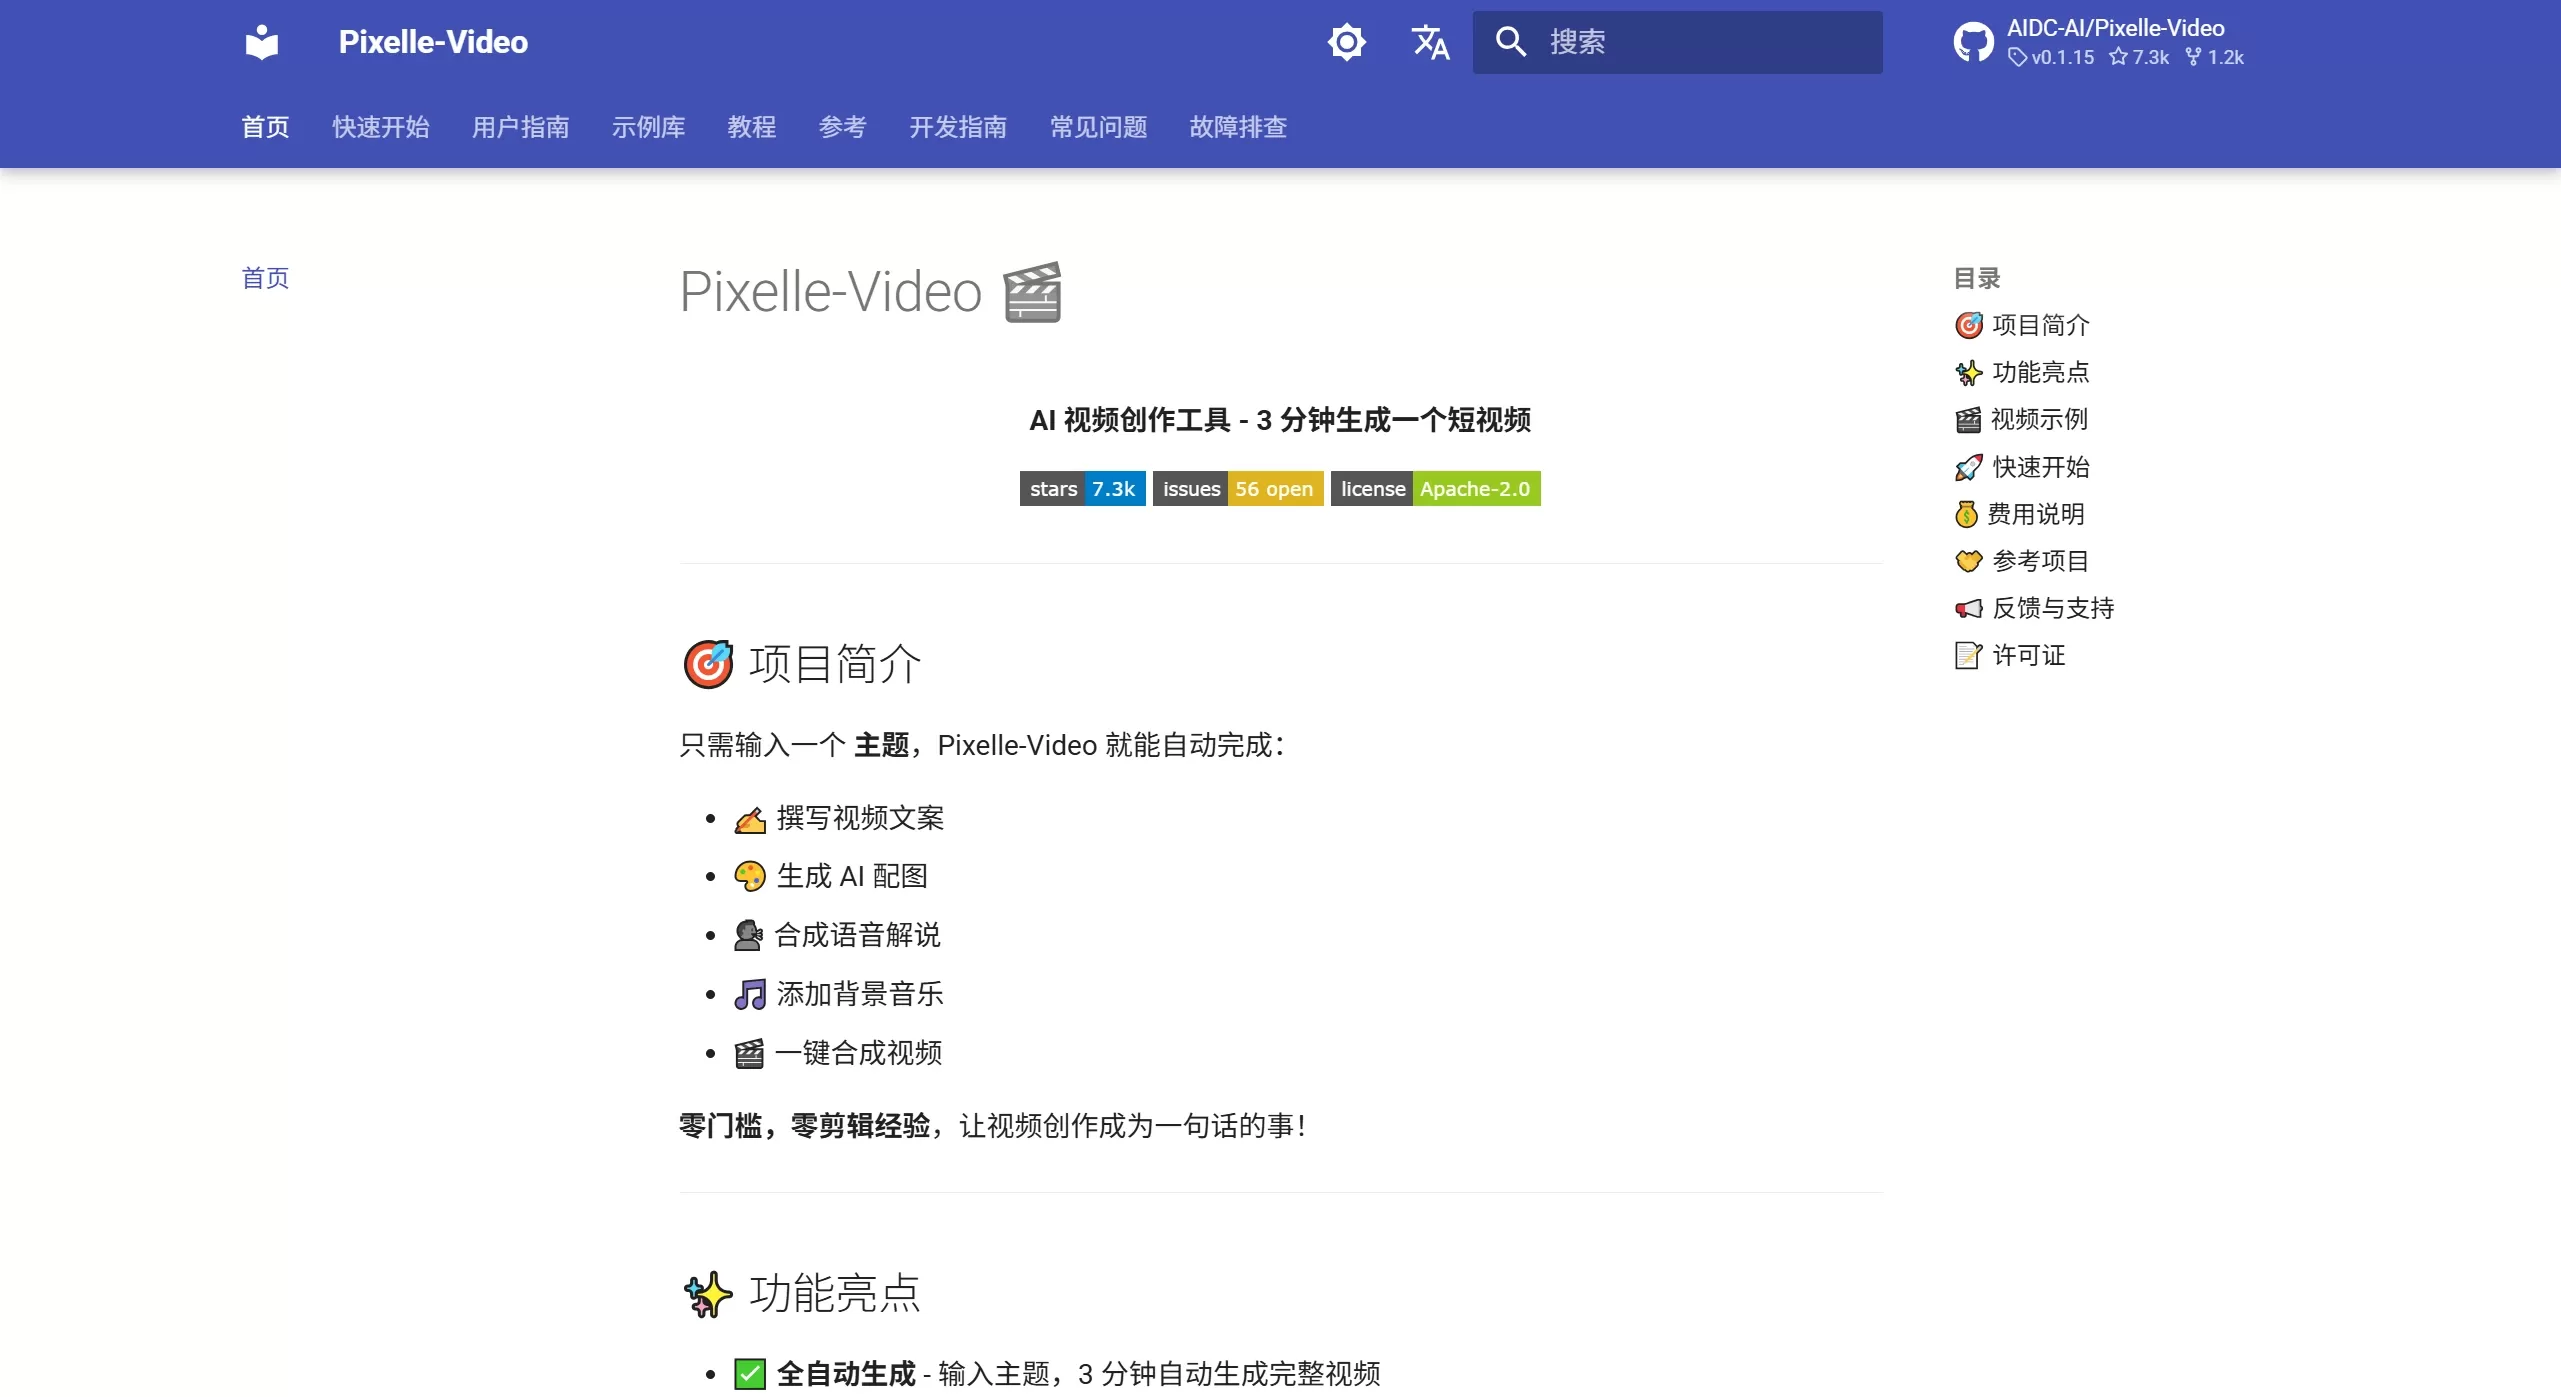
Captura de pantalla del sitio web oficial de Pixelle-Video
Características
Flujo cerrado totalmente automático: tras introducir un tema, el sistema invoca automáticamente un modelo de lenguaje grande para generar el guion del comentario, asocia a cada frase textos con imágenes o vídeos dinámicos generados por IA, sintetiza la locución y la música de fondo, y, por último, produce el vídeo completo.
Soporte multimodelo LLM: el motor de guiones puede utilizar backends como GPT, Tongyi Qianwen, DeepSeek u Ollama, lo que permite al usuario alternar libremente según el coste, la velocidad de respuesta o el estilo del contenido, sin necesidad de llamar a APIs externas en despliegues locales.
Generación visual con IA: compatible con modelos como FLUX, WAN 2.1 / 2.2 para generar imágenes y vídeos dinámicos; también se pueden subir imágenes o materiales de vídeo propios, que la IA analiza para generar automáticamente un guion acorde.
Voz inteligente y clonación: integra las principales soluciones de síntesis de voz como Edge-TTS e Index-TTS, admite clonación de voz (subiendo audios de referencia en MP3/WAV/FLAC) e incorpora funciones de TTS multilingüe y locución con presentadores virtuales.
Plantillas y formatos flexibles: ofrece tres tipos de plantillas HTML (estática, imagen y vídeo), con soporte para formatos verticales, horizontales y cuadrados, y también permite crear plantillas personalizadas.
Capacidades atómicas combinables: basado en el flujo de trabajo de ComfyUI, se pueden sustituir libremente los modelos de generación de imágenes, los motores TTS o los modelos de generación de vídeo para satisfacer necesidades personalizadas.
Módulo de transferencia de acciones (actualización de enero de 2026): permite transferir los patrones de movimiento de un vídeo de referencia al contenido generado por IA, haciendo que el dinamismo de las escenas sea más natural.
Casos de uso
Operación masiva en redes sociales: ideal para producir en lotes y rápidamente vídeos cortos de分享 de conocimientos, promoción de productos y reseñas en plataformas como TikTok, Xiaohongshu e Instagram Reels.
Pruebas para creadores individuales: los principiantes sin conocimientos técnicos pueden usar el paquete integrado "todo en uno" para Windows y empezar sin necesidad de configurar nada, lo que reduce la barrera de entrada a la creación de vídeo con IA.
Reutilización de material: subiendo fotos o vídeos existentes, la IA analiza automáticamente el contenido y genera locución y comentario, permitiendo pasar del material al vídeo final con un solo clic.
Distribución multilingüe: gracias al TTS multilingüe y a la locución con presentadores virtuales, se pueden generar rápidamente vídeos localizados para distintos mercados regionales.
Modo de uso
Instalación e despliegue
Usuarios de Windows: descarguen el paquete integrado "todo en uno" desde GitHub Releases, descomprímanlo y hagan doble clic en start.bat para abrir la interfaz web.
Usuarios de macOS / Linux: instalen uv y ffmpeg, clonen el repositorio y ejecuten uv run streamlit run web/app.py.
Configuración inicial
Abren http://localhost:8501 en el navegador y desplieguen «⚙️ 系统配置» (Configuración del sistema). Configuren el LLM (elijan el modelo e introduzcan la API Key) y la generación de imágenes (dirección local de ComfyUI o API Key de RunningHub), y hagan clic en guardar.
Generación de vídeo
Introducción de contenido: en la barra lateral izquierda, seleccionen «AI 生成内容» (Generar contenido con IA) e introduzcan un tema, o elijan «固定文案内容» (Contenido de guion fijo) para pegar un guion existente; pueden usar BGM integrado o personalizado.
Configuración de voz: en la barra central, elijan el flujo de trabajo TTS (Edge-TTS / Index-TTS, etc.), pueden subir un audio de referencia para clonar la voz y previsualizar el resultado.
Configuración visual: seleccionen el flujo de trabajo de imagen/vídeo de ComfyUI, definan el tamaño y el prefijo de prompt (en inglés), elijan una plantilla de vídeo y previsualicen.
Renderizado y exportación: hagan clic en «🎬 生成视频» (Generar vídeo), sigan el progreso en tiempo real (guion → imágenes → voz → vídeo) y, al terminar, se reproducirá automáticamente y se guardará en la carpeta output/.
Preguntas frecuentes
P: ¿Cuánto tiempo se necesita la primera vez?
R: Depende del número de escenas, del entorno de red y de la velocidad de inferencia de la IA; normalmente se completa en unos minutos.
P: ¿Qué puedo hacer si no estoy satisfecho con el resultado?
R: Pueden cambiar el modelo LLM para ajustar el estilo del guion; modificar el tamaño de la imagen y el Prompt Prefix para cambiar el estilo visual; cambiar el flujo de trabajo TTS o el audio de referencia para ajustar la locución; y probar distintas plantillas y formatos.
P: ¿Cuál es el coste de uso de Pixelle-Video?
R: El proyecto admite una solución totalmente gratuita: LLM con Ollama (local) + ComfyUI en local = coste cero; la opción recomendada es Tongyi Qianwen (coste de API muy bajo) + ComfyUI local; si se utilizan las soluciones en la nube de OpenAI y RunningHub, el coste será más elevado.
P: ¿Admite plantillas personalizadas?
R: Sí. Los usuarios familiarizados con HTML pueden crear sus propias plantillas en la carpeta templates/; quienes dominen ComfyUI pueden personalizar flujos de trabajo de imagen o TTS en la carpeta workflows/.
Opinión sobre el producto
Pixelle-Video no es un editor de vídeo tradicional, sino una cadena de producción AIGC automatizada de extremo a extremo. Su mayor valor reside en integrar LLM, visión por computador y síntesis de voz en un flujo de trabajo estandarizado, manteniendo al mismo tiempo una gran extensibilidad gracias al diseño modular de ComfyUI. Para los operadores de redes sociales que necesitan producir varios contenidos al día, reduce claramente el ciclo que va desde la elección del tema hasta el vídeo final. Sin embargo, si se busca una calidad cinematográfica o una narrativa compleja, las marcas dejadas por las plantillas generadas automáticamente siguen siendo bastante evidentes y se quedan cortas.
Ventajas:
De código abierto y gratuito (Apache-2.0), se puede ejecutar en local totalmente gratis (Ollama + ComfyUI local).
El paquete "todo en uno" para Windows funciona listo para usar, sin necesidad de configurar el entorno Python.
Flujo de trabajo altamente modular; los modelos y plugins del ecosistema ComfyUI se pueden reutilizar directamente.
Compatible con clonación de voz y presentadores virtuales, cubriendo necesidades de personalización y branding.
Desventajas:
La ejecución local requiere cierto hardware; se recomienda una tarjeta gráfica NVIDIA con al menos 6 GB de VRAM.
La calidad de generación depende de las capacidades de cada modelo de IA; con guiones complejos, aún pueden producirse desajustes entre imagen y texto.
Actualmente está más orientado a vídeos cortos de estructura sencilla; el soporte para vídeos largos o transiciones complejas es limitado.













