
 Asistente de guiones▸
 Apps AI
 Noticias AI
Story-Iter: solución de visualización de historias largas de UCSC-VLAA
Story-Iter: solución de visualización de historias largas de UCSC-VLAAIntroducción
¿Qué es Story-Iter?
Story-Iter es una solución de visualización de historias largas propuesta por UCSC-VLAA. Esta tarea requiere generar secuencias de imágenes coherentes a partir de texto narrativo, admitiendo escenas de historias largas de hasta 100 fotogramas.
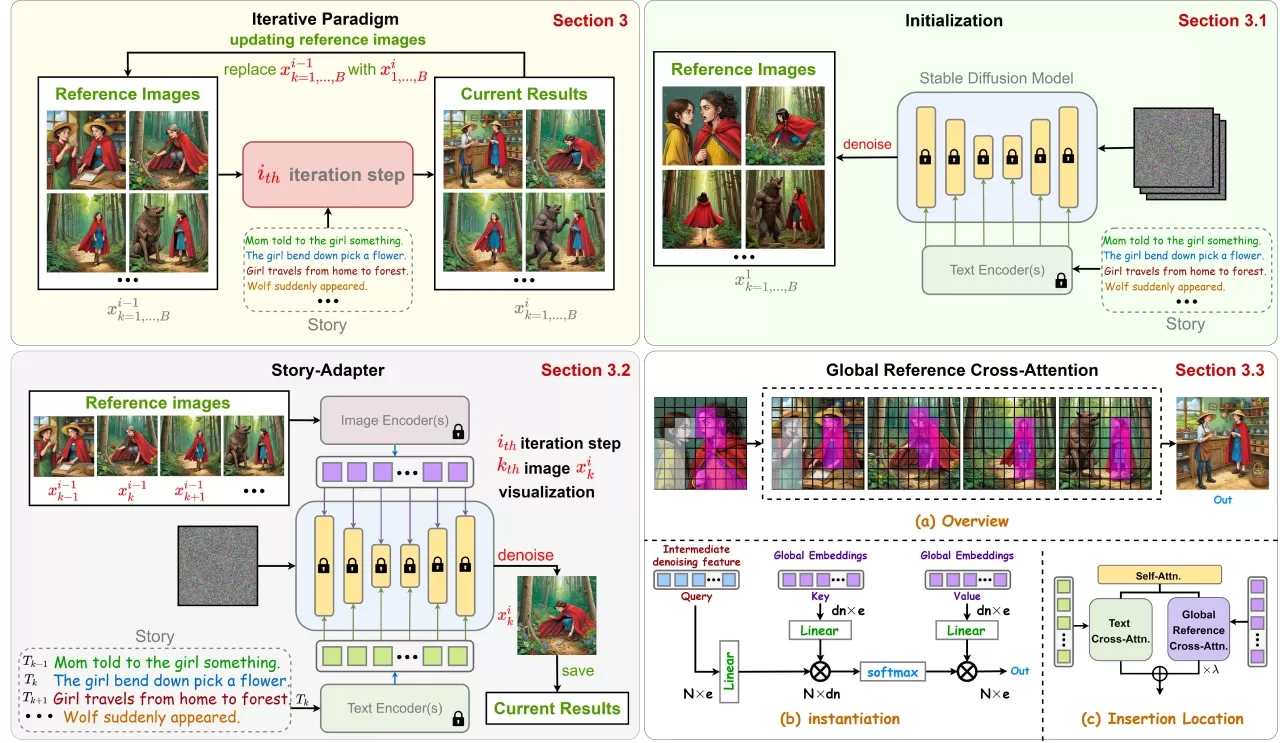
A diferencia de los métodos autorregresivos, Story-Iter adopta un mecanismo de iteración externo: además de los pasos de eliminación de ruido dentro del modelo de difusión, introduce un bucle de iteración adicional que optimiza la calidad de cada fotograma integrando continuamente todas las imágenes de referencia generadas en la ronda anterior.
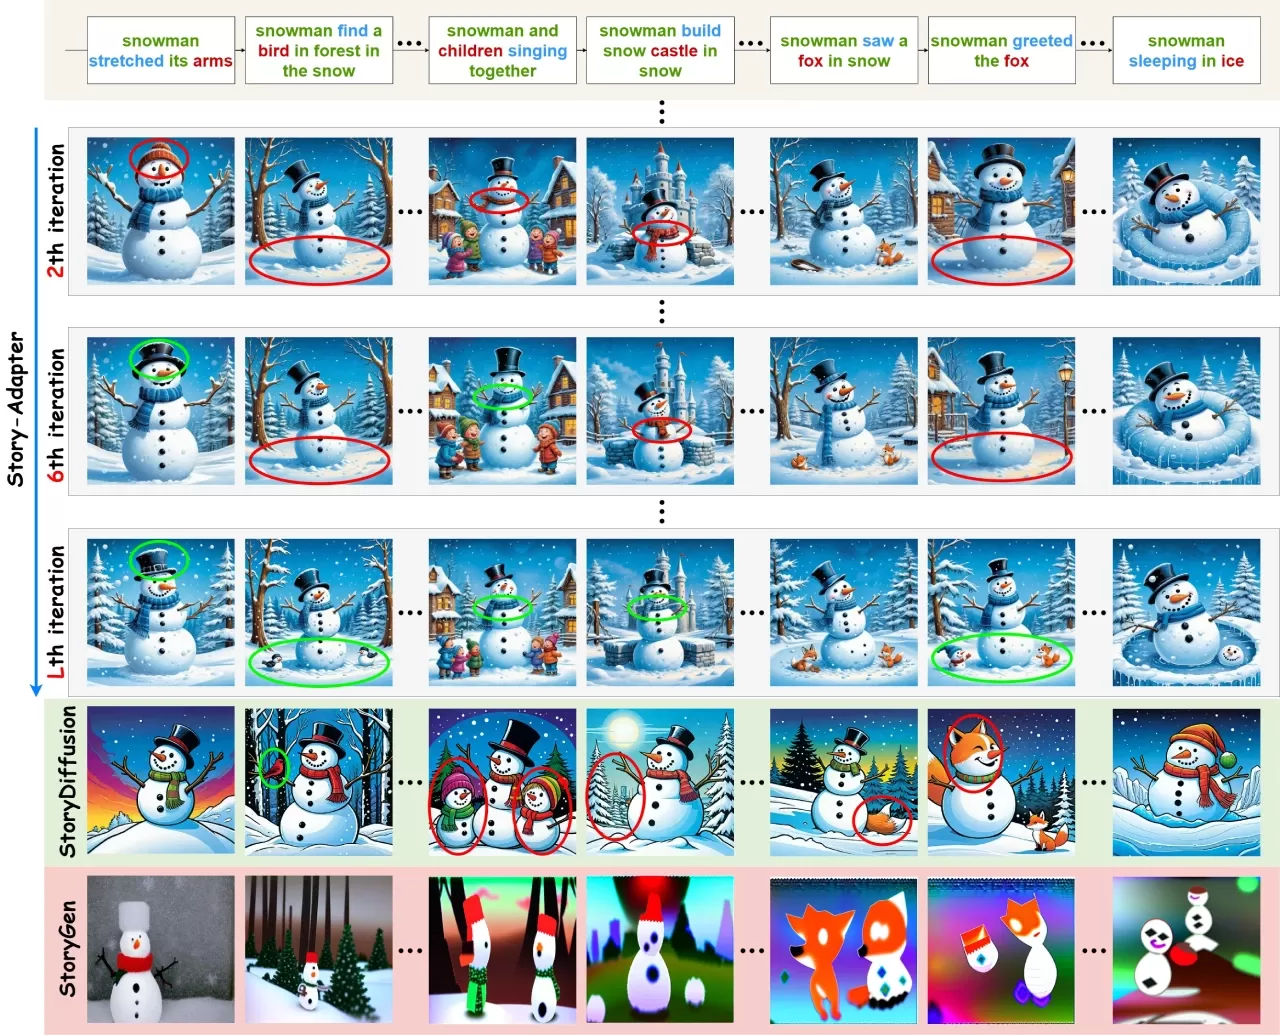
🔧 Características de Story-Iter
1. Módulo de Atención Cruzada de Referencia Global
Plug-and-play: no requiere entrenamiento, se integra directamente en modelos de difusión existentes (como Stable Diffusion)
Embedding global: utiliza embeddings globales para modelar todos los fotogramas de referencia, garantizando la coherencia semántica en secuencias largas
Mecanismo de atención cruzada: agrega el flujo de información de todas las imágenes de referencia durante el proceso de generación de imágenes
2. Paradigma de Optimización Iterativa
Fase de inicialización: genera una versión inicial de cada fotograma basándose en los prompts de texto de la historia
Refinamiento iterativo: utiliza todas las imágenes generadas en la ronda anterior como referencia para la siguiente ronda, optimizando progresivamente
Mejora progresiva: logra una generación precisa de interacciones de grano fino mediante la integración repetida del contexto visual general y las restricciones textuales
3. Soporte de Secuencias Largas
Soporta la generación de secuencias de imágenes de historias largas de hasta 100 fotogramas
Rendimiento excelente en coherencia semántica e interacciones de grano fino
🎯 Escenarios de Aplicación de Story-Iter
Generación de cómics/libros ilustrados: genera automáticamente páginas de cómics coherentes a partir de textos de historias largas
Previsualización de animación: proporciona vistas previas visuales a nivel de storyboard para la producción de animación
Storyboards cinematográficos: ayuda a directores y cineastas a generar rápidamente bocetos de planificación de planos
Libros de cuentos infantiles: crea libros narrativos con ilustraciones enriquecidas para contenido educativo
Creatividad publicitaria: genera historias visuales de secuencias largas para promoción de productos
Cinematicas de juegos: genera narrativas visuales continuas para las tramas de los juegos
✅ Ventajas y Desventajas de Story-Iter
Ventajas
Sin entrenamiento: no requiere entrenamiento ni ajuste fino adicional del modelo, plug-and-play
Eficiencia computacional: menor coste computacional en comparación con métodos que introducen grandes codificadores multimodales
Garantía de coherencia: mantiene eficazmente la coherencia de personajes, escenas y estilos en secuencias largas mediante el mecanismo de referencia global
Interacciones de grano fino: capaz de generar escenas de alta calidad con interacciones complejas entre personajes
Escalabilidad: soporta la generación de historias de hasta 100 fotogramas, muy por encima de los métodos tradicionales
Desventajas
Sobrecarga de iteración: aunque no requiere entrenamiento, el proceso iterativo requiere múltiples inferencias, lo que implica un alto coste de tiempo
Dependencia del modelo base: el rendimiento está limitado por las capacidades del modelo de difusión subyacente (como SD)
Desafío en historias muy largas: a pesar de soportar 100 fotogramas, historias extremadamente largas aún pueden presentar deriva de coherencia
Sin código oficial: el repositorio de GitHub puede no estar completamente público o puede estar en una fase temprana
🛠️ Cómo usar Story-Iter
Preparación del Entorno
# Clonar el repositorio (asumiendo que ya es público)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# Instalar dependencias
pip install -r requirements.txt
Flujo de Uso Básico
Preparar el texto de la historia: dividir la historia en descripciones textuales continuas (cada fotograma corresponde a una descripción)
Generación inicial: ejecutar la primera ronda de generación, produciendo una secuencia inicial de imágenes únicamente basándose en los prompts de texto
Optimización iterativa:
Utilizar las imágenes generadas como referencia para la siguiente ronda de generación
Activar el módulo GRCA para agregar la información de referencia global
Repetir la iteración hasta la convergencia o hasta alcanzar el número preestablecido de iteraciones
Resultado de salida: obtener la secuencia final de imágenes de la historia coherente y optimizada
Parámetros Clave
--num_iterations: número de iteraciones (normalmente con 3-5 iteraciones se observa una mejora notable)
--use_grca: activa el módulo de atención cruzada de referencia global
--num_frames: número de fotogramas de la historia (admite hasta 100 fotogramas)
❓ Preguntas Frecuentes sobre Story-Iter
P1: ¿Cuál es la relación entre Story-Iter y Story-Adapter?
Según la información de arXiv, Story-Iter y Story-Adapter son nombres diferentes para el mismo proyecto. La cita del paper aparece como Story-Adapter: A Training-free Iterative Framework for Long Story Visualization, pero tanto la página del proyecto como el envío a ICLR 2026 utilizan el nombre Story-Iter.
P2: ¿Es necesario entrenar mi propio modelo?
No. Story-Iter es un framework sin entrenamiento (training-free) que puede aplicarse directamente a modelos de Stable Diffusion preentrenados.
P3: ¿Qué modelos base soporta?
Se basa principalmente en la serie de modelos Stable Diffusion (como SD 1.5, SDXL), logrando la extensión de funcionalidad mediante la inserción del módulo GRCA.
P4: ¿Cuánto tiempo se necesita para generar una historia de 100 fotogramas?
El tiempo específico depende de la configuración del hardware y del número de iteraciones. Debido al mecanismo de optimización iterativa, el tiempo total = tiempo de generación de un fotograma × número de fotogramas × número de iteraciones. El uso de una GPU A100 puede acelerar significativamente el proceso.
P5: ¿Cómo se garantiza la coherencia de los personajes?
Mediante el mecanismo de referencia global del módulo GRCA, que agrega la información de todos los fotogramas ya generados en cada iteración, asegurando que la apariencia de los personajes, la vestimenta y los elementos de la escena se mantengan coherentes a lo largo de toda la historia.
📚 Recursos Relacionados
Página del proyecto: https://jwmao1.github.io/storyiter/
Dirección del paper: https://arxiv.org/abs/2410.06244
Repositorio de GitHub: https://github.com/UCSC-VLAA/story-iter
Institución: UCSC-VLAA (Laboratorio de Lenguaje Visual e Inteligencia Artificial de la Universidad de California, Santa Cruz)














