
 Asistente de guiones▸
 Apps AI
 Noticias AI
Spark-TTS: sistema TTS eficiente con clonación de voz zero-shot y síntesis multilingüe
Spark-TTS: sistema TTS eficiente con clonación de voz zero-shot y síntesis multilingüeIntroducción
¿Qué es Spark-TTS?
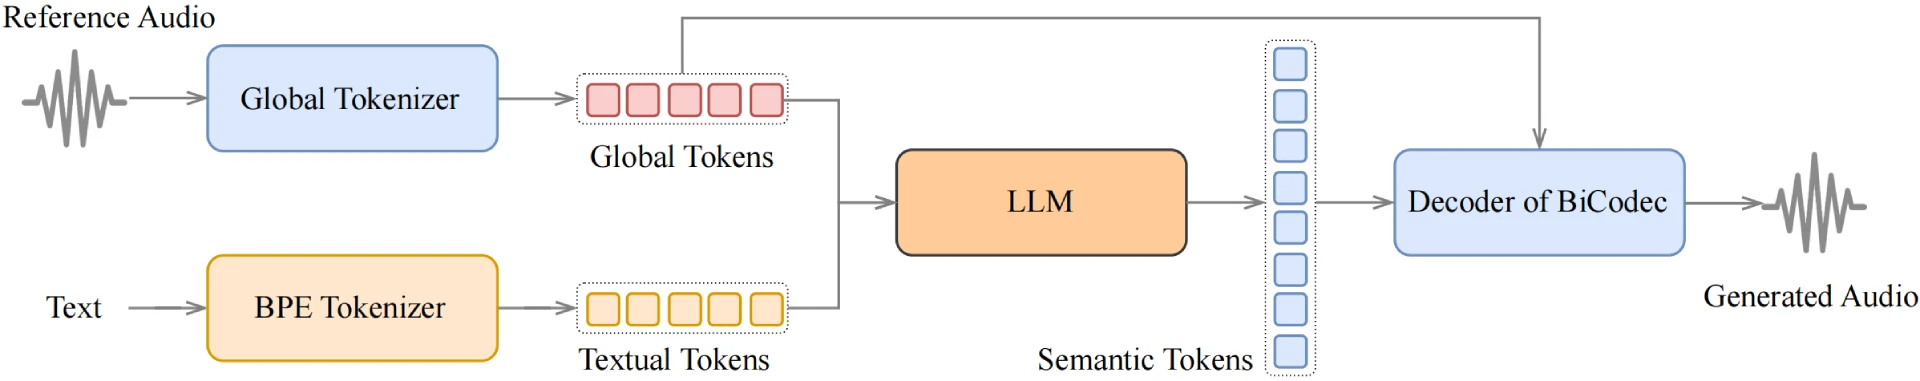
Spark-TTS es un sistema de texto a voz (TTS) desarrollado por el equipo SparkAudio, construido sobre Qwen2.5, que controla directamente el tono, la velocidad y el estilo del hablante desde el texto. Admite clonación de voz sin ejemplos previos, síntesis multilingüe, control de voz de alta granularidad y generación de voz mediante una interfaz web, siendo capaz de convertir texto en contenido de voz natural y de alta calidad de forma rápida. A diferencia de los sistemas TTS tradicionales, reconstruye el audio directamente a partir de las codificaciones predichas por el LLM, lo que simplifica el proceso de generación de voz y mejora la eficiencia.
Funciones principales de Spark-TTS
Clonación de voz sin ejemplos previos: Spark-TTS admite la clonación de voz sin ejemplos previos, lo que permite replicar la voz de un hablante incluso sin datos de entrenamiento específicos de ese hablante. En escenarios multilingües y de cambio de código, destaca por cambiar sin problemas entre distintos idiomas y hablantes.
Soporte multilingüe: el sistema admite chino e inglés, manteniendo un alto grado de naturalidad y precisión en la síntesis entre idiomas. Los usuarios pueden introducir texto en un idioma y obtener salida de voz en otro.
Control de voz de alta granularidad: los usuarios pueden personalizar la voz del hablante virtual ajustando parámetros como el género, el tono y la velocidad, satisfaciendo así las necesidades de contenido de voz diverso en escenarios como presentadores virtuales y audiolibros.
Síntesis de voz eficiente: Spark-TTS se basa completamente en la arquitectura Qwen2.5, sin necesidad de modelos generativos adicionales, y reconstruye el audio directamente a partir de las codificaciones predichas por el LLM, lo que simplifica el proceso y reduce la complejidad.
Creación de hablantes virtuales: los usuarios pueden crear sus propios hablantes virtuales y dotarlos de un estilo de voz único ajustando parámetros.
Arquitectura técnica de Spark-TTS
La base técnica de Spark-TTS es el códec de voz de flujo único BiCodec, que descompone la voz en tokens semánticos de baja tasa de bits (responsables del contenido lingüístico) y tokens globales de longitud fija (responsables de los atributos del hablante). Esta separación facilita el ajuste flexible de las características de la voz y, combinada con la técnica Chain-of-Thought de Qwen2.5, mejora aún más la calidad y la controlabilidad de la generación de voz.
Casos de uso de Spark-TTS
Producción de audiolibros: su calidad de voz natural es especialmente adecuada para audiolibros.
Presentadores virtuales: permite generar hablantes virtuales que se ajustan a necesidades específicas ajustando los parámetros de voz.
Síntesis de voz multilingüe: admite varios idiomas, lo que amplía su aplicabilidad a nivel mundial.
Instalación y uso de Spark-TTS
1. Preparación del entorno
Instalar Python: asegúrese de tener instalado Python 3.12.
Instalar Conda: se utiliza para gestionar entornos virtuales y puede descargarse e instalarse desde el sitio web oficial de Miniconda.
2. Clonar el repositorio
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. Instalar dependencias
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
Si se encuentra en China continental, puede utilizar el镜像 de Alibaba Cloud:
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. Descargar los modelos preentrenados
Descargue los modelos preentrenados con el siguiente comando:
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5. Uso básico
Ejecute el siguiente comando para realizar la síntesis de voz:
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Uso de la interfaz web
python webui.py --device 0
Repositorio de GitHub:https://github.com/SparkAudio/Spark-TTS
Biblioteca de modelos en HuggingFace: https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
Artículo:https://arxiv.org/pdf/2503.01710
Demo:https://sparkaudio.github.io/spark-tts/
Noticias relacionadas:
Octave: un modelo TTS publicado por Hume AI, con conciencia del contexto y adaptación emocional
Zonos-TTS: modelo de texto a voz multilingüe que admite clonación de voz y control emocional
llasa 3B TTS: modelo de texto a voz (TTS) basado en la arquitectura LLaMA














