Asistente de guiones▸
 Apps AI
 Noticias AI

混元hunyuan-TurboS: el modelo de respuesta rápida lanzado por Tencent que responde al instante
混元hunyuan-TurboS: el modelo de respuesta rápida lanzado por Tencent que responde al instanteIntroducción
¿Qué es Hunyuan-TurboS?
Hunyuan-TurboS es el nuevo modelo de pensamiento rápido presentado por Tencent. A diferencia de los modelos de pensamiento lento como Deepseek R1 o Hunyuan T1, que necesitan "pensar antes de responder", Hunyuan-TurboS es capaz de responder de forma instantánea, duplicando la velocidad de respuesta respecto a la generación anterior y reduciendo la latencia del primer token en un 44%. En cuanto al precio, el modelo optimizado permite una generación de contenido fluida al instante, siendo adecuado para múltiples aplicaciones como conocimiento, matemáticas y creación. Tencent tiene previsto lanzar progresivamente las integraciones de productos correspondientes, como por ejemplo "Tencent Yuanbao", que próximamente entrará en fase de pruebas limitada (灰度).
Características y funciones de Hunyuan-TurboS
Respuesta rápida: su capacidad de "respuesta instantánea" mejora notablemente la experiencia del usuario. En comparación con la generación anterior, la velocidad de generación de texto se duplica y la latencia del primer token se reduce un 44%, con una interacción rápida y fluida.
Salida de alta calidad: además de ser rápido, el contenido generado es de alta calidad, con información precisa y lógica clara incluso cuando se genera texto a gran velocidad.
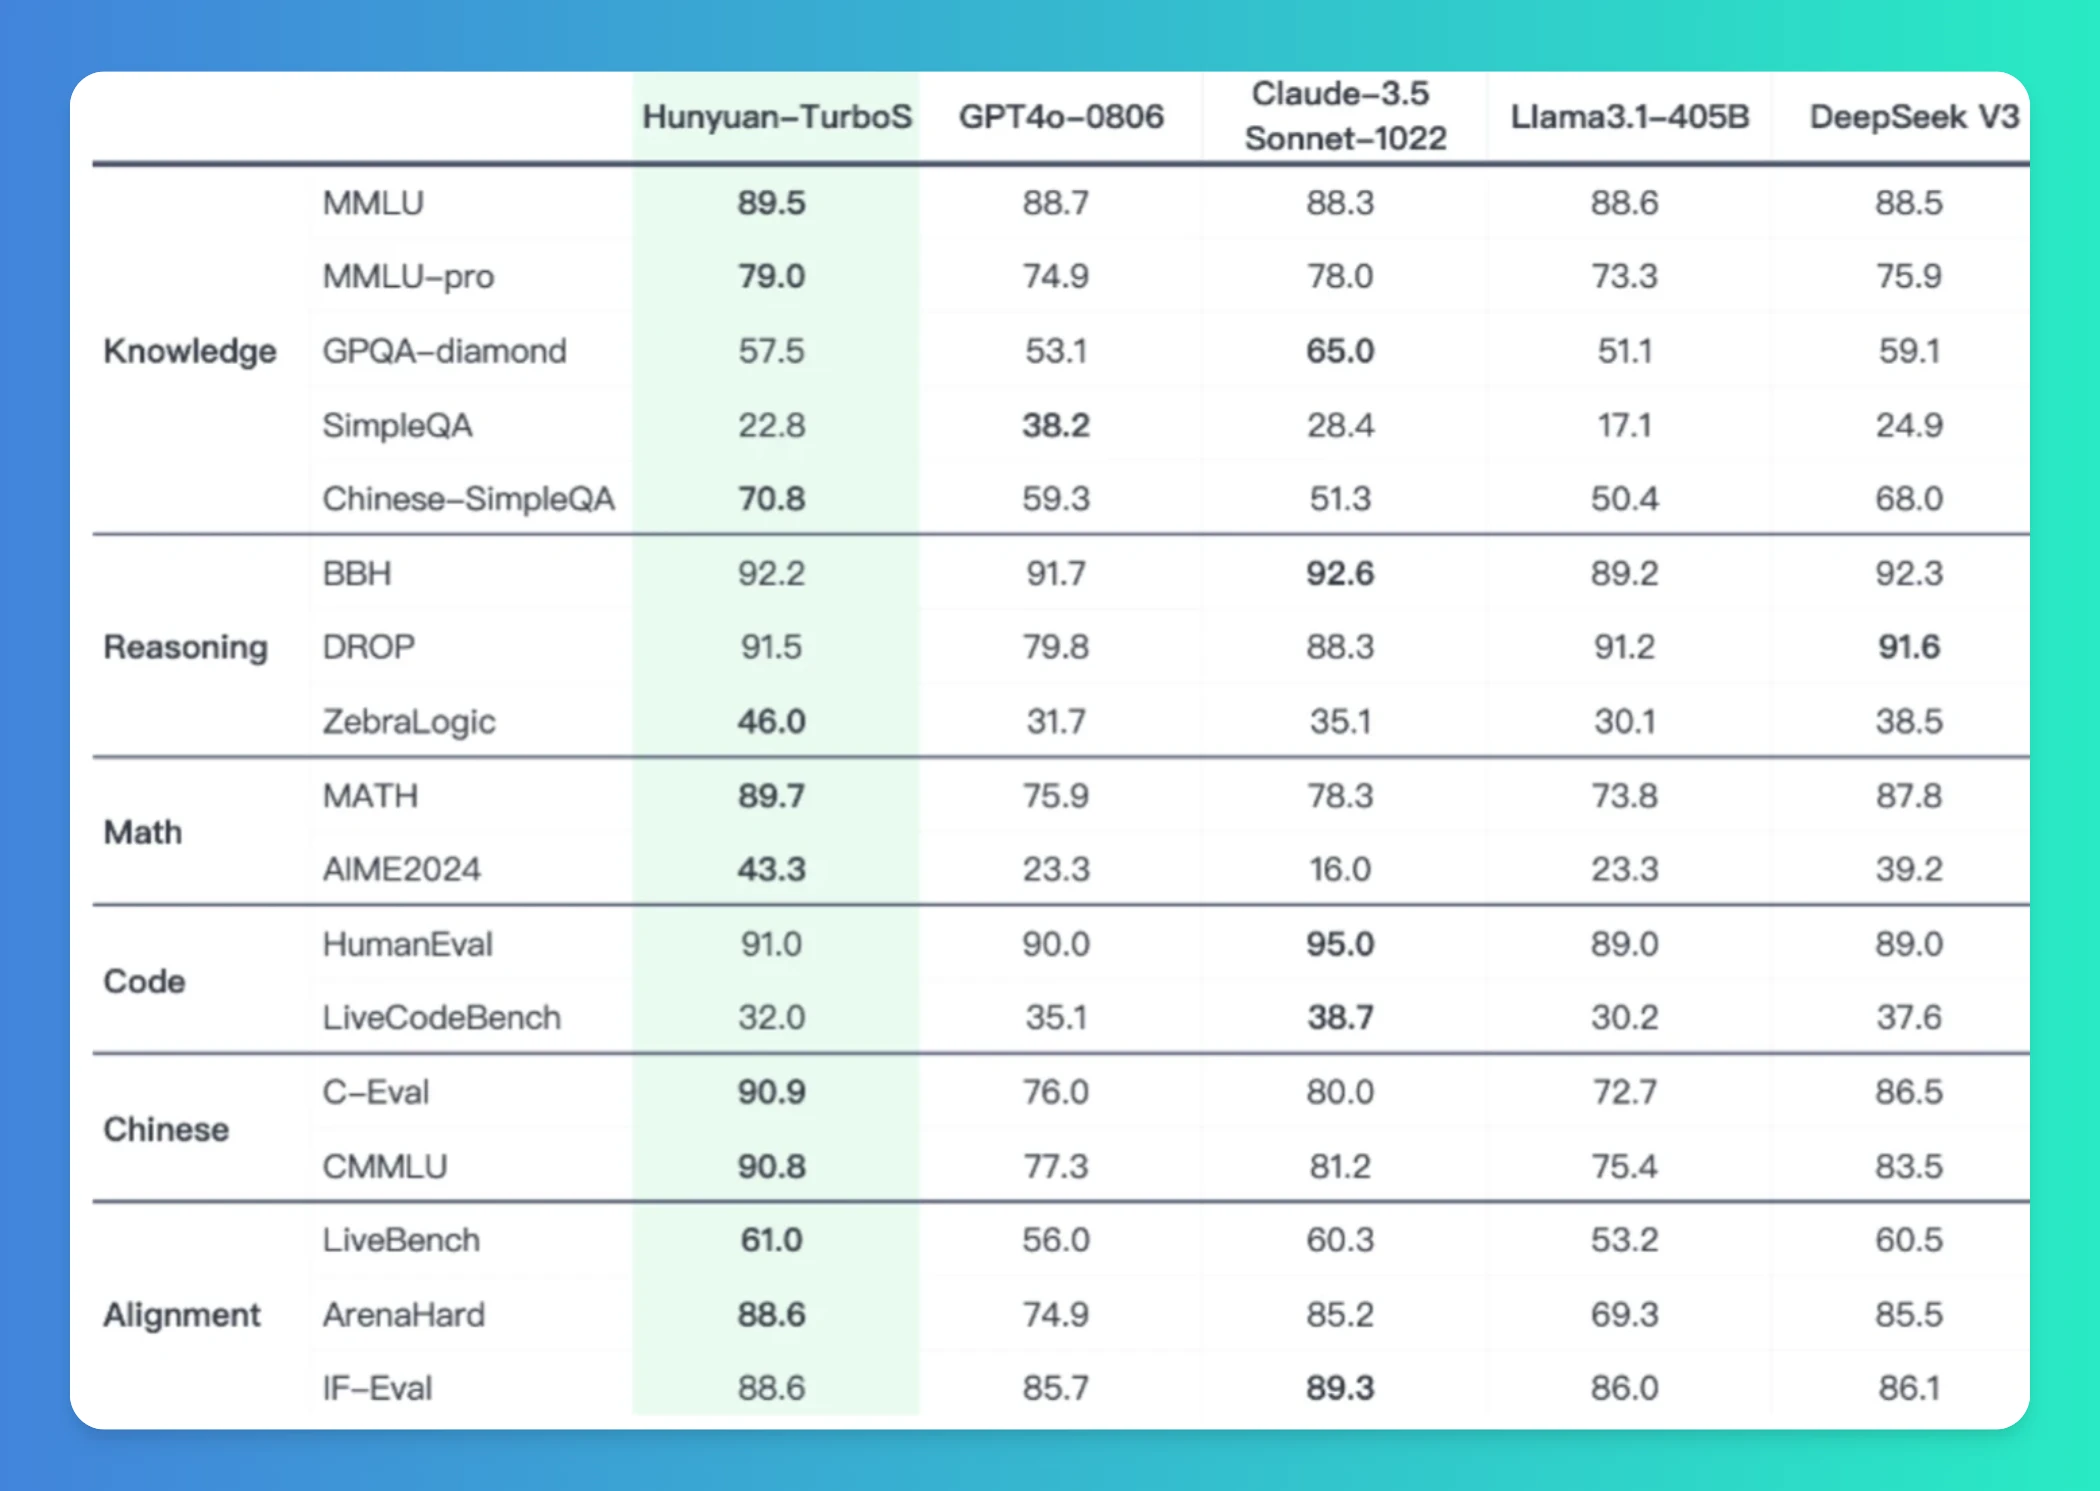
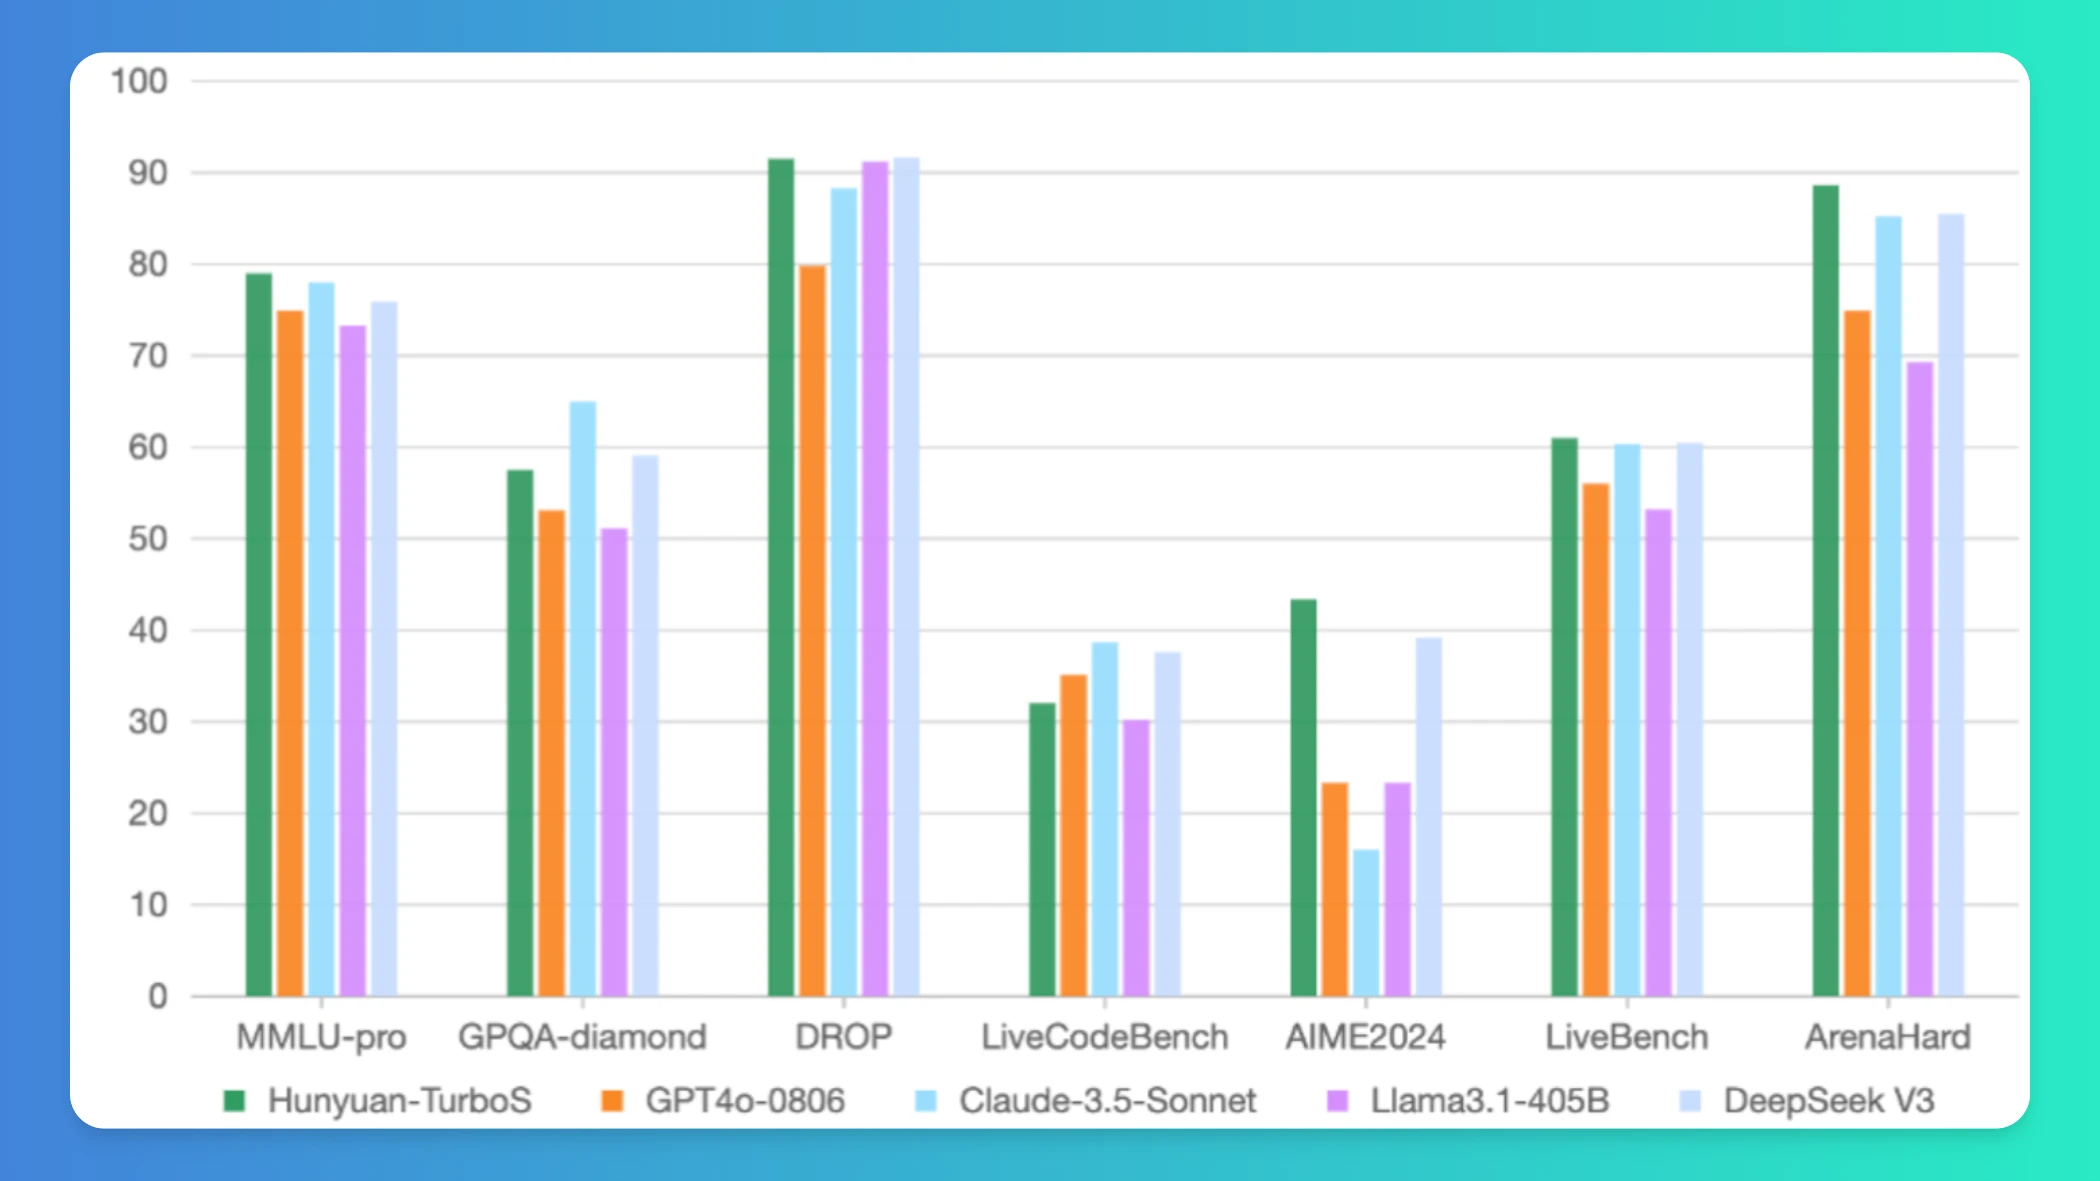
Destaca en múltiples ámbitos: sobresale en preguntas de conocimiento, razonamiento matemático, generación de código de programación y otras áreas, sin envidiar a modelos de primer nivel como DeepSeek V3 o GPT-4o, e incluso superándolos en ciertos aspectos.
Arquitectura con ventajas: la arquitectura Hybrid-Mamba-Transformer combina Mamba y Transformer, optimizando la eficiencia de cálculo y el uso de memoria, reduciendo los costes de entrenamiento e inferencia, y ofreciendo una mayor capacidad para procesar textos de secuencias largas y relaciones de contexto complejas.
Aplicaciones versátiles: se puede utilizar en escenarios como conversaciones cotidianas, creación de contenidos, consultas de información, tutoría educativa y asistencia en programación, dando servicio a distintos usuarios a través de la API de Tencent Cloud y de la aplicación Tencent Yuanbao.
Construcción de un ecosistema: como núcleo de la serie Hunyuan, permite el desarrollo de modelos derivados, como el modelo T1 que combina pensamiento profundo, ofreciendo a los usuarios una solución completa de capacidades de ia.
Innovación arquitectónica: adopta la arquitectura Hybrid-Mamba-Transformer, integrando las ventajas técnicas, reduciendo la complejidad computacional de los modelos Transformer tradicionales, disminuyendo el uso de KV-Cache, mejorando la eficiencia de cálculo y reduciendo los costes de despliegue.
Precio competitivo: la tarifa de Turbo S es muy competitiva, con 0,8 yuanes por millón de tokens de entrada y 2 yuanes por millón de tokens de salida, varias veces más económica que el modelo Hunyuan Turbo anterior.
Razonamiento más inteligente: Hunyuan Turbo S destaca en los ámbitos de matemáticas y razonamiento lógico; el pensamiento rápido permite emitir juicios precisos en poco tiempo y, combinado con las ventajas de los modelos de pensamiento lento, mejora la estabilidad y precisión generales del razonamiento.
Innovación tecnológica de Hunyuan-TurboS
Arquitectura Hybrid-Mamba-Transformer: combina la capacidad de la arquitectura Mamba para procesar secuencias largas de forma eficiente con la ventaja del Transformer para capturar contextos complejos, creando una arquitectura híbrida con un uso óptimo de memoria y de recursos de cálculo.
Fusión de cadenas de pensamiento largas y cortas: mediante la introducción de cadenas de pensamiento largas, aumento de recuperación y aprendizaje por refuerzo, se mejora significativamente la capacidad de razonamiento en ciencias, logrando una mejora global del rendimiento del modelo.
Escenarios de aplicación de Hunyuan-TurboS
Escenarios sociales: ofrece un asistente inteligente instantáneo en los chats grupales de WeChat, con una velocidad de generación de contenido para el Momento (朋友圈) cercana a la de una persona escribiendo.
Escenarios comerciales: reduce el tiempo de respuesta de la atención al cliente en e-commerce y permite autocompletar descripciones de parámetros y código de ejemplo en el desarrollo de software.
Producción de contenidos: cuando los creadores de medios propios utilizan Yuanbao, el tiempo del flujo de trabajo completo, desde introducir las palabras clave del tema hasta generar el esquema, sugerencias de imágenes y títulos virales, se reduce considerablemente.
¿Cómo utilizar Hunyuan-TurboS?
Llamada a la API: desarrolladores y usuarios empresariales pueden llamar a Hunyuan-TurboS a través de la API de Tencent Cloud.
Tencent Yuanbao: los usuarios normales pueden usarlo en Tencent Yuanbao seleccionando el modelo "Hunyuan" y desactivando el pensamiento profundo.