
 Asistente de guiones▸
 Apps AI
 Noticias AI

MakeAnything: modelo de generación de secuencias de imágenes consistentes
MakeAnything: modelo de generación de secuencias de imágenes consistentesIntroducción
MakeAnything es un modelo de generación de secuencias basado en Transformadores de Difusión (Diffusion Transformers) desarrollado por la Universidad Nacional de Singapur, capaz de generar secuencias de imágenes a partir de descripciones de texto y, gracias a su potente capacidad de generación, ofrece rompecabezas de múltiples subimágenes con coherencia visual.
Características de MakeAnything:
Difusión Transformer: Aprovecha el excelente rendimiento de los Transformadores de Difusión para generar imágenes complejas.
Texto a imagen: Admite la conversión de descripciones de texto en imágenes de diversos estilos, mejorando los resultados de generación mediante el entrenamiento y el uso de prompts.
Coherencia entre subimágenes: Garantiza que las múltiples subimágenes generadas durante el proceso de creación de imágenes mantengan coherencia visual entre sí.
Aspectos técnicos de MakeAnything:
Este modelo combina la técnica de Adaptación de Rango Bajo Asimétrica (LoRA) con el modelo ReCraft, lo que hace que el proceso de generación sea más eficiente y permite convertir imágenes estáticas en flujos de creación interpretables, permitiendo al usuario comprender claramente cada paso. De esta manera, se resuelve el problema de mantener la coherencia lógica y visual al generar secuencias de múltiples pasos.
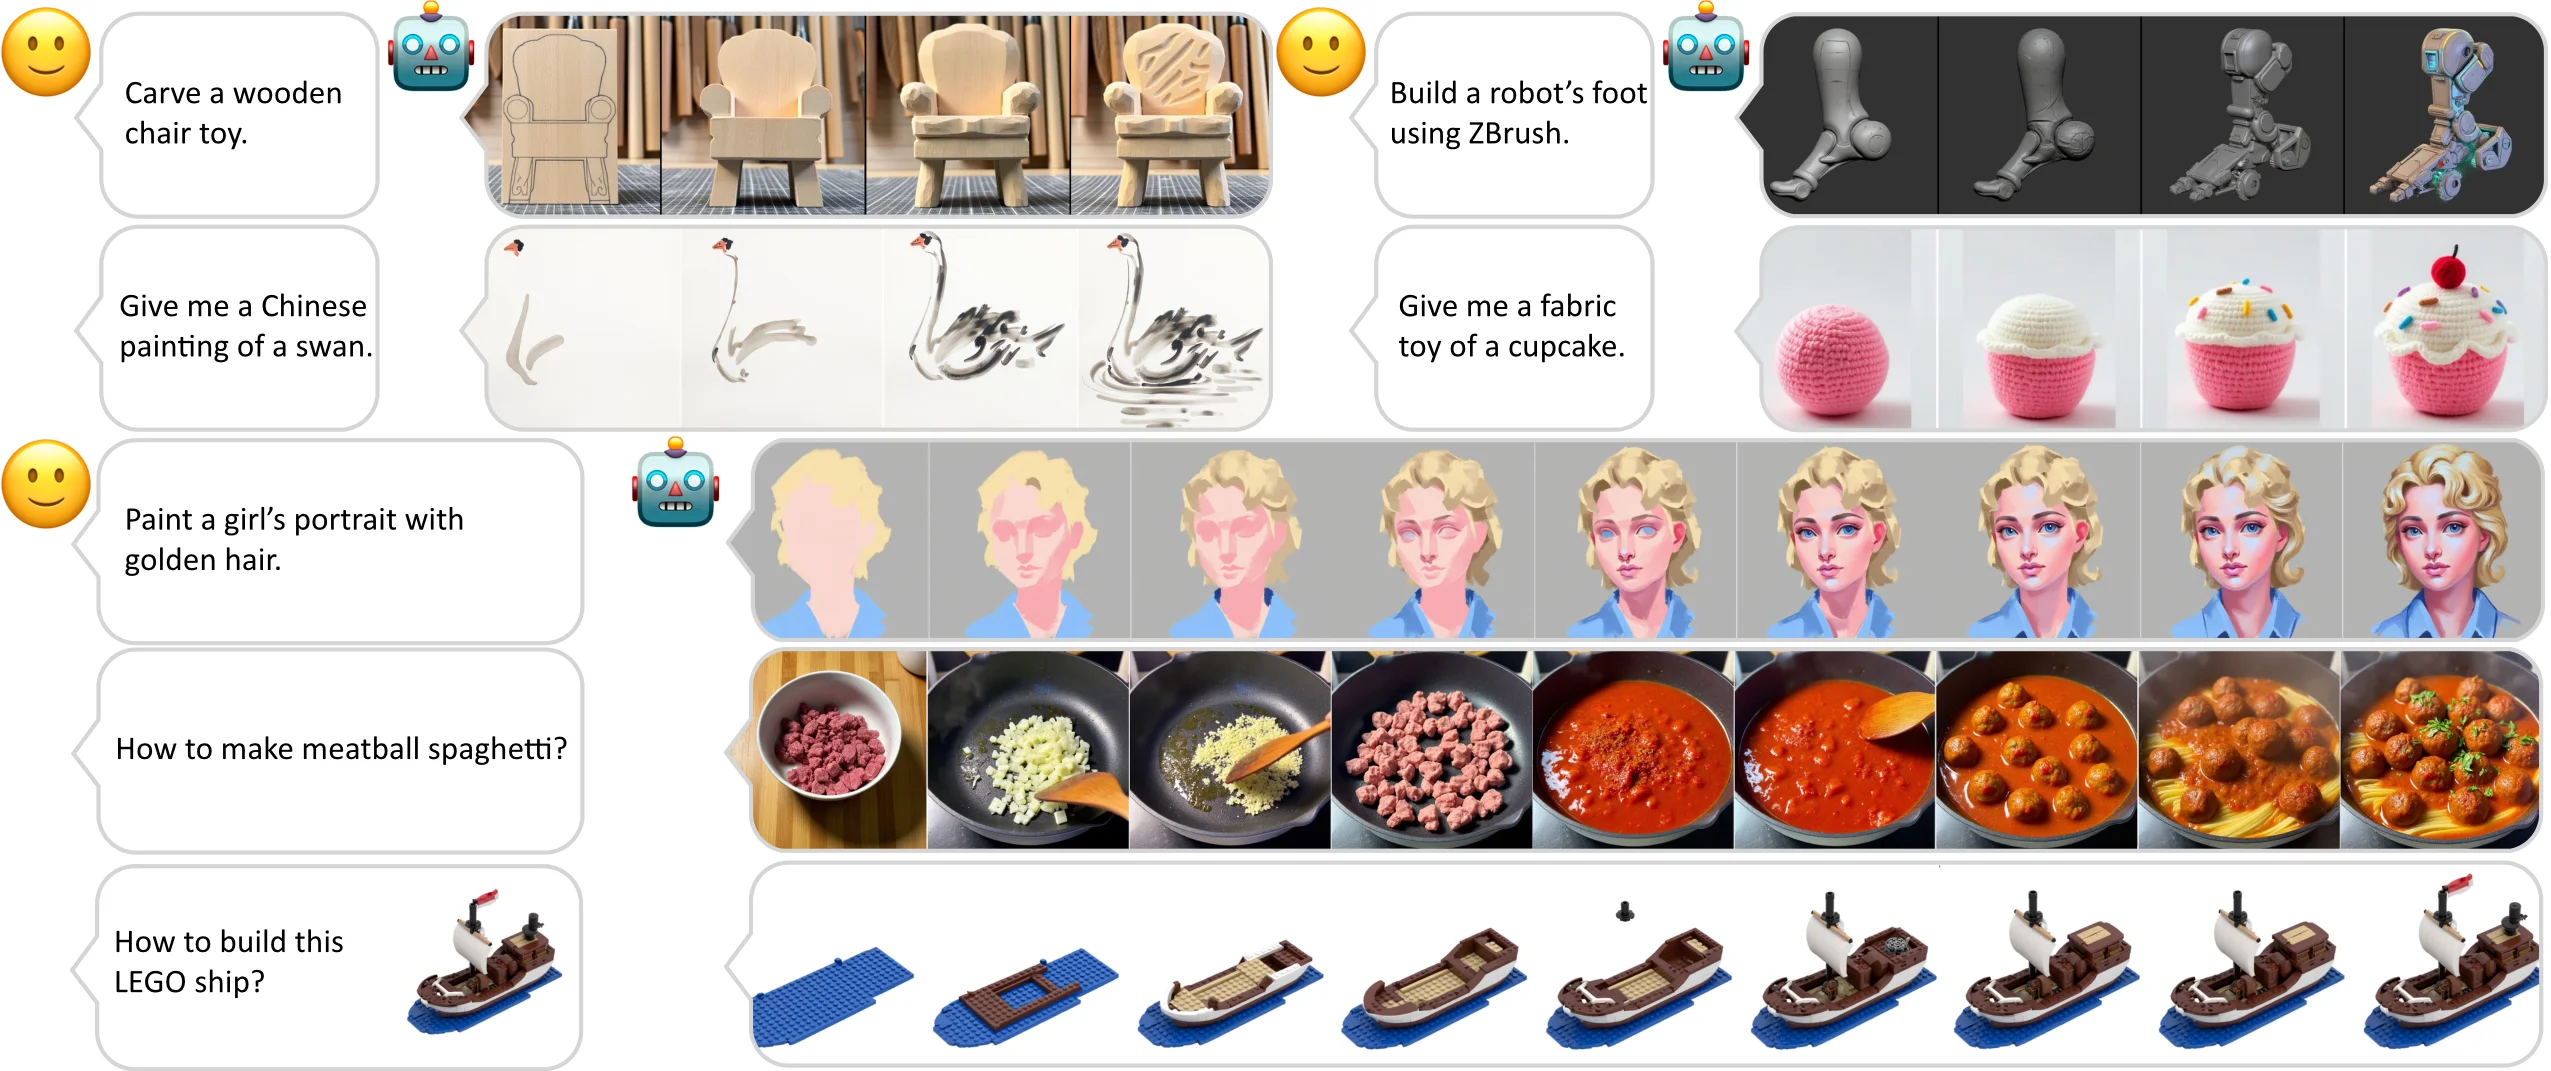
Pasos de uso de MakeAnything:
Preparar los datos de entrenamiento: Preparar un conjunto de datos de texto e imágenes según los requisitos de la tarea, lo que generalmente implica limpieza de datos y organización de formatos.
Entrenamiento del modelo: Utilizar el método LoRA asimétrico para entrenar en el conjunto de datos de MakeAnything, ajustando el modelo para mejorar su capacidad de generación.
Generación de contenido: Tras finalizar el entrenamiento, el usuario puede introducir prompts de texto y el modelo generará las imágenes y otros contenidos multimodales correspondientes.
Postprocesado: El contenido generado puede optimizarse aún más en la fase de postprocesado, por ejemplo ajustando los colores o añadiendo detalles, para adaptarlo mejor a las necesidades del usuario.
Ámbitos de aplicación de MakeAnything:
Diseño de esculturas: Se utiliza para generar bocetos y modelos 3D de diseños de esculturas.
Creación pictórica: Se aplica en la pintura artística automatizada, aportando nuevas inspiraciones a los creadores.
Transformación de automóviles: En el ámbito del diseño automotriz, permite lograr efectos de transformación con diferentes perspectivas y estilos.
Artesanía y bricolage: Los usuarios pueden generar guías paso a paso que abarcan diversas técnicas de artesanía para llevar a cabo tareas prácticas.
Cocina y recetas: Puede generar pasos de cocina detallados para ayudar a los usuarios a aprender el proceso de elaboración de platos complejos.
Github:https://github.com/showlab/MakeAnything














