
 Asistente de guiones▸
 Apps AI
 Noticias AI
FireRedASR: modelo de reconocimiento de voz de código abierto de Xiaohongshu
FireRedASR: modelo de reconocimiento de voz de código abierto de XiaohongshuIntroducción
FireRedASR es un modelo de reconocimiento de voz basado en modelos de lenguaje grandes, publicado y liberado como código abierto por el equipo FireRed de Xiaohongshu el 9 de febrero de 2025. Ha alcanzado un nuevo SOTA en el campo del reconocimiento de voz en mandarín (tasa de error de caracteres CER del 3,05%) y admite el reconocimiento de dialectos, inglés y letras de canciones.
Funciones principales de FireRedASR:
Reconocimiento de voz de alta precisión: FireRedASR-LLM (8,3B parámetros) logró una tasa de error de caracteres (CER) del 3,05% en conjuntos de prueba públicos, convirtiéndose en el nuevo SOTA, reduciendo la tasa de error en un 8,4% en comparación con el anterior modelo SOTA Seed-ASR (más de 12B parámetros).
Inferencia eficiente: FireRedASR-AED (1,1B parámetros) mejora significativamente la eficiencia de inferencia manteniendo una alta exactitud, con un CER del 3,18%.
Adaptación a múltiples escenarios: FireRedASR tiene un rendimiento excelente en diversos escenarios cotidianos como vídeos cortos, transmisiones en vivo, entrada de voz y asistentes inteligentes, con una CER relativa reducida entre un 23,7% y un 40,0% en comparación con los principales proveedores de servicios de ASR del sector y Paraformer-Large.
Capacidad de reconocimiento de letras de canciones: en escenarios que requieren reconocimiento de letras de canciones, FireRedASR-LLM logró una reducción relativa del CER del 50,2% al 66,7%, demostrando una gran capacidad de adaptación.
Soporte multilingüe: FireRedASR admite mandarín y tiene un rendimiento excelente en el reconocimiento de dialectos chinos y voz en inglés, ampliando aún más su ámbito de aplicación.
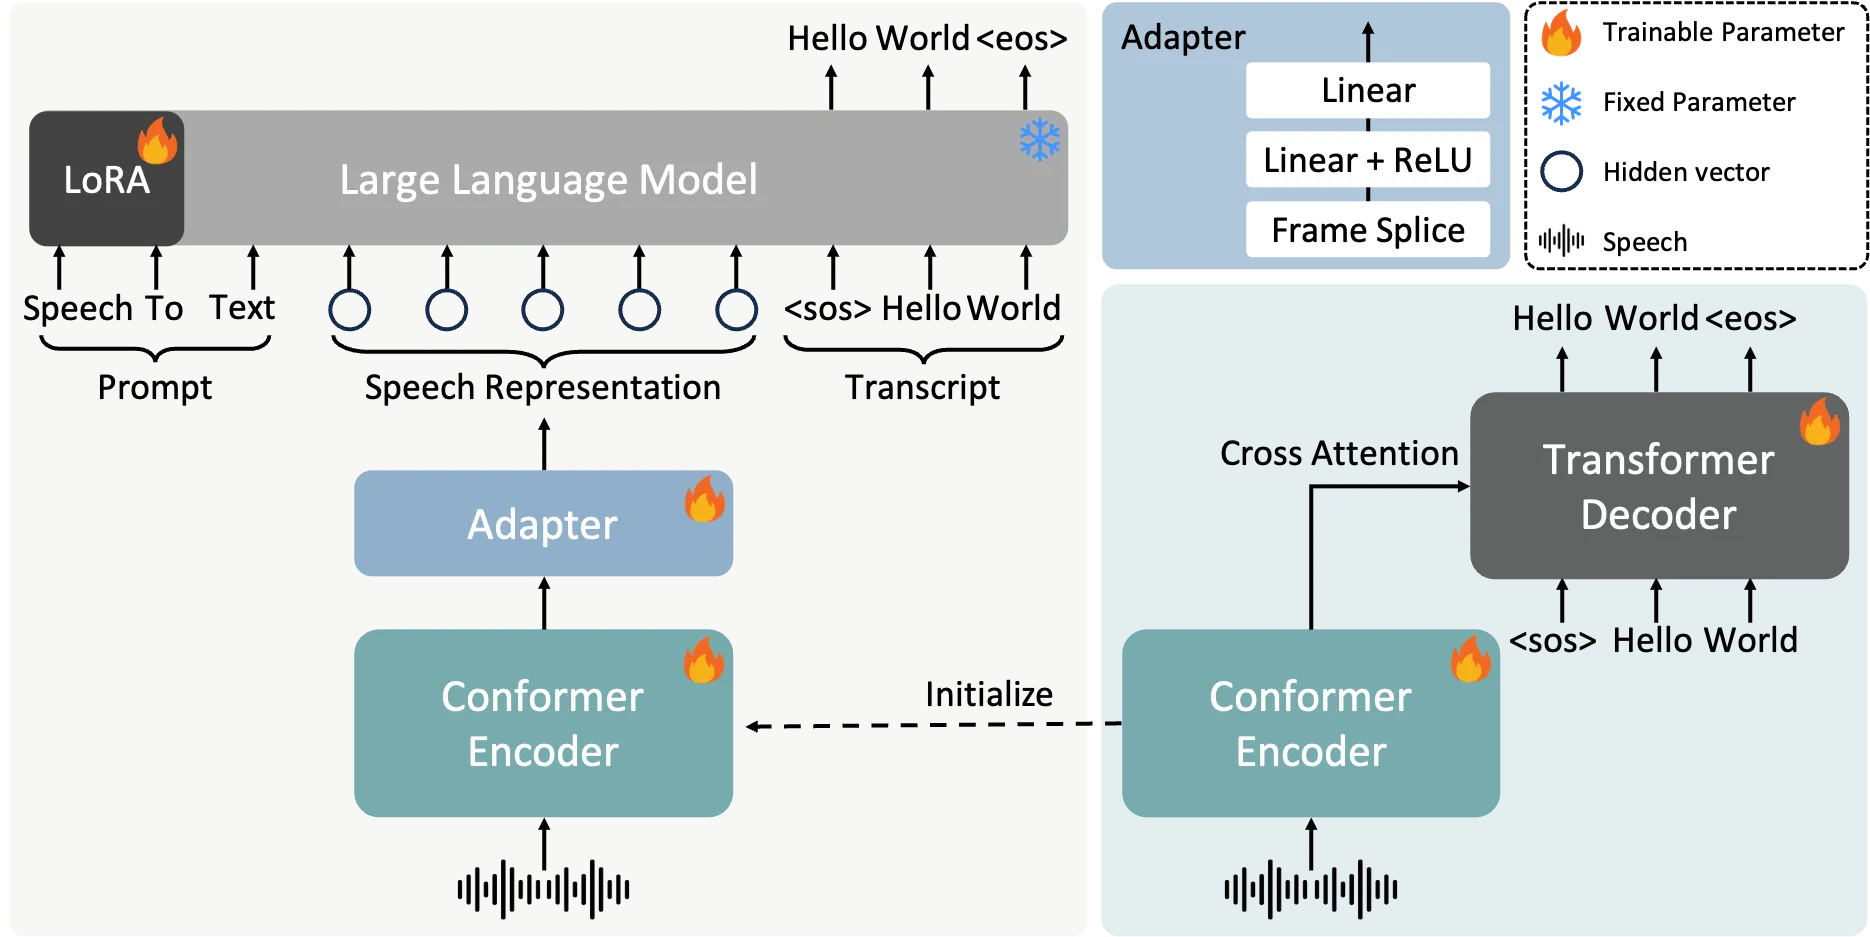
Dos versiones principales del modelo FireRedASR:
FireRedASR-LLM
Arquitectura: adopta el marco Encoder-Adapter-LLM, combinado con el modelo de lenguaje grande Qwen2-7B-Instruct, e implementa interacción de voz de extremo a extremo mediante ajuste fino con LoRA.
Rendimiento: CER del 3,05% en pruebas de referencia de mandarín, con una reducción del 8,4% en la tasa de error respecto al anterior modelo SOTA; reducción relativa del CER del 50,2% al 66,7% en escenarios de reconocimiento de letras de canciones.
Características: 8,3B de parámetros, centrado en la máxima precisión, adecuado para escenarios exigentes como la generación de subtítulos profesional.
FireRedASR-AED
Arquitectura: basado en un codificador-decodificador con atención (codificador Conformer + decodificador Transformer), con 1,1B de parámetros.
Rendimiento: CER del 3,18%, superior al Seed-ASR de 12B parámetros, con mayor eficiencia de inferencia.
Características: equilibra la exactitud y la eficiencia computacional, adecuado para aplicaciones en tiempo real como subtítulos en transmisiones en vivo y asistentes de voz.
Aspectos técnicos destacados de FireRedASR:
Adaptación a múltiples escenarios: en escenarios cotidianos como vídeos cortos y transmisiones en vivo, la CER se reduce relativamente entre un 23,7% y un 40,0%; admite dialectos chinos e inglés.
Ecosistema de código abierto: los modelos y el código ya son de código abierto (GitHub), con un diseño de nivel industrial que admite el desarrollo secundario por parte de la comunidad.
Estrategia de entrenamiento: la versión LLM fija la mayoría de los parámetros y solo entrena el codificador y el adaptador, conservando las capacidades del preentrenamiento.
Escenarios de aplicación de FireRedASR
Interacción inteligente por voz: FireRedASR puede aplicarse en escenarios como asistentes de voz inteligentes y métodos de entrada por voz, proporcionando servicios de reconocimiento de voz de alta precisión.
Comprensión de contenido multimedia: FireRedASR tiene un rendimiento excelente en escenarios de comprensión de contenido multimedia como la generación de subtítulos de vídeo y el reconocimiento de letras de canciones.
Aplicaciones en escenarios cotidianos: FireRedASR destaca en diversos escenarios cotidianos como vídeos cortos, transmisiones en vivo, entrada de voz y asistentes inteligentes, con una CER relativa reducida entre un 23,7% y un 40,0% en comparación con los principales proveedores de servicios de ASR del sector y Paraformer-Large.
Enlaces relacionados con FireRedASR:
Dirección del proyecto: https://github.com/FireRedTeam/FireRedASR
Dirección del artículo: https://arxiv.org/abs/2501.14350














