
 Asistente de guiones▸
 Apps AI
 Noticias AI
JoyGen: framework de generación de vídeo 3D de rostros hablantes impulsado por audio
JoyGen: framework de generación de vídeo 3D de rostros hablantes impulsado por audioIntroducción
JoyGen es un marco de generación de vídeo de caras parlantes en 3D impulsado por audio, desarrollado en colaboración entre JD Technology y la Universidad de Hong Kong. Se trata de un novedoso marco de dos fases cuya tecnología consiste en utilizar la entrada de audio para dirigir un modelo 3D con percepción de profundidad, proporcionando una sincronización precisa entre los labios y el audio, con el fin de simular con precisión los movimientos de los labios y las expresiones faciales del hablante, haciendo que el vídeo generado sea más realista. Se aplica principalmente en los campos de la edición de vídeo y la interacción virtual.
JoyGen se ha entrenado con un conjunto de datos de caras parlantes en chino que contiene 130 horas de vídeo de alta calidad. Este conjunto de datos, combinado con el HDTF abierto (conjunto de datos de mapas de profundidad de alta resolución), admite entradas en chino e inglés.
Además, JoyGen también tiene en cuenta las características emocionales del audio, lo que le permite representar de forma natural los cambios emocionales del personaje en la animación generada, como sonrisas o ceños fruncidos, entre otros. Es realmente potente.
Funciones principales de JoyGen:
Soporte multilingüe: JoyGen es capaz de procesar entradas de audio en varios idiomas, como chino e inglés.
Alta calidad visual: mediante un procesamiento detallado de las expresiones faciales y de los labios, los vídeos generados son extremadamente realistas.
Sincronización labial precisa: gracias al análisis de características de audio y a la tecnología de mapas de profundidad facial, los movimientos de los labios del personaje en el vídeo se corresponden a la perfección con el contenido del audio.
Optimización de la edición de vídeo: no solo genera nuevos vídeos, sino que también permite editar los movimientos de los labios en vídeos existentes, sin necesidad de producir de nuevo toda la secuencia de vídeo desde cero.
Arquitectura técnica eficiente: adopta una arquitectura UNet de un solo paso, lo que simplifica enormemente el flujo de trabajo de edición de vídeo.
Principios técnicos:
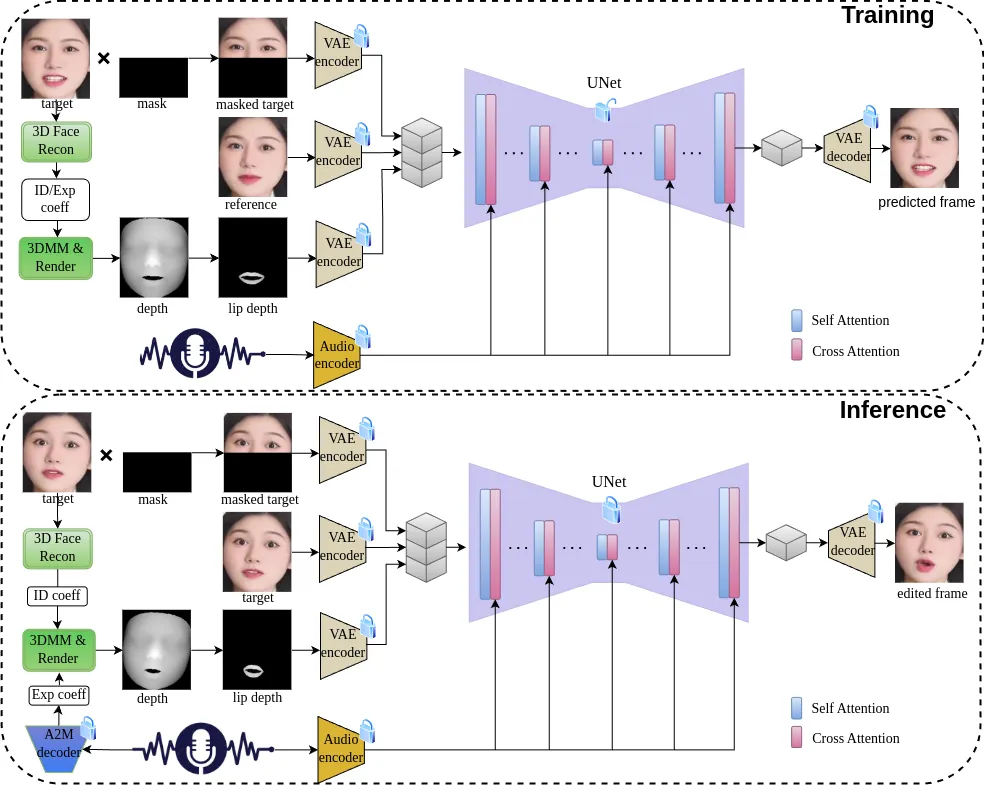
1. Generación de movimientos labiales impulsada por audio:
Se utiliza un modelo de reconstrucción 3D para extraer las características de identidad a partir de las imágenes faciales, definiendo la estructura facial única de cada persona.
A través de un modelo de audio a movimiento, la señal de audio se convierte en coeficientes de expresión que controlan el movimiento de los labios.
Combinando los coeficientes de identidad y de expresión, se utiliza una técnica de renderizado diferenciable para generar mapas de profundidad faciales, preparándolos para la posterior síntesis de vídeo.
2. Síntesis de apariencia visual:
Se adopta una red UNet de un solo paso para integrar las características de audio con los mapas de profundidad, generando directamente fotogramas de vídeo con movimientos labiales precisos.
Se introduce un mecanismo de atención cruzada para garantizar una alta coherencia entre los movimientos de los labios y la señal de audio, mejorando la sincronización.
Mediante un proceso de optimización (como la función de pérdida L1) se garantiza la calidad del vídeo,兼顾 la precisión a nivel de píxel y en el espacio latente.
Cómo usar JoyGen:
Configuración del entorno: el usuario debe crear un entorno conda específico e instalar las dependencias necesarias, incluidas bibliotecas específicas como Nvdiffrast.
Descarga de modelos preentrenados: se deben obtener los modelos preentrenados de JoyGen, incluidos el modelo 3D, el modelo de audio a movimiento, etc. Por lo general, estos recursos están disponibles en la página de GitHub del proyecto.
Ejecución de la inferencia: mediante la ejecución de scripts y parámetros específicos, el usuario puede convertir archivos de audio en vídeos de caras parlantes en 3D con sincronización labial realista.
Aplicaciones de JoyGen:
Reuniones virtuales: mejora la expresión facial en las reuniones virtuales.
Producción cinematográfica y televisiva: creación de efectos especiales en películas y televisión.
Educación y formación: se utiliza para producir vídeos educativos dinámicos.
ai asistentes: aumenta el grado de antropomorfismo de los asistentes Ai en la interacción entre personas y máquinas.
JoyGen simplifica enormemente la compleja tarea de generación de vídeo de rostros, y desempeña un papel muy importante en la creación de contenidos de humanos digitales, reuniones virtuales, entretenimiento y otros campos.
GitHub:https://github.com/JOY-MM/JoyGen














