
 Asistente de guiones▸
 Apps AI
 Noticias AI
Tarsier: modelo multimodal visión-lenguaje a gran escala de ByteDance
Tarsier: modelo multimodal visión-lenguaje a gran escala de ByteDanceIntroducción
Tarsier es una serie de modelos de lenguaje visual a gran escala (LVLM) lanzados por ByteDance, enfocados en tareas de comprensión de vídeos, incluyendo descripción de vídeo, preguntas y respuestas, localización y pruebas de alucinación, entre otras funciones.
Principales funciones de Tarsier
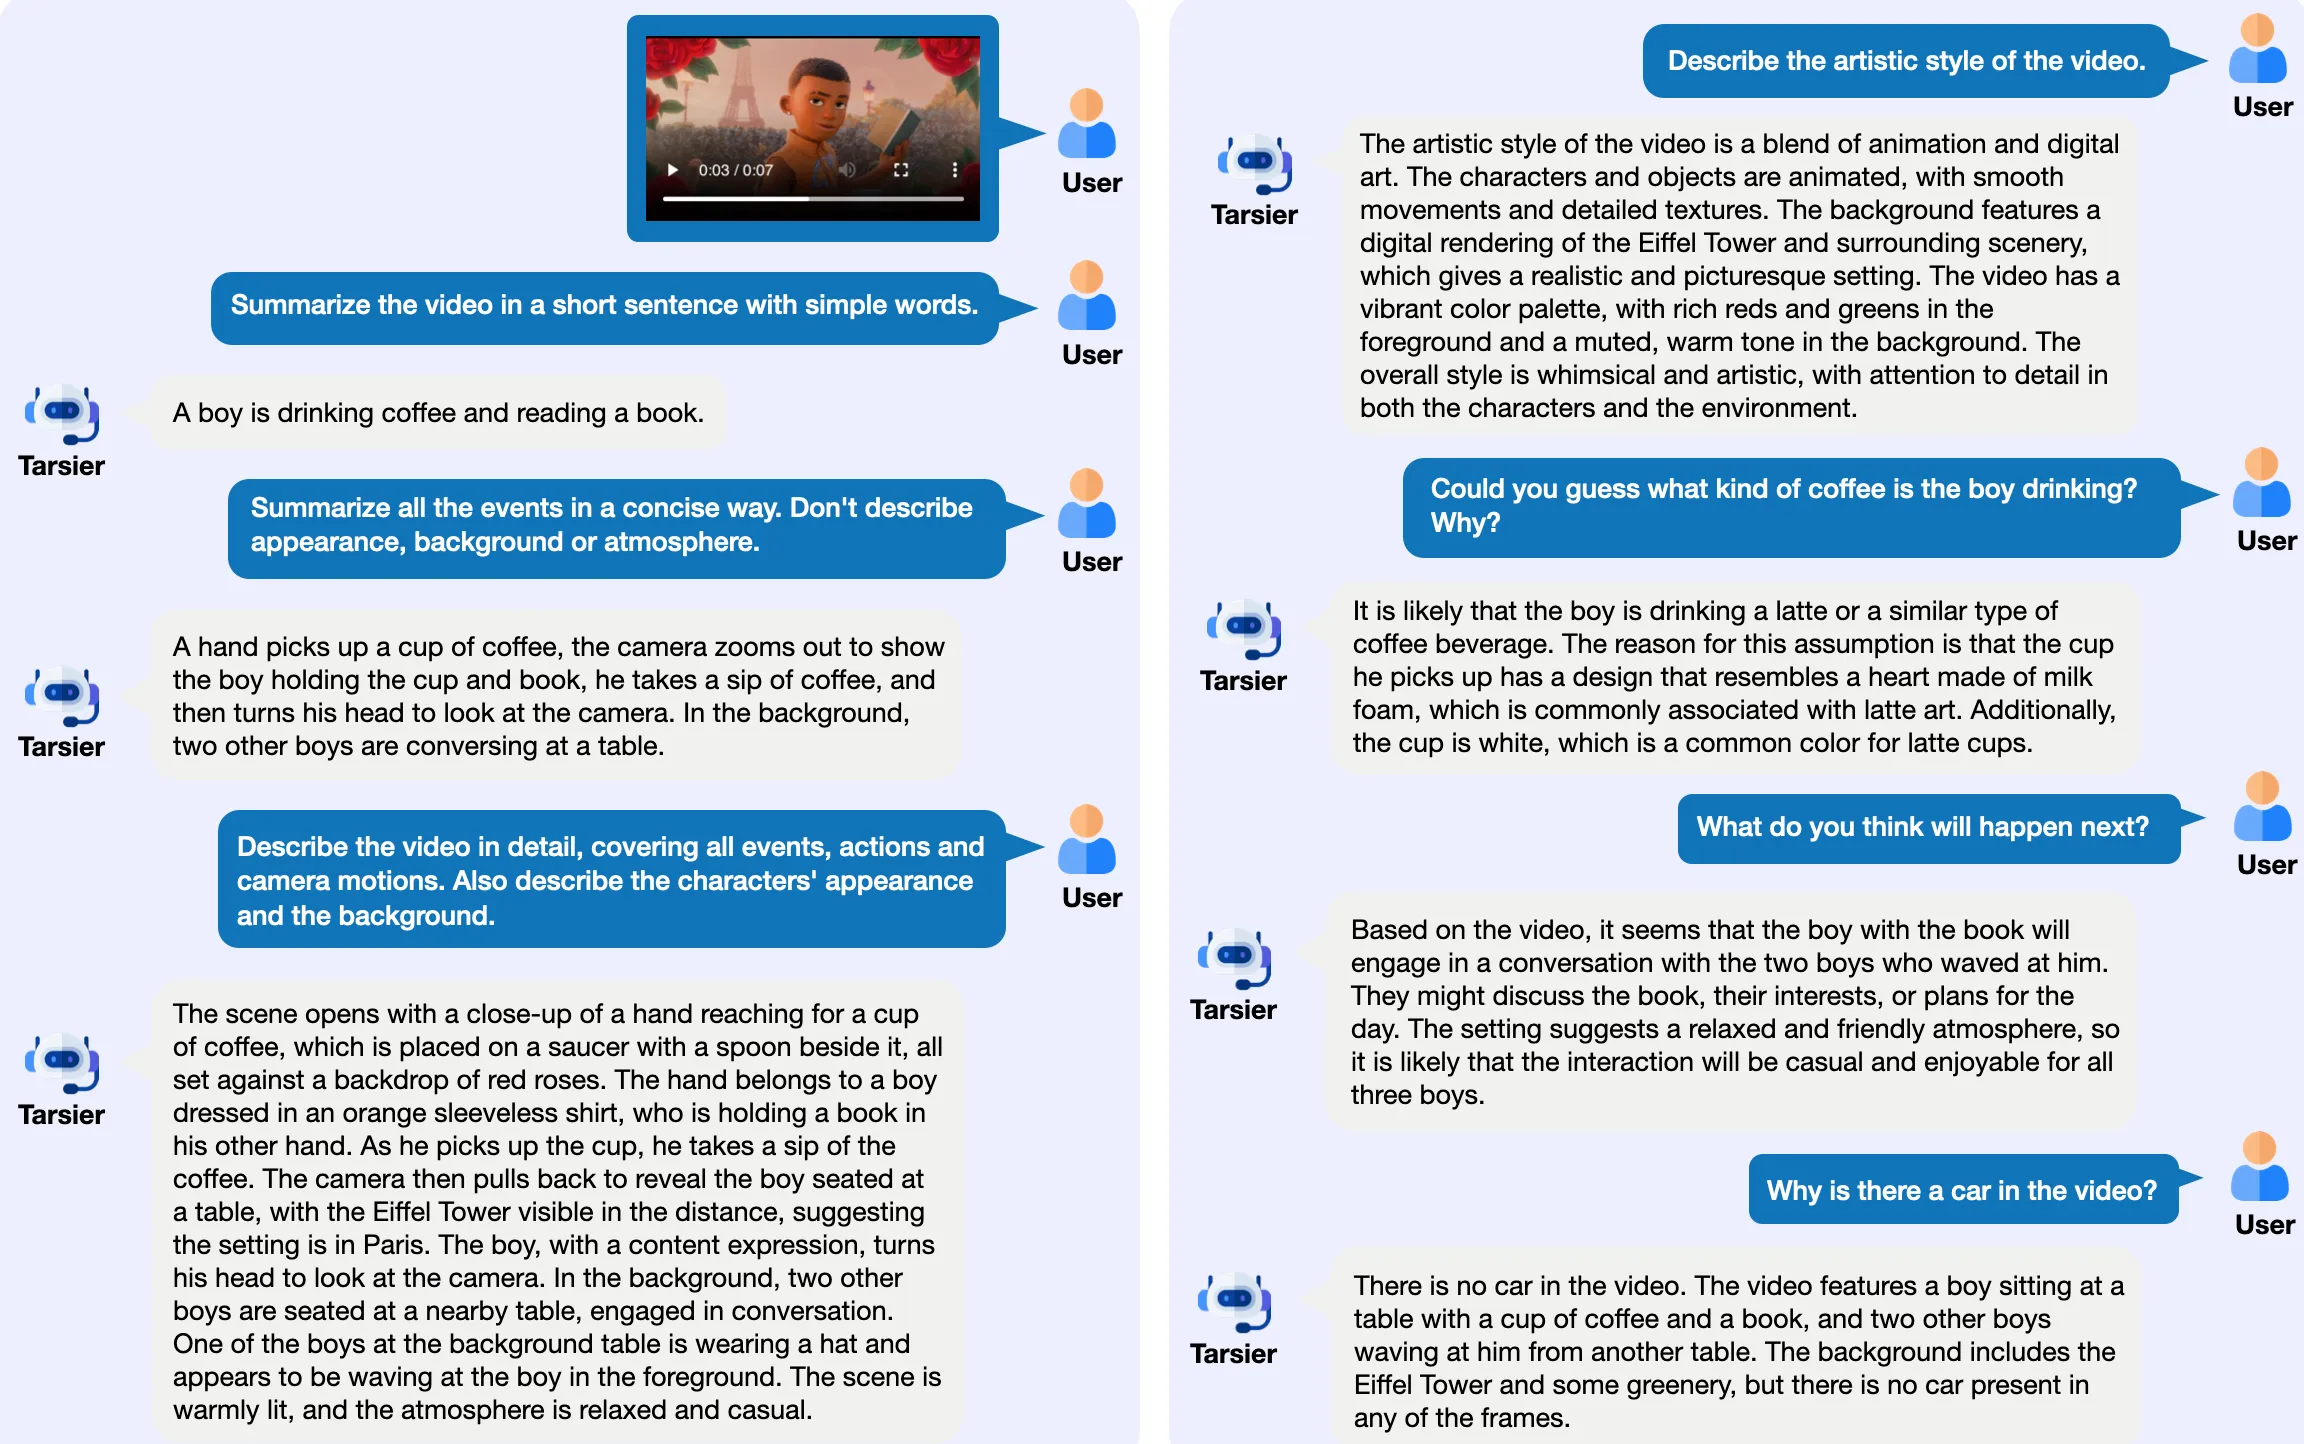
Generación de descripciones de vídeo: Tarsier puede generar descripciones de vídeo de alta calidad, cubriendo diversos detalles del vídeo, como acciones, escenas y tramas, ayudando a los usuarios a comprender mejor el contenido del vídeo.
Capacidad de preguntas y respuestas: el modelo Tarsier admite la función de preguntas y respuestas sobre vídeo, permitiendo a los usuarios hacer preguntas basadas en el contenido del vídeo, y el modelo proporcionará respuestas relevantes.
Función de localización: detecta y localiza el momento en que ocurren eventos concretos en el vídeo, admite la localización en múltiples segmentos de vídeo y puede identificar y marcar objetos o escenas específicas dentro del vídeo.
Pruebas de alucinación: mediante la optimización de las estrategias de entrenamiento, Tarsier2 reduce significativamente la posibilidad de que el modelo genere información falsa.
Soporte multilingüe: admite la generación de descripciones de vídeo en varios idiomas.
Casos de uso de Tarsier:
Creación de contenidos: Tarsier puede ayudar a los creadores de contenido a generar descripciones de vídeo, aumentando la accesibilidad del mismo y los efectos de optimización en motores de búsqueda (SEO).
Ámbito educativo: en vídeos educativos, Tarsier puede proporcionar descripciones detalladas del contenido, ayudando a los estudiantes a comprender mejor los materiales de aprendizaje.
Redes sociales: las plataformas de redes sociales pueden aprovechar Tarsier para generar descripciones automáticas del contenido de vídeo, mejorando la experiencia del usuario.
Videovigilancia: en el ámbito de la vigilancia de seguridad, Tarsier puede analizar flujos de vídeo y generar descripciones en tiempo real, ayudando al personal de seguridad a identificar rápidamente posibles amenazas.
Robótica: genera instrucciones detalladas paso a paso para tareas específicas.
Conducción inteligente: ayuda a los vehículos a identificar las condiciones de la carretera y asistir en la toma de decisiones.
La versión más reciente del modelo Tarsier, Tarsier2, presenta mejoras significativas en varios aspectos, especialmente en lo que respecta a la cantidad y diversidad de los datos. Los datos de preentrenamiento se han ampliado de 11 millones a 40 millones de pares de vídeo-texto, lo que mejora la capacidad de aprendizaje del modelo. Además, Tarsier2 incorpora alineación temporal de gran detalle en la fase de ajuste fino supervisado, lo que mejora aún más la precisión de la descripción de vídeo y la capacidad de capturar detalles. Mediante el entrenamiento con Optimización Directa de Preferencias (DPO), Tarsier2 es capaz de generar descripciones de vídeo más alineadas con las preferencias humanas, reduciendo la posibilidad de generar alucinaciones.
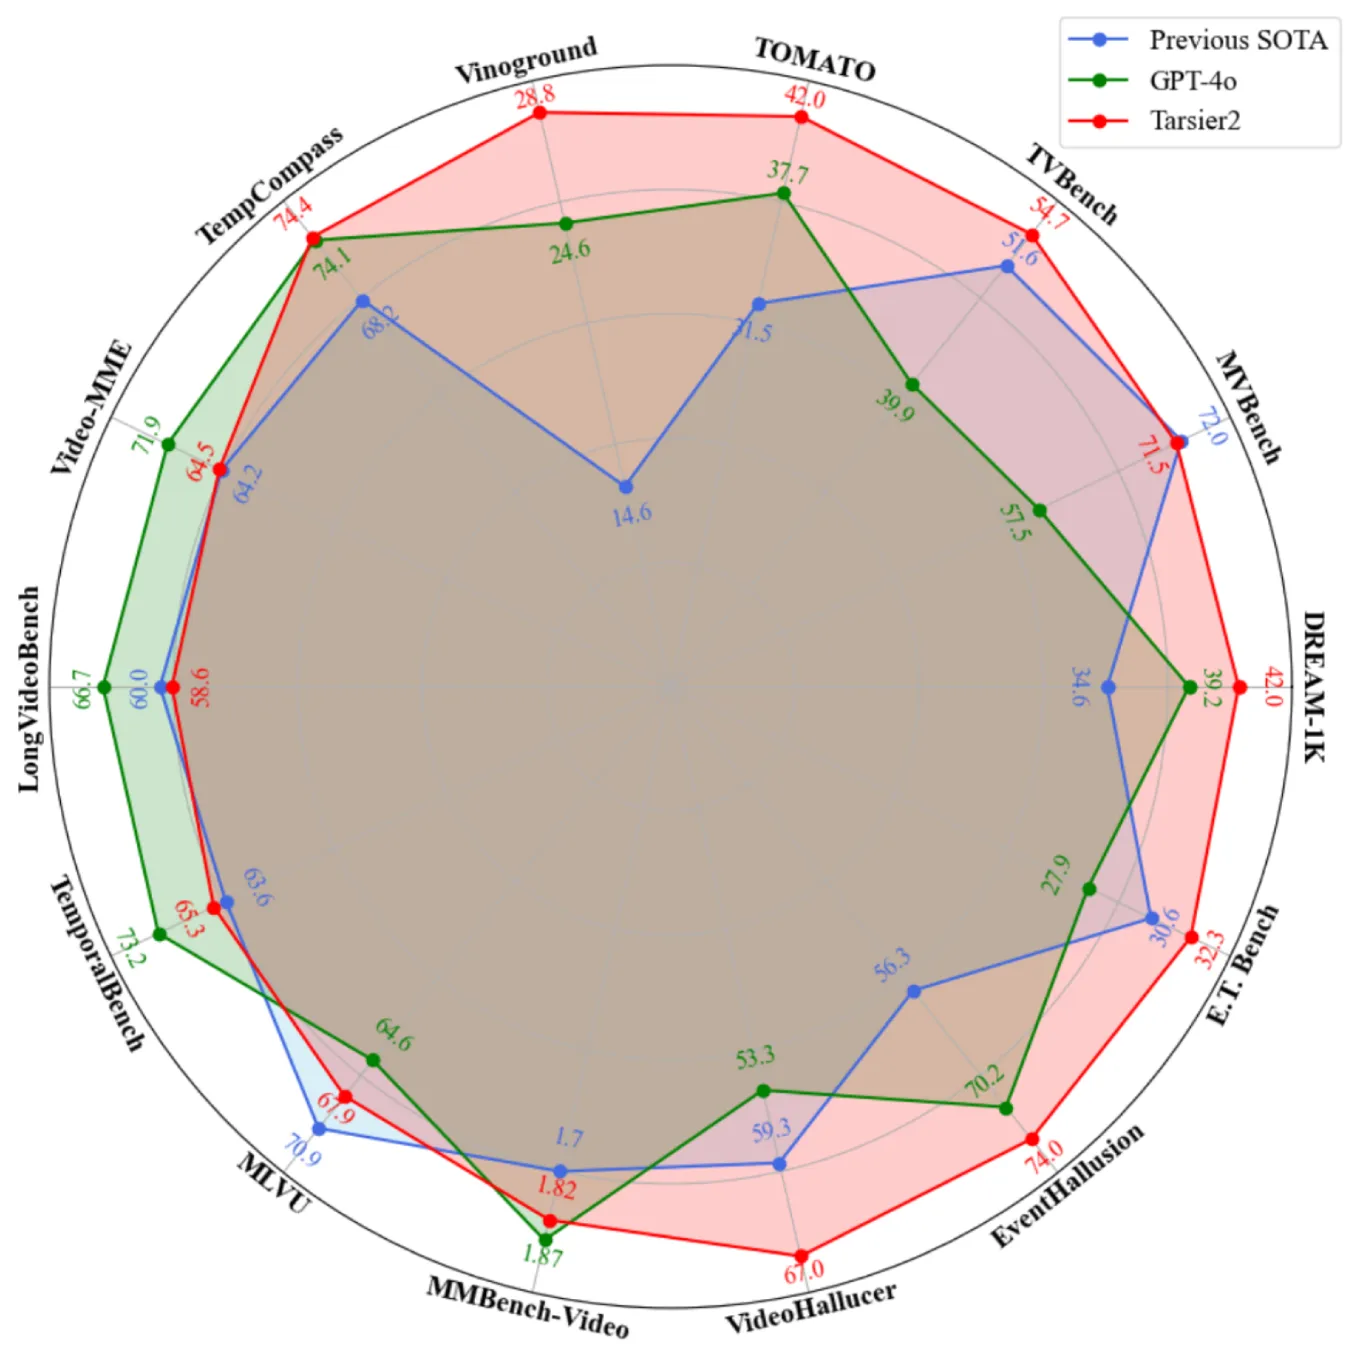
En cuanto a la evaluación del rendimiento, Tarsier2 destaca en el benchmark DREAM-1K, con una puntuación F1 un 2,8% superior a la de GPT-4o y un 5,8% superior a la de Gemini-1.5-Pro. En 15 benchmarks públicos, Tarsier2 ha logrado nuevos resultados de vanguardia, abarcando funciones como preguntas y respuestas sobre vídeo, localización de vídeo, pruebas de alucinación y preguntas y respuestas, lo que demuestra su versatilidad como potente modelo de lenguaje visual de propósito general.
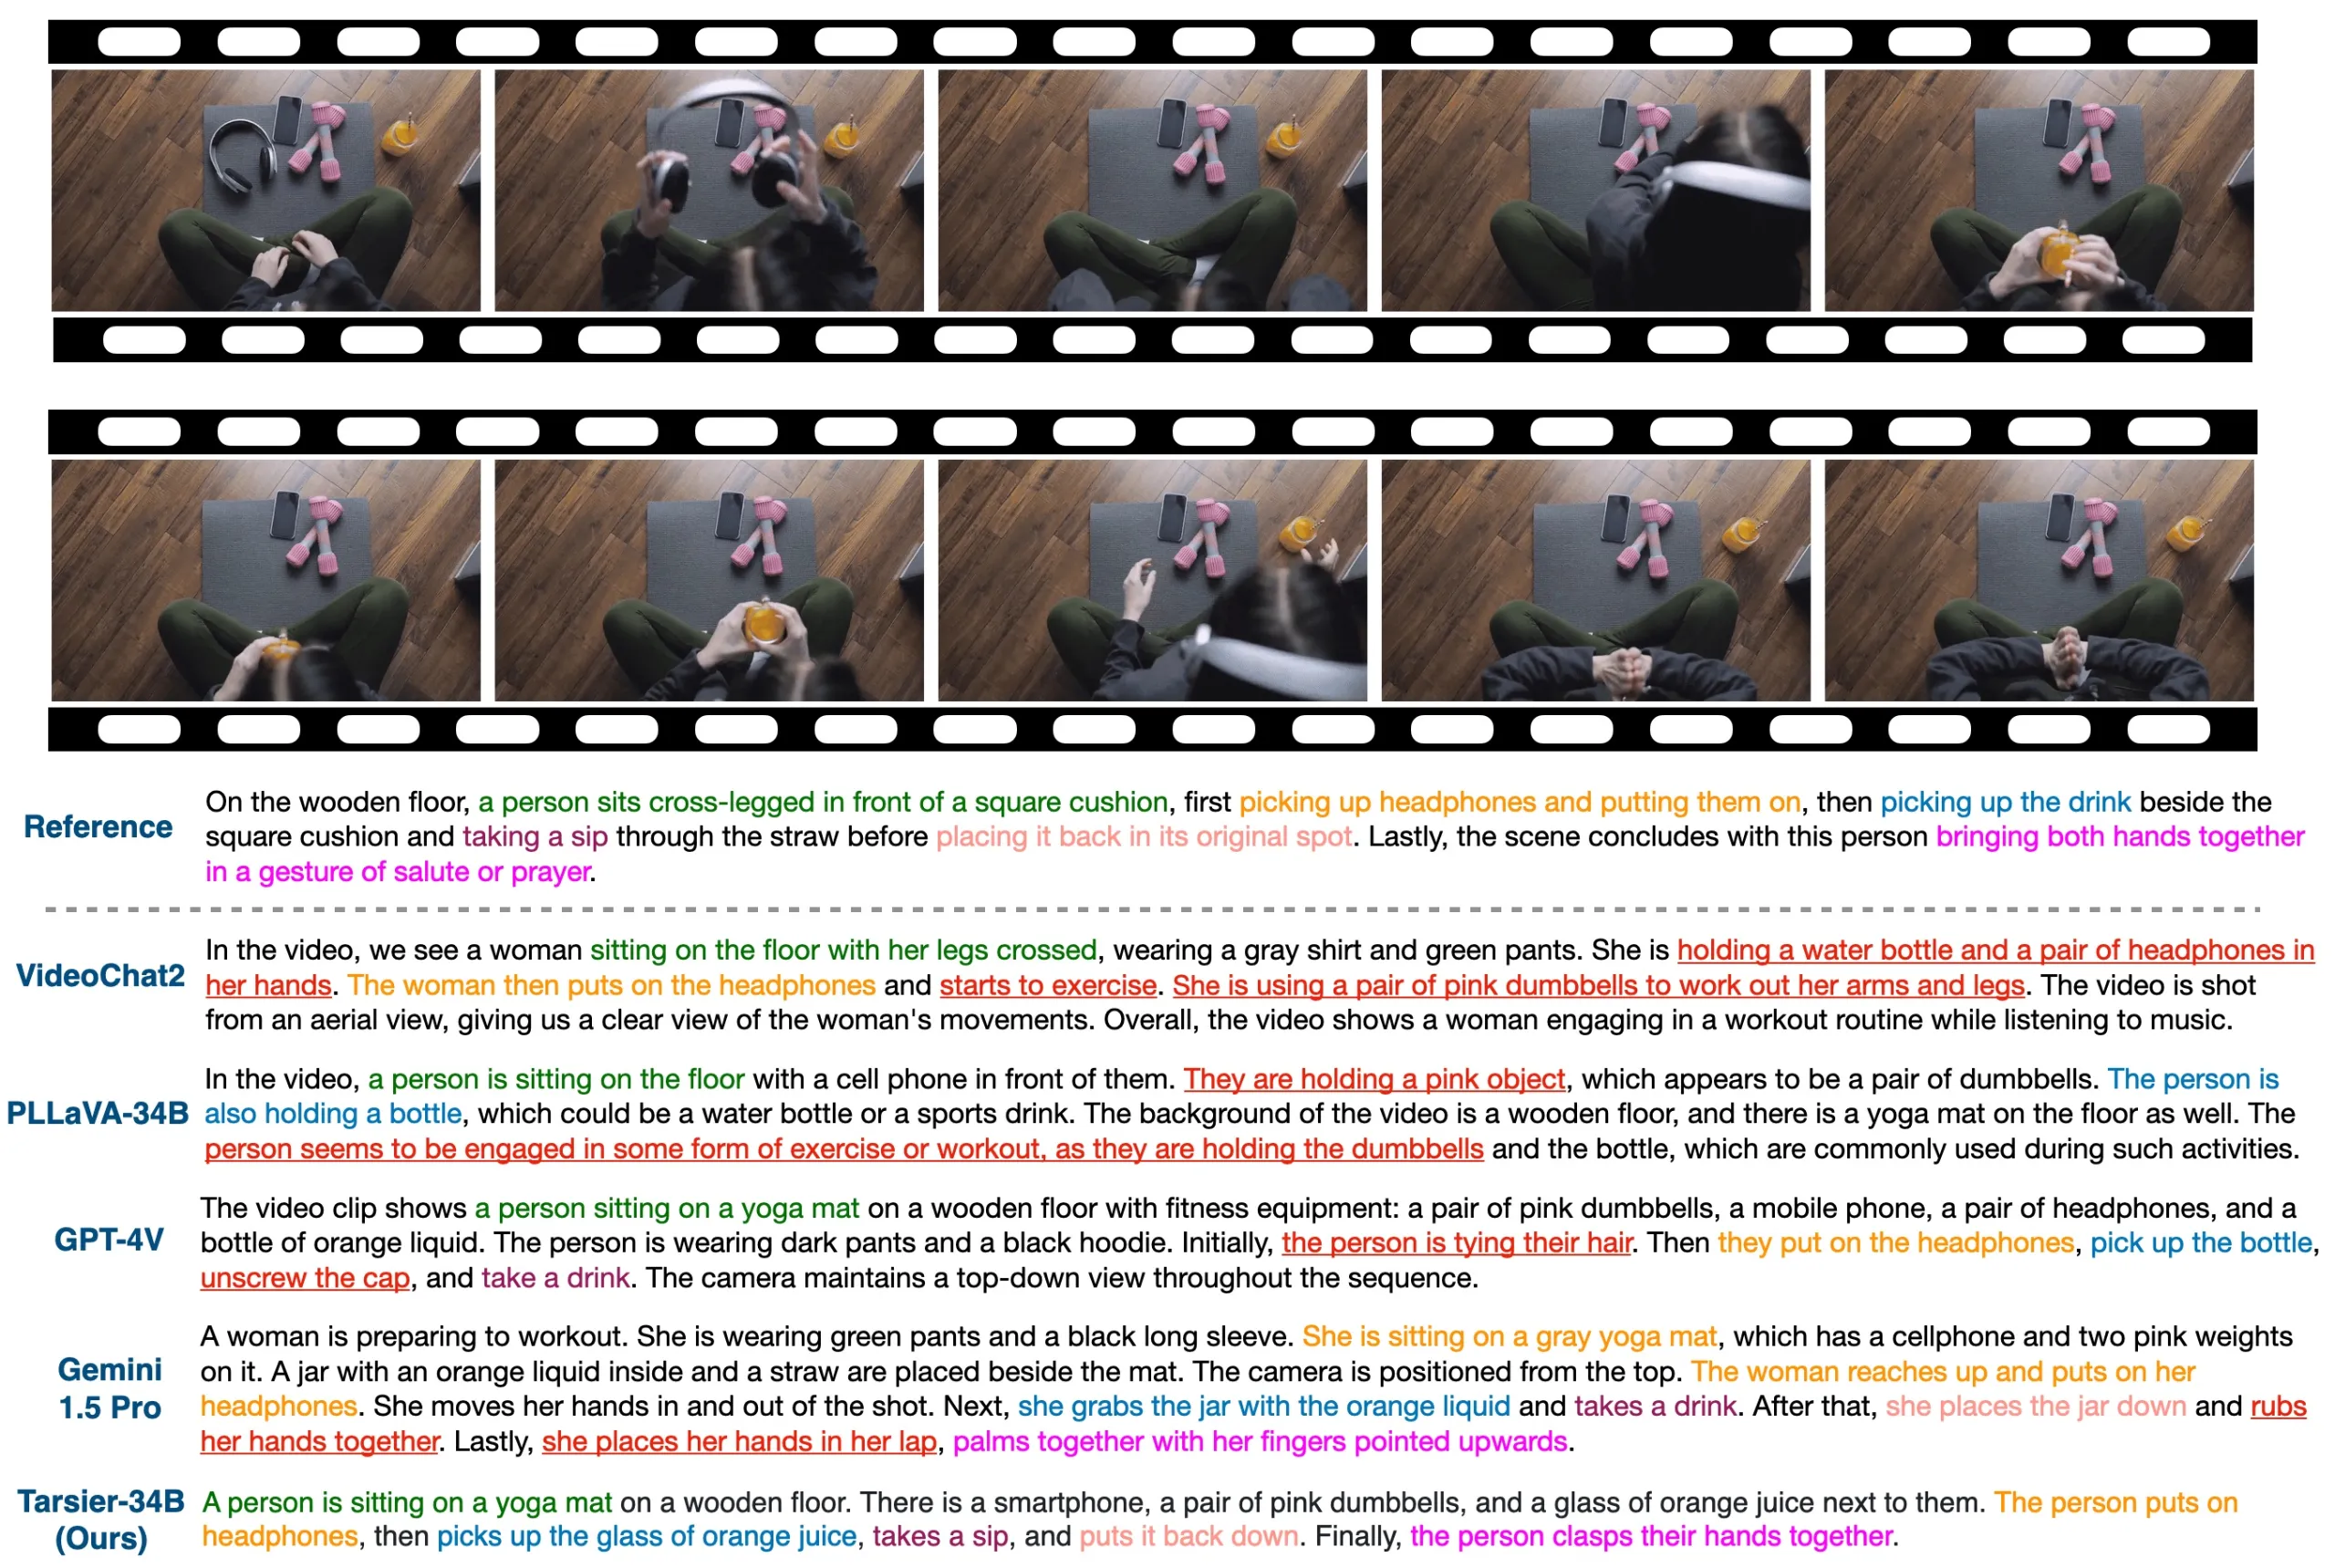
Además de la descripción de vídeo, también demuestra un gran rendimiento en tareas como preguntas y respuestas, grounding e inteligencia embodied.
Artículo: https://arxiv.org/abs/2501.07888
Código: https://github.com/bytedance/tarsier
Conjunto de datos: https://huggingface.co/datasets/omni-research/DREAM-1K
Demo: https://huggingface.co/spaces/omni-research/Tarsier2-7b














