
 Asistente de guiones▸
 Apps AI
 Noticias AI

Janus-Pro: modelo multimodal de comprensión y generación de DeepSeek
Janus-Pro: modelo multimodal de comprensión y generación de DeepSeekIntroducción
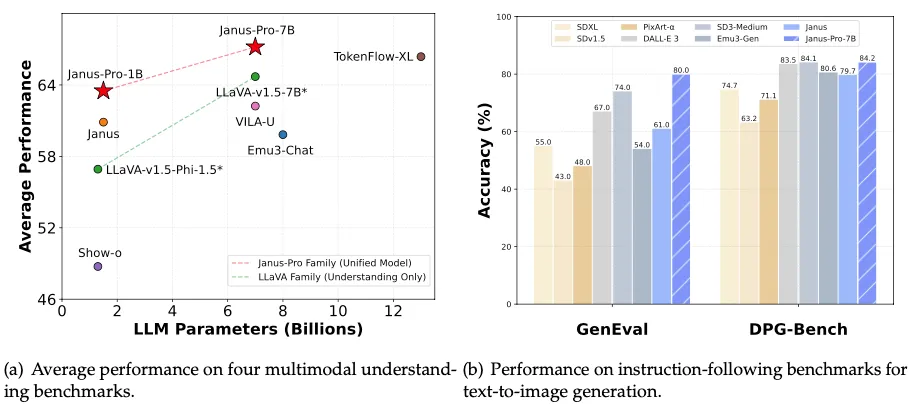
Janus-Pro es un modelo multimodal de comprensión y generación desarrollado por DeepSeek, enfocado en tareas de generación de imágenes y comprensión multimodal. Emplea un framework autorregresivo capaz de unificar la comprensión y la generación de información multimodal. A diferencia de los métodos tradicionales, Janus-Pro resuelve las limitaciones de enfoques anteriores al dividir el proceso de codificación visual en múltiples rutas independientes, mejorando la adaptabilidad y el rendimiento del modelo en diferentes tareas. Janus-Pro destaca en los benchmarks GenEval y DPG-Bench, llegando incluso a superar a Stable Diffusion y DALL-E 3 de Openai.
Funciones principales de Janus-Pro:
Janus-Pro es un modelo multimodal unificado que puede manejar tanto la generación de imágenes como tareas de comprensión multimodal. Sus funciones principales son:
Texto a imagen (Text-to-Image): genera imágenes de alta calidad a partir de descripciones textuales, con soporte para la reproducción precisa de escenas complejas y la optimización de detalles.
Comprensión multimodal: capaz de comprender el contenido de las imágenes y generar descripciones relacionadas, dando soporte a preguntas visuales, anotación de imágenes y otras tareas.
Generación multimodal: no solo genera imágenes, sino que también puede describir las imágenes generadas, reconocer texto e información de puntos de referencia, logrando una experiencia interactiva más rica.
Características técnicas de Janus-Pro
Framework autorregresivo: adopta rutas de codificación visual desacopladas, separando las tareas de "comprensión" y "generación", lo que resuelve el conflicto del codificador visual en ambos tipos de tareas presente en los modelos tradicionales.
Entrenamiento eficiente: preentrenado con 72 millones de imágenes sintéticas de alta calidad, lo que mejora la capacidad de generación y la estabilidad del modelo.
Arquitectura unificada: basada en la arquitectura Transformer, integra tareas de comprensión y generación multimodal, simplificando el diseño del modelo y aumentando su flexibilidad.
Soporte de ejecución local: la versión de 7B parámetros de Janus-Pro puede ejecutarse en GPUs de consumo, reduciendo los requisitos de hardware.
Rendimiento de Janus-Pro
Supera a DALL-E 3 y Stable Diffusion: en las pruebas GenEval y DPG-Bench, la precisión y la calidad de imagen de Janus-Pro superan a las de DALL-E 3 y Stable Diffusion.
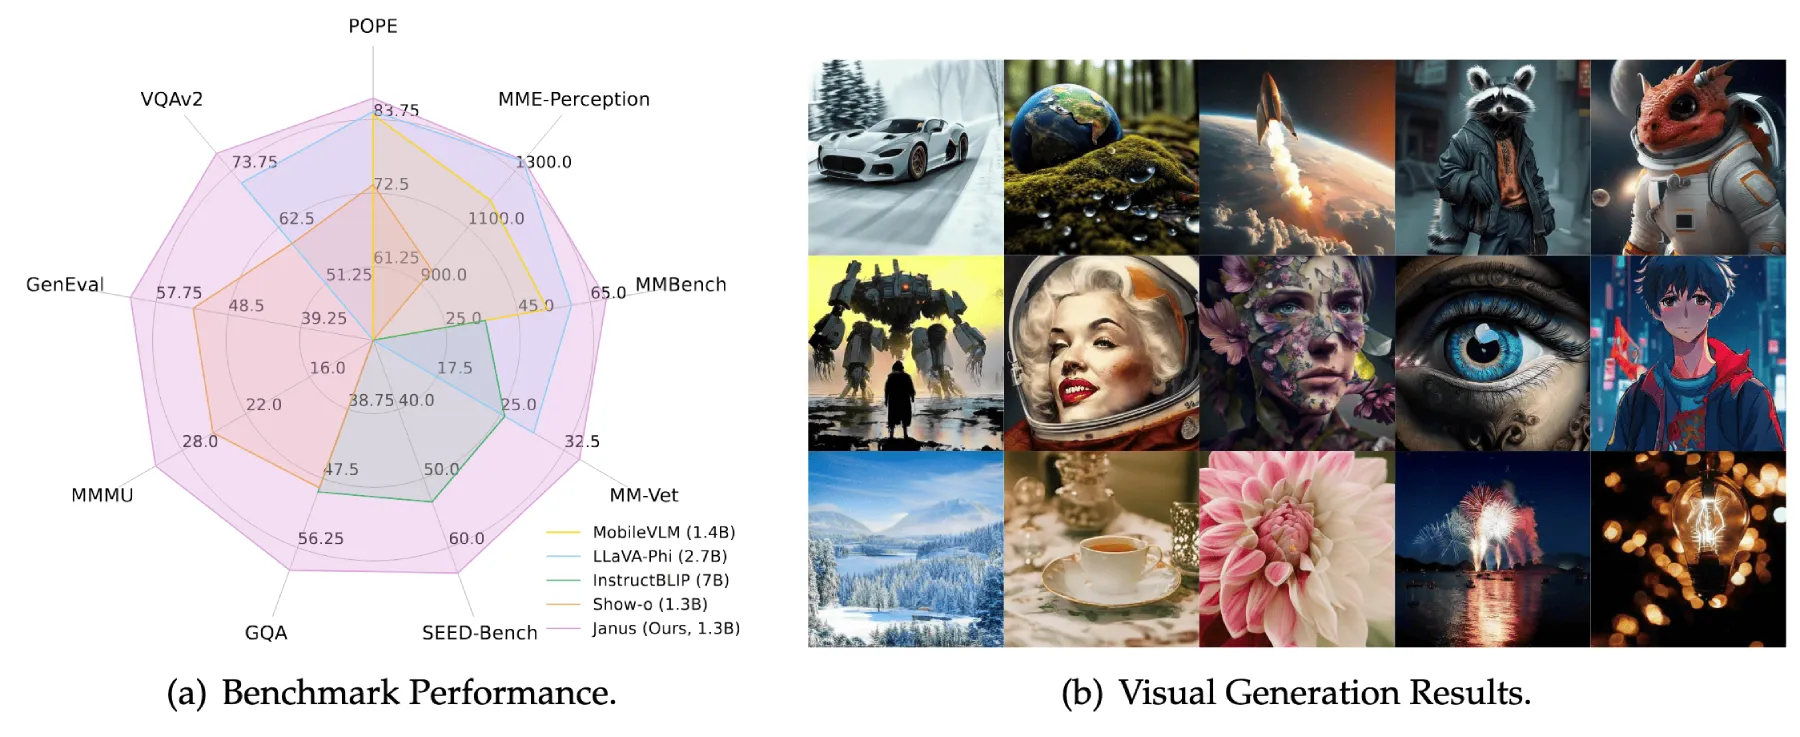
Comprensión de escenas complejas: destaca en la alineación texto-imagen y en la reproducción de detalles en escenas complejas.
Inferencia eficiente: admite la ejecución en una sola GPU, con alta eficiencia de inferencia, adecuada tanto para empresas como para usuarios individuales.
Casos de uso de Janus-Pro
Generación de imágenes: excelente desempeño en tareas de generación de imágenes.
Texto a imagen: mejora la estabilidad de la generación de texto a imagen.
Diseño creativo: ayuda a los diseñadores a generar rápidamente素材 de imágenes de alta calidad, aumentando la eficiencia creativa.
Educación e investigación: utilizado para generar material didáctico o asistir en el análisis de imágenes en investigación científica.
Aplicaciones comerciales: soporta diseño publicitario,展示 de productos y otros escenarios, satisfaciendo la demanda empresarial de imágenes de alta calidad.
Interacción multimodal: empleado en asistentes inteligentes, realidad virtual y otros escenarios que requieren comprensión y generación de imágenes.
El diseño de Janus-Pro se basa en los modelos DeepSeek-LLM-1.5b-base y DeepSeek-LLM-7b-base, dando soporte a tareas de comprensión y generación multimodal. Utiliza SigLIP-L como codificador visual, capaz de procesar entradas de imágenes de 384 x 384 píxeles, y emplea un tokenizador de fuente específica para tareas de generación de imágenes, con una tasa de submuestreo de. La flexibilidad y eficiencia de esta arquitectura hacen que Janus-Pro destaque en tareas multimodales, superando a los modelos unificados tradicionales y mostrando también un rendimiento notable frente a modelos específicos de tarea.
Janus-Pro es de código abierto bajo la licencia MIT; los usuarios pueden descargarlo y usarlo de forma gratuita, sin restricciones de uso comercial. DeepSeek también ofrece guías de despliegue detalladas, dando soporte a los usuarios para implementar el modelo rápidamente en un entorno local.
Paper:https://github.com/deepseek-ai/Janus/blob/main/janus_pro_tech_report.pdf
Descarga en Github:https://github.com/deepseek-ai/Janus
Demo en línea:https://huggingface.co/deepseek-ai/Janus-Pro-7B
Noticias relacionadas:
¿Cómo desplegar DeepSeek Janus Pro en local?
¿Cuáles son las diferencias y similitudes entre Janus-Pro y JanusFlow?
DeepSeek lanza en profundidad un nuevo modelo de IA multimodal: Janus-Pro y JanusFlow















