
 Asistente de guiones▸
 Apps AI
 Noticias AI

ExtractPDF: extrae imágenes, texto y fuentes de archivos PDF
ExtractPDF: extrae imágenes, texto y fuentes de archivos PDFIntroducción
ExtractPDF es una herramienta en línea, especializada en extraer texto e imágenes de archivos PDF. No es necesario descargar ningún programa ni complemento, los usuarios pueden utilizar directamente sus funciones en el navegador. El sitio web ofrece una interfaz sencilla y fácil de usar, que permite a los usuarios extraer la información que necesitan de forma rápida y eficiente.
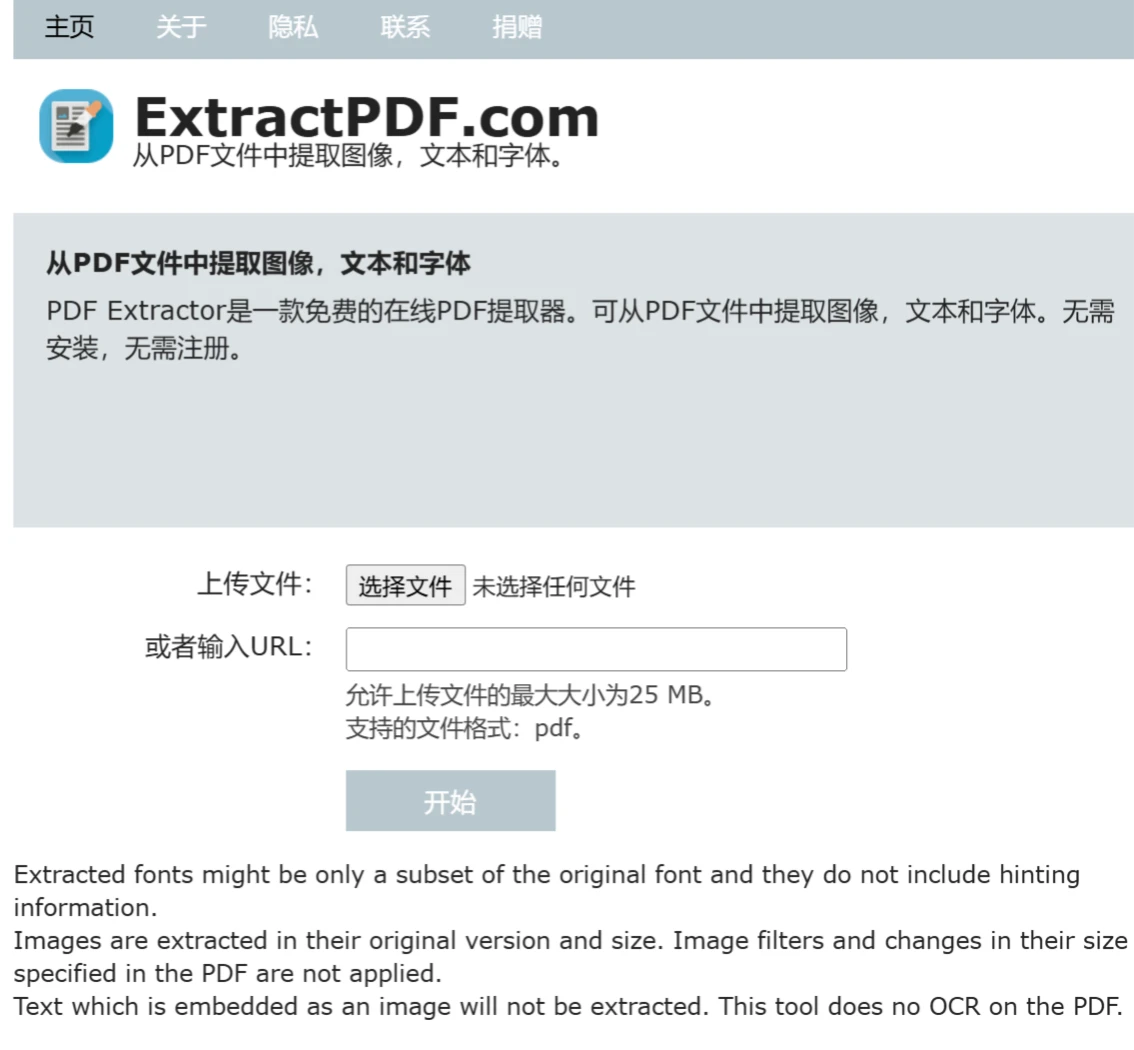
Funciones de ExtractPDF:
Extracción de texto: extrae contenido de texto plano desde archivos PDF.
Extracción de imágenes: extrae imágenes de archivos PDF, y los usuarios pueden elegir guardar una o varias imágenes.
Compatibilidad de idiomas: ExtractPDF admite el reconocimiento de texto en varios idiomas, incluyendo inglés, chino, japonés, entre otros.
Uso de ExtractPDF:
Es muy fácil de usar, solo hay que subir el archivo PDF o introducir la URL del PDF y enviarlo.
Acceder al sitio web: abra el navegador y acceda al sitio web oficial de ExtractPDF.
Subir el archivo PDF: suba el archivo PDF o introduzca la URL del PDF (ExtractPDF permite subir archivos con un tamaño máximo de 25 MB, y el formato de archivo compatible es pdf).
Comenzar la extracción: haga clic en el botón "Comenzar", ExtractPDF comenzará a procesar el archivo y extraerá el contenido necesario.
Descargar los resultados: una vez completada la extracción, los usuarios pueden descargar directamente el texto y las imágenes extraídos.
Ventajas de ExtractPDF:
Sin instalación: los usuarios no necesitan descargar ningún software, solo necesitan un navegador para usarlo.
Compatibilidad multilingüe: ExtractPDF admite múltiples idiomas, incluido el chino.
Consejos:
Las fuentes extraídas pueden ser solo un subconjunto de las fuentes originales y no contienen información de interletraje (hinting).
Las imágenes se extraen en su versión y tamaño originales. No se aplicarán los filtros de imagen ni los cambios de tamaño especificados en el PDF.
El texto incrustado como imagen no se extraerá. Esta herramienta no realiza OCR en el PDF.
Preguntas frecuentes sobre ExtractPDF:
1. ¿Por qué las imágenes extraídas se ven diferentes a las del archivo PDF?
Esta herramienta extrae las imágenes originales del archivo PDF. Se ignorarán los procesamientos de imagen realizados en el PDF, como recortes, rotaciones o inversiones de color.
2. ¿Por qué faltan glifos en las fuentes extraídas del archivo PDF?
Cuando una fuente se incrusta en un archivo PDF, este solo contiene los glifos de los caracteres que aparecen. Si su archivo PDF no contiene la letra "P", el archivo de fuente extraído tampoco la contendrá.
3. ¿Por qué el uso del archivo de fuente extraído del PDF produce una maquetación extraña?
Generalmente, los archivos PDF no contienen archivos de especificaciones de fuentes (archivos .pfm o .afm), ya que el lector de PDF no necesita esta información. La ausencia de los archivos de especificaciones de fuentes hará que el archivo de fuente extraído no se pueda utilizar normalmente.
4. ¿Es legal extraer archivos de fuentes de un PDF?
Extraer archivos de fuentes de un PDF es legal. Sin embargo, si desea utilizar los archivos de fuentes extraídos, necesitará obtener la autorización del creador de la fuente.
No obstante, debido a la falta de datos de métricas de las fuentes, los archivos de fuentes extraídos generalmente no se pueden utilizar directamente. Se utilizan principalmente para ayudar a identificar las fuentes empleadas en el archivo PDF.
Si aun así desea utilizar las fuentes extraídas del archivo PDF, debe comprender los riesgos legales a los que se enfrenta al hacerlo.













