
 Asistente de guiones▸
 Apps AI
 Noticias AI
ChatTTS-Forge: herramienta TTS todo en uno
ChatTTS-Forge: herramienta TTS todo en unoIntroducción
ChatTTS-Forge es un proyecto desarrollado en torno a modelos de generación TTS, que ofrece a los usuarios capacidades flexibles de generación TTS, compatible con múltiples voces, control de estilo, razonamiento de textos largos y otras funciones. ChatTTS-Forge proporciona diversas API (interfaces de programación de aplicaciones), lo que permite a los desarrolladores utilizar estas API directamente para convertir fácilmente texto en voz.
ChatTTS-Forge es un proyecto desarrollado en torno a modelos de generación TTS (texto a voz). Ofrece a los usuarios capacidades flexibles de generación TTS, compatible con múltiples voces, control de estilo, razonamiento de textos largos y otras funciones.
ChatTTS-Forge proporciona diversas API (interfaces de programación de aplicaciones), lo que permite a los desarrolladores utilizar estas API directamente para convertir fácilmente texto en voz. Además, ofrece una interfaz web fácil de usar (WebUI) que permite a los usuarios introducir texto directamente en la página web y generar voz sin necesidad de programar.
Características principales de ChatTTS-Forge:
Generación TTS: admite razonamiento con múltiples modelos TTS, incluidos ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS, etc. Los usuarios pueden elegir y cambiar de voz libremente.
Gestión de tonos: incluye varios tonos integrados y permite cargar tonos personalizados. Los usuarios pueden crear y utilizar tonos personalizados subiendo audio o texto.
Control de estilo: ofrece varias opciones de control de estilo, incluyendo el ajuste de la velocidad de la voz, el tono y el volumen, así como la adición de un Enhancer de voz para mejorar la calidad de salida.
Procesamiento de textos largos: admite la segmentación automática y el razonamiento de textos muy largos, lo que permite generar audio a partir de contenidos de texto extensos.
Soporte de SSML: utiliza una sintaxis SSML similar a XML para un control avanzado de la síntesis TTS, adecuada para escenarios de generación de voz más detallados.
ASR (Reconocimiento Automático de Voz): integra el modelo Whisper, compatible con la conversión de voz a texto.
Tecnología y métodos de ChatTTS-Forge:
Servidor API: un servidor API escrito en Python que ofrece un servicio TTS eficiente, compatible con múltiples solicitudes concurrentes y configuración personalizada.
WebUI: interfaz de usuario basada en Gradio que permite a los usuarios experimentar las funciones TTS a través de una interfaz operativa sencilla.
Soporte de Docker: ofrece opciones de implementación en contenedores Docker para simplificar el proceso de despliegue tanto local como en servidores.
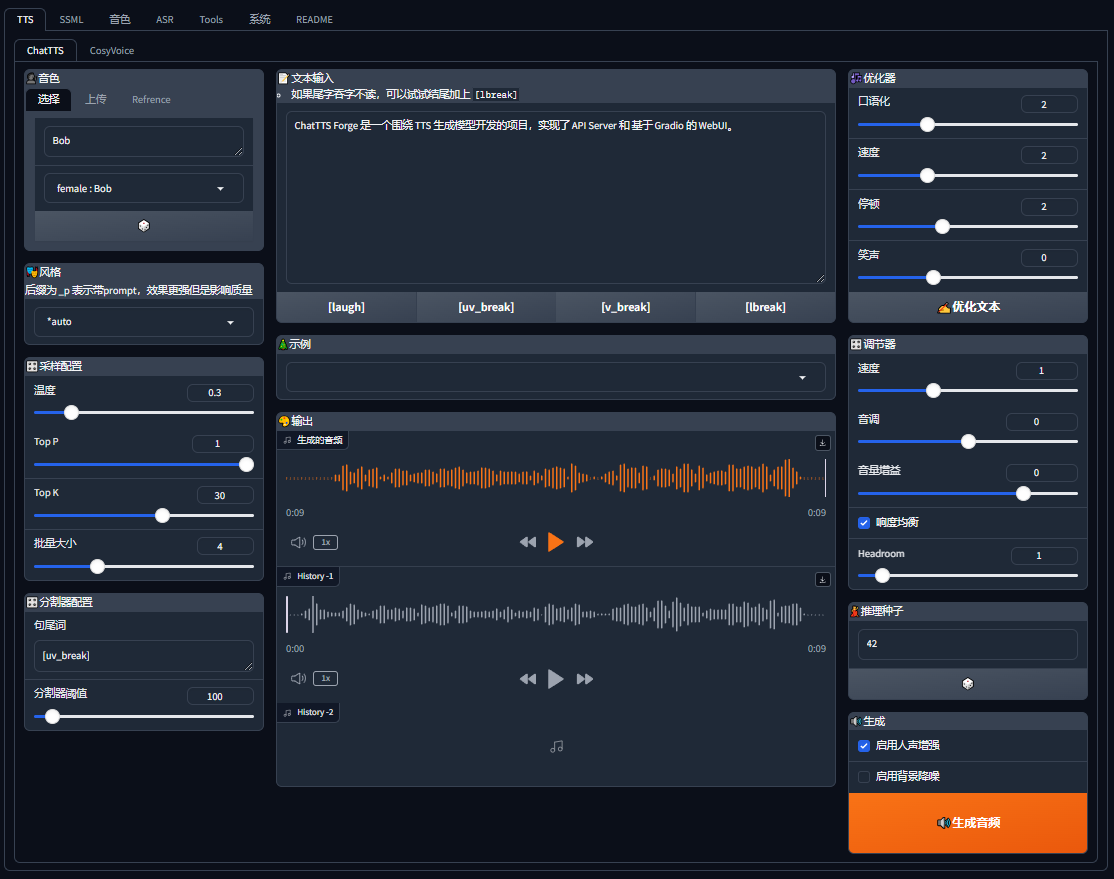
Características de la WebUI de ChatTTS-Forge:
TTS (texto a voz): a través de la WebUI, los usuarios pueden introducir texto y generar voz utilizando varios modelos TTS diferentes.
Cambio de tono: admite el cambio entre múltiples tonos preestablecidos; los usuarios pueden elegir diferentes voces para generar el habla.
Carga de voz personalizada: los usuarios pueden subir sus propios archivos de voz para generar voces personalizadas en tiempo real.
Control de estilo: se puede ajustar el estilo de la voz, incluyendo parámetros como la velocidad, el tono y el volumen, para generar voces que satisfagan necesidades específicas.
Procesamiento de textos largos: admite el procesamiento de textos muy largos, dividiendo automáticamente los textos extensos en fragmentos pequeños y generando la voz en orden, ideal para generar contenido de audio de larga duración.
Procesamiento por lotes: los usuarios pueden configurar el tamaño del lote para aumentar la velocidad de razonamiento en textos largos.
Refinador: esta herramienta permite ajustar el texto para optimizar la voz generada, especialmente útil para manejar textos de longitud ilimitada.
Mejora de voz: integra modelos de mejora para aumentar la calidad de la voz generada y hacer que suene más natural.
Historial de generación: guarda los 3 resultados de generación más recientes, lo que facilita a los usuarios comparar los efectos de voz con diferentes configuraciones.
Soporte multimodelo: la WebUI admite varios modelos TTS, incluidos ChatTTS, CosyVoice, FishSpeech, GPT-SoVITS, etc. Los usuarios pueden elegir el modelo adecuado según sus necesidades.
Soporte de SSML: utiliza una sintaxis SSML similar a XML para controlar el proceso de síntesis de voz, adecuada para escenarios que requieren un control más complejo.
Herramienta de podcasts: ayuda a los usuarios a crear contenido de audio largo y multivoz a partir de guiones de blog.
Generación de subtítulos: crea scripts SSML a partir de archivos de subtítulos para generar diversos contenidos de voz.
GitHub: https://github.com/lenML/ChatTTS-Forge
Prueba en línea: https://huggingface.co/spaces/lenML/ChatTTS-Forge














