
 Asistente de guiones▸
 Apps AI
 Noticias AI
CogVideo: genera vídeos a partir de descripciones de texto
CogVideo: genera vídeos a partir de descripciones de textoIntroducción
CogVideo es actualmente el modelo preentrenado de generación de texto a vídeo de propósito general más grande, con 9400 millones de parámetros. CogVideo aprovecha de forma eficaz el modelo preentrenado de generación de texto a imagen (CogView2) para construir un modelo de generación de vídeo a partir de texto, y emplea una estrategia de entrenamiento jerárquico con múltiples tasas de frames.
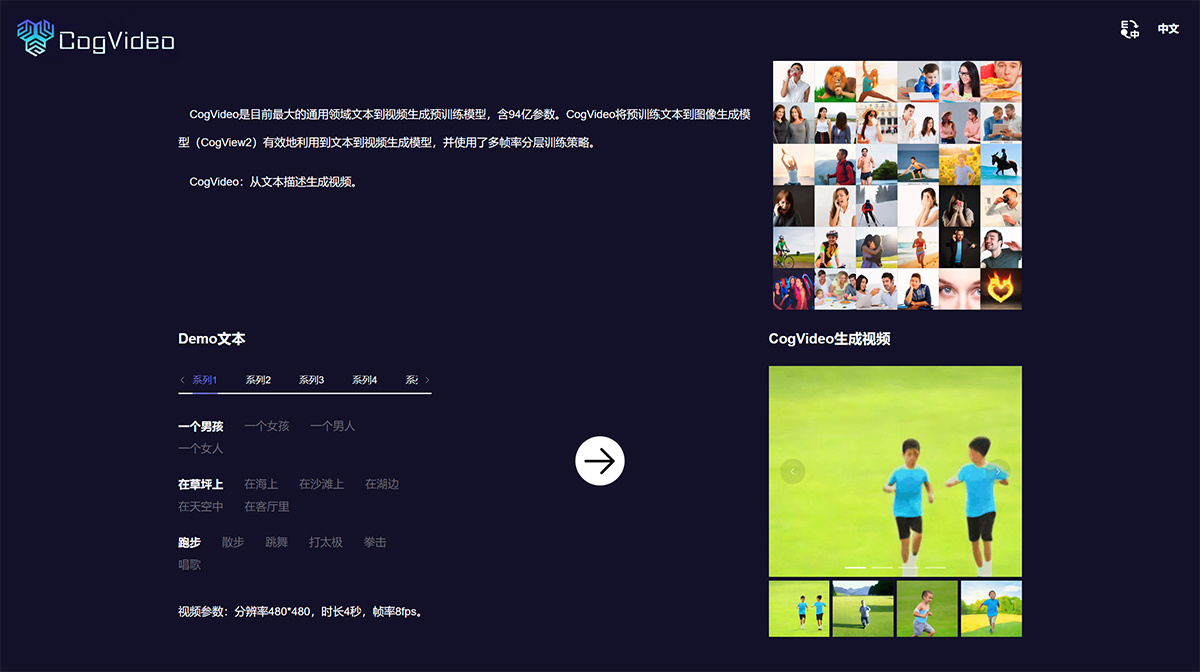
CogVideo es un modelo preentrenado de código abierto de generación de texto a vídeo propuesto por la Universidad de Tsinghua y el equipo de Tang Jie de BAai, y ha despertado un gran interés en GitHub. La tecnología central de este modelo se basa en algoritmos de aprendizaje profundo y arquitecturas de modelos, capaces de transformar descripciones de texto en contenidos de vídeo vívidos y realistas.
CogVideo adopta una estrategia de entrenamiento jerárquico con múltiples tasas de frames y, al heredar el modelo preentrenado de generación de texto a imagen CogView, logra una conversión eficiente de texto a vídeo. Además, CogVideo cuenta con una avanzada función de construcción de escenas dinámicas, capaz de generar entornos 3D y animaciones a partir de descripciones de texto detalladas proporcionadas por el usuario. Al mismo tiempo, CogVideo ajusta de forma eficiente el modelo preentrenado de generación de texto a imagen para la generación de texto a vídeo, evitando así el costoso preentrenamiento completo desde cero.
El entrenamiento de CogVideo se basa principalmente en un marco de generación jerárquica con múltiples frames: primero se generan varios frames de imágenes a partir del texto de entrada mediante CogView2 y, a continuación, se aumenta la tasa de frames mediante interpolación para completar la generación de la secuencia de vídeo completa. Esta estrategia de entrenamiento otorga a CogVideo la capacidad de controlar la intensidad de los cambios durante el proceso de generación, lo que contribuye a una mejor alineación semántica entre el texto y el vídeo. El modelo utiliza 9400 millones de parámetros y es uno de los modelos preentrenados de generación de texto a vídeo de propósito general más grandes en la actualidad.
CogVideo no solo admite la entrada en chino, sino que también proporciona documentación y tutoriales detallados que facilitan su uso y personalización por parte de investigadores y desarrolladores. Su carácter de código abierto y su facilidad de uso le confieren un importante valor de aplicación en el campo de la comprensión multimodal de vídeo. Además, la aparición de CogVideo marca un avance significativo de la tecnología de IA en el ámbito de la generación de vídeo, ofreciendo un espacio imaginativo disruptivo para la creación del futuro.
En definitiva, CogVideo, como potente modelo de generación de vídeo a partir de texto, es capaz de aprovechar de forma eficaz los modelos preentrenados para generar vídeos de alta calidad. Sin embargo, el proceso de generación de vídeo también enfrenta algunos retos, como la escasez de conjuntos de datos de texto-vídeo y su débil correlación, que dificultan la comprensión por parte del modelo de semánticas de movimiento complejas y requieren mayor investigación y mejoras.















