
 Asistente de guiones▸
 Apps AI
 Noticias AI
DiffusionGPT: sistema de generación de imágenes a partir de texto impulsado por LLM
DiffusionGPT: sistema de generación de imágenes a partir de texto impulsado por LLMIntroducción
DiffusionGPT, un sistema todo en uno de generación de imágenes a partir de texto impulsado por LLM, desarrollado por ByteDance, diseñado específicamente para generar imágenes de alta calidad a partir de diferentes prompts de entrada. Su objetivo principal es analizar los prompts de entrada y determinar el modelo generativo que produzca los resultados óptimos, caracterizándose por una alta generalización, gran utilidad y comodidad.
Lo impresionante de DiffusionGPT es que integra múltiples modelos expertos de generación de imágenes de distintos campos. Luego utiliza un LLM para conectar con estos modelos de generación de imágenes, permitiendo que el LLM procese y comprenda diversos prompts de texto. Finalmente, selecciona el modelo de imágenes más adecuado según la información comprendida para generar la imagen. De esta forma, al igual que GPT-4, puedes generar imágenes a través del chat...
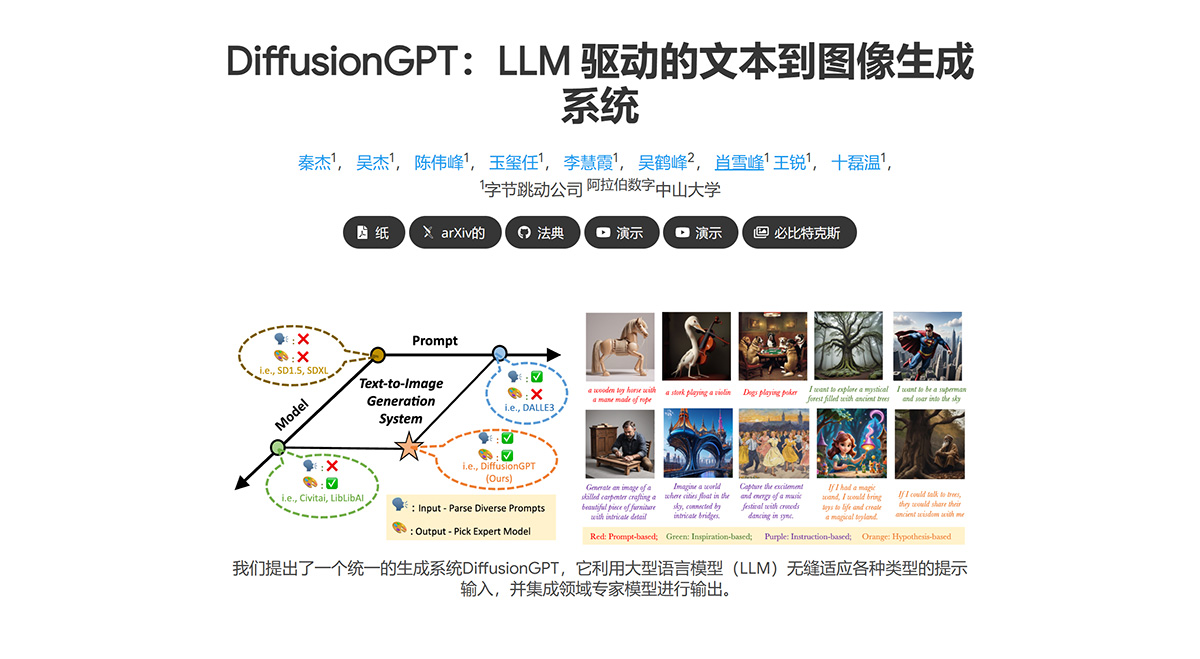
Características principales de DiffusionGPT:
1. Procesamiento diverso de prompts de texto: DiffusionGPT es capaz de comprender y procesar diversos tipos de prompts de texto, incluyendo instrucciones concretas, inspiraciones abstractas, hipótesis complejas, entre otros.
2. Integración de múltiples modelos expertos de diferentes campos: El sistema integra modelos de difusión de imágenes de múltiples campos, donde cada modelo posee capacidades especializadas de generación de imágenes en su campo específico. Estos modelos se especializan en la generación de imágenes en dominios particulares, como paisajes naturales, retratos de personas, obras de arte, etc.
Esto significa que el sistema no solo puede generar imágenes comunes, sino que también puede manejar tareas de generación de imágenes más específicas y complejas, como imágenes en un estilo o tipo particular. Imitar el estilo de un artista específico, el estilo de cómic o técnicas fotográficas.
3. Impulsado por un modelo de lenguaje grande: DiffusionGPT utiliza un modelo de lenguaje grande (LLM) para analizar y comprender los prompts de texto introducidos por el usuario. Este proceso es similar a cómo otros sistemas basados en LLM (como GPT-4) procesan el texto, pero se aplica específicamente a la comprensión de instrucciones y descripciones utilizadas para la generación de imágenes.
4. Selección inteligente del modelo de imagen adecuado: Basándose en la comprensión de los prompts de texto, DiffusionGPT puede seleccionar de forma inteligente el modelo de generación de imágenes más adecuado para generar la imagen. Esto no solo incluye elegir el modelo correcto, sino también ajustar los parámetros de generación para satisfacer de la mejor manera las necesidades del usuario.
5. Generación de imágenes de alta calidad: Mediante una coincidencia precisa entre los prompts de texto y el mejor modelo generativo, DiffusionGPT puede generar imágenes de alta calidad que se alinean estrechamente con las necesidades del usuario.
6. Retroalimentación del usuario y base de datos de ventajas: Combinando la retroalimentación del usuario y una base de datos de ventajas, el sistema puede ajustar la selección de modelos según las preferencias del usuario, mejorando la relevancia y la calidad de la generación de imágenes.
Por ejemplo: en las primeras etapas de uso del sistema, los usuarios pueden proporcionar comentarios sobre las imágenes generadas, como "los colores de esta imagen son demasiado oscuros". DiffusionGPT utiliza estos comentarios para ajustar su selección de modelos, de modo que las generaciones futuras se ajusten mejor a las preferencias del usuario.
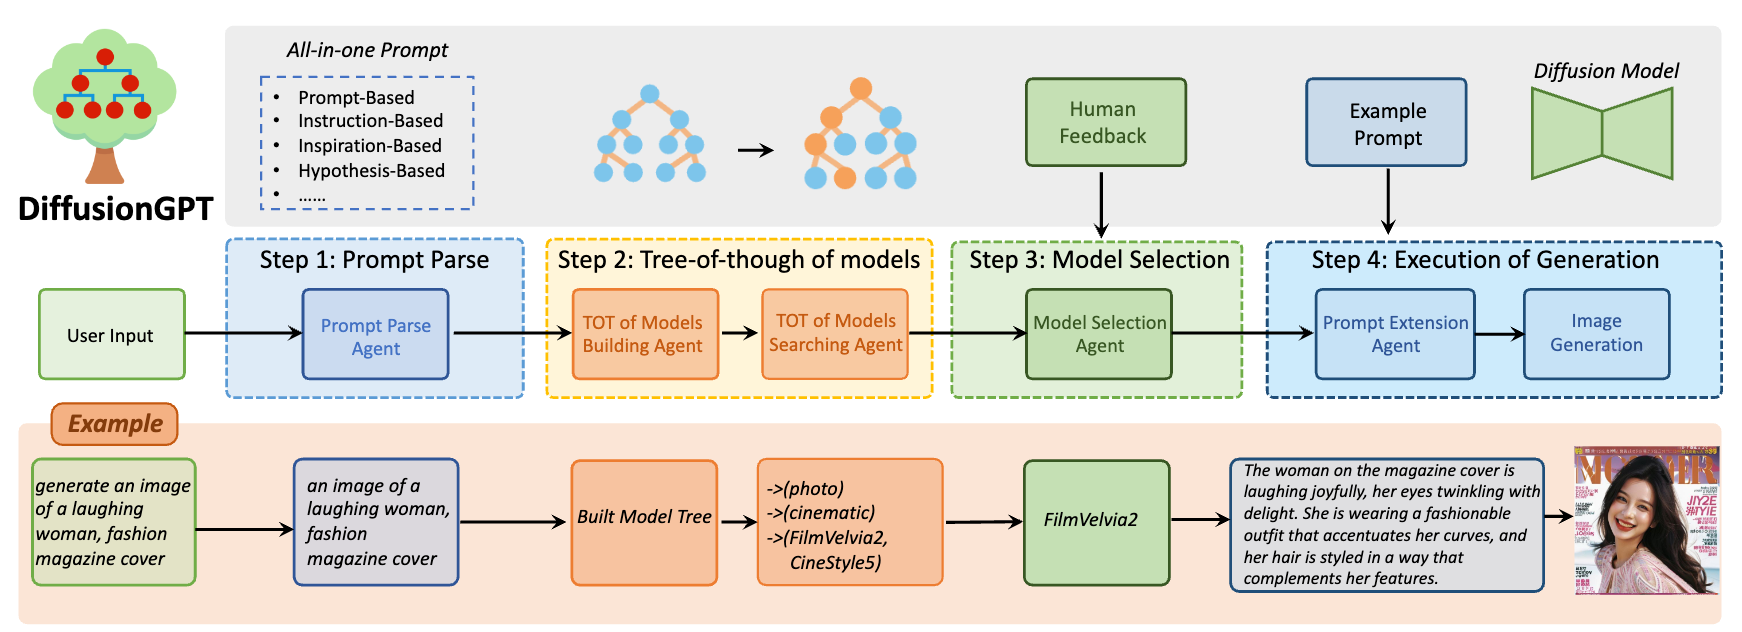
Principios de funcionamiento de DiffusionGPT:
1. Análisis de entrada: El usuario proporciona un prompt de texto, como una descripción, instrucción o inspiración.
El modelo de lenguaje grande (LLM) se encarga de analizar estos prompts de texto, comprendiendo su significado y requerimientos.
2. Construcción del Árbol de Pensamiento (Tree-of-Thought): Según las diferentes tareas de generación de imágenes, el sistema construye un "árbol de pensamiento", una estructura que organiza los distintos modelos de generación de imágenes.
El árbol de pensamiento se basa en conocimientos previos y retroalimentación humana, e incluye modelos de nivel experto de múltiples campos.
3. Selección del modelo: Según los resultados del análisis del LLM, el sistema determina, a través del árbol de pensamiento, el modelo de generación de imágenes más adecuado para el prompt de texto actual. Durante el proceso de selección, también se pueden considerar las preferencias del usuario y la retroalimentación histórica, información que se almacena en la base de datos de ventajas.
4. Generación de la imagen: Una vez seleccionado el modelo adecuado, se utiliza para generar la imagen. La imagen generada estará estrechamente relacionada con el prompt de texto de entrada y reflejará la intención y las preferencias del usuario.
5. Salida del resultado: La imagen finalmente generada se presenta al usuario.
Estas imágenes pueden ser diversas, incluyendo, entre otras, escenas descritas de manera concreta, obras de arte conceptuales o imágenes que se ajusten a un estilo específico.
6. Proceso de optimización mediante retroalimentación del usuario:
Los comentarios del usuario sobre las imágenes generadas se utilizan para enriquecer la base de datos de ventajas, lo que a su vez ayuda al sistema a comprender mejor las preferencias del usuario y a optimizar la selección de modelos y la generación de imágenes en iteraciones posteriores.
DiffusionGPT muestra un alto grado de realismo y detalle al generar imágenes de categorías como personas y escenas.En comparación con modelos de referencia (como SD1.5), las imágenes generadas por DiffusionGPT presentan mejoras evidentes en fidelidad visual y captura de detalles.DiffusionGPT supera a los modelos tradicionales de difusión estable en cuanto a recompensas de imagen y puntuaciones estéticas.En las evaluaciones cuantitativas de la calidad de generación de imágenes, DiffusionGPT demuestra puntuaciones altas, lo que indica que las imágenes generadas son más apreciadas en términos de calidad y estética.














