
 Asistente de guiones▸
 Apps AI
 Noticias AI
Audio2Photoreal: generación de personas virtuales realistas a partir de audio
Audio2Photoreal: generación de personas virtuales realistas a partir de audioIntroducción
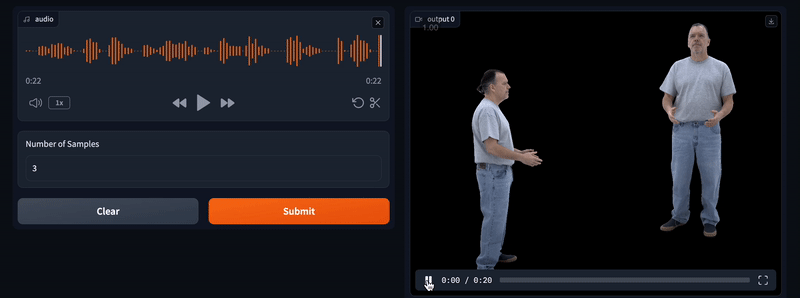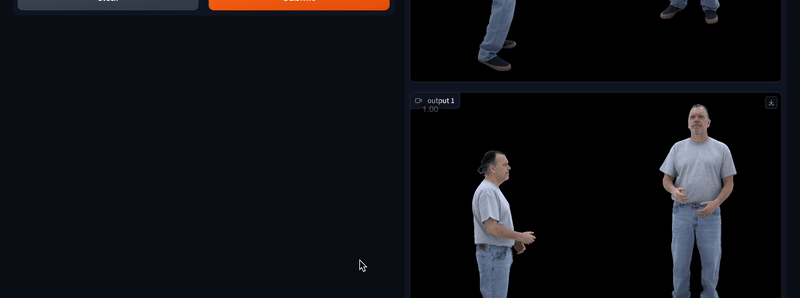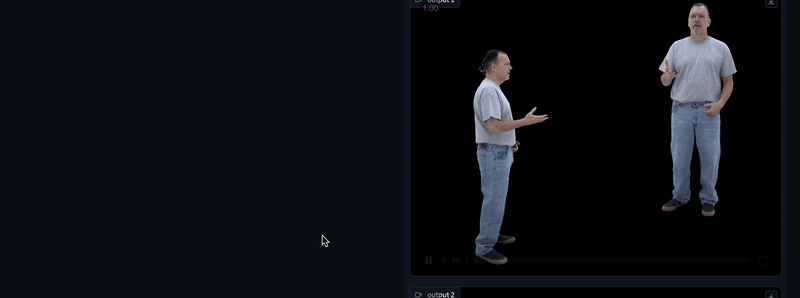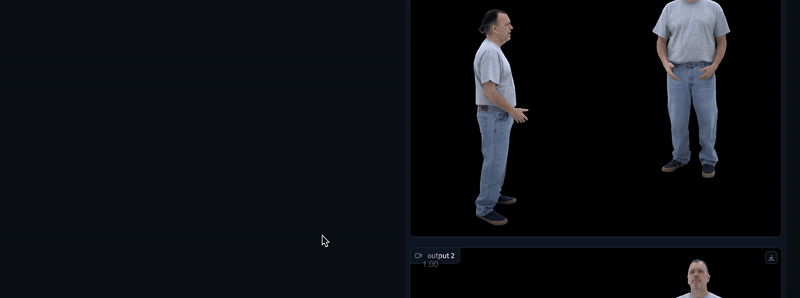
Meta aiha publicado recientemente una tecnología impresionante: Audio2PhotoReal, que genera avatares virtuales de cuerpo entero y extremadamente realistas a partir de audio.Es capaz de generar expresiones faciales, cuerpo completo y gestos realistas correspondientes a la conversación a partir del audio de conversaciones entre varias personas.
Estos avatares virtuales generados no solo son visualmente realistas, sino que también reflejan con precisión los detalles de gestos y expresiones de la conversación, como señalar, sacudir la muñeca, encogerse de hombros, sonreír, burlarse, etc.
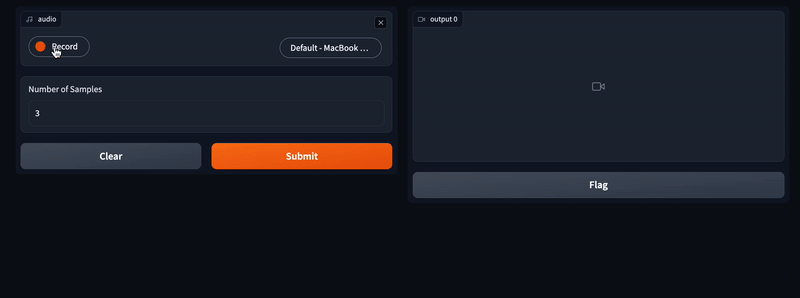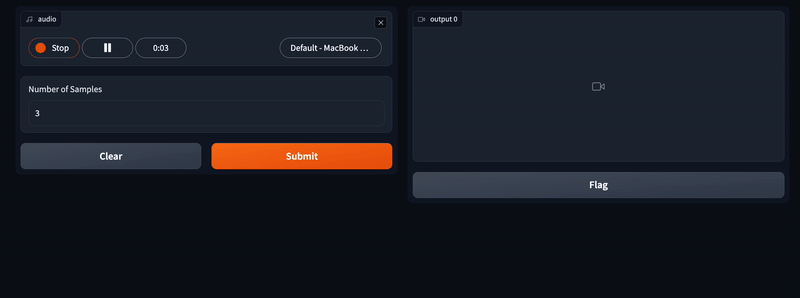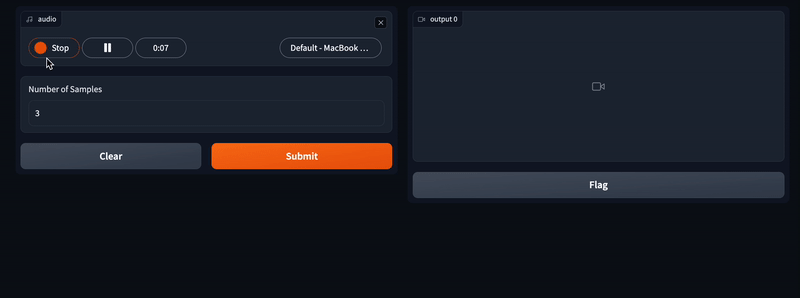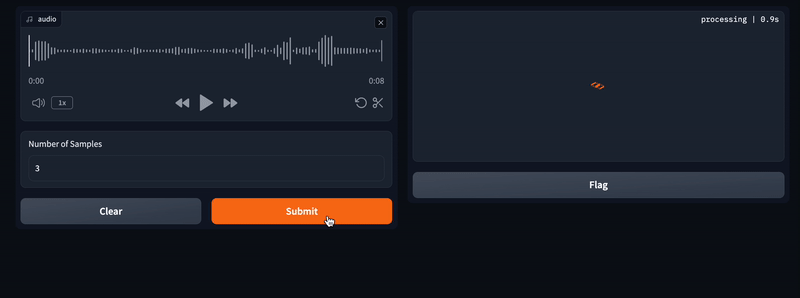
Principio de funcionamiento de Audio2PhotoReal:
Audio2PhotoReal combina las ventajas de la diversidad de muestras cuantizadas vectorialmente y los detalles de alta frecuencia obtenidos mediante difusión para generar movimientos más dinámicos y expresivos.
1. Captura de datos: en primer lugar, se captura un conjunto de datos enriquecido de conversaciones entre dos personas, que permite una reconstrucción realista.
2. Construcción del modelo de movimiento: el proyecto construye un modelo de movimiento compuesto que incluye un modelo de movimiento facial, un predictor de postura guiada y un modelo de movimiento corporal.
3. Generación de movimiento facial: se utiliza un regresor de labios pre-entrenado para procesar el audio y extraer las características relacionadas con el movimiento facial.
Se utiliza un modelo de difusión condicional para generar el movimiento facial a partir de estas características.
4. Generación de movimiento corporal: tomando el audio como entrada, se genera de forma autorregresiva una postura guiada cuantizada vectorialmente (VQ) de 1 fotograma por segundo. El audio y la postura guiada se introducen juntos en un modelo de difusión para generar movimiento corporal de alta frecuencia a 30 fotogramas por segundo.
5. Renderizado del avatar virtual: los movimientos faciales y corporales generados se introducen en un renderizador de avatar virtual entrenado para generar avatares virtuales realistas.
6. Presentación de resultados: el resultado final muestra avatares virtuales de cuerpo entero y extremadamente realistas generados a partir del audio, capaces de expresar sutiles expresiones y gestos de la conversación.
Dirección del proyecto Audio2Photoreal:https://github.com/facebookresearch/audio2photoreal/
Dirección del artículo de Audio2Photoreal:https://arxiv.org/pdf/2401.01885.pdf














