
 Asistente de guiones▸
 Apps AI
 Noticias AI
AnyDoor_云技派,专注ai人工智能!
AnyDoor_云技派,专注ai人工智能!Introducción
AnyDoor, desarrollado conjuntamente por la Universidad de Hong Kong, Alibaba y Ant Group, AnyDoor permite transportar cualquier objeto de una foto al mundo de otra imagen.
Dirección del proyecto AnyDoor:https://damo-vilab.github.io/AnyDoor-Page/
Dirección de la demo en línea de AnyDoor:https://huggingface.co/spaces/xichenhku/AnyDoor-online
Funciones de AnyDoor:
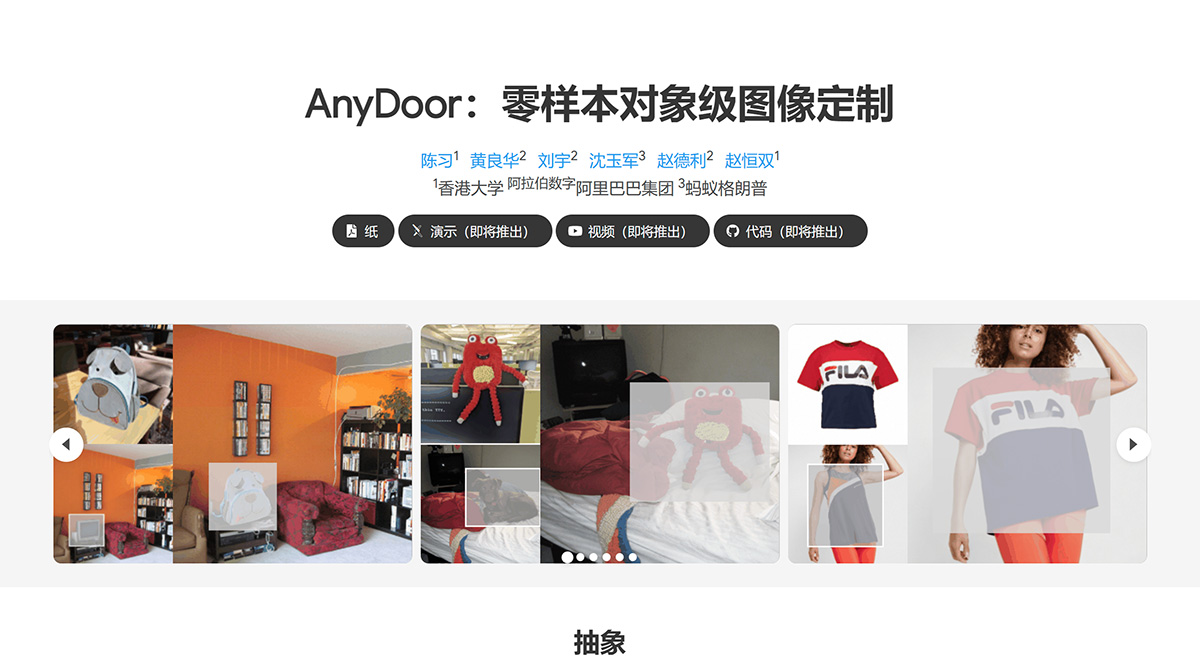
Movimiento de objetos: AnyDoor puede aplicarse a tareas sofisticadas como el movimiento de objetos.
Intercambio de objetos: AnyDoor también puede ampliarse para realizar intercambios de objetos.
Prueba virtual de maquillaje: AnyDoor también puede servir como una base sencilla pero potente para pruebas virtuales de maquillaje. Es capaz de conservar el color, los patrones y la textura de diferentes prendas sin necesidad de análisis manuales complejos.
Composición de múltiples sujetos: Dado que AnyDoor ofrece un alto nivel de control, permite colocar objetos en ubicaciones específicas de una escena determinada, lo que facilita su extensión a composiciones con múltiples temas.
Escenarios de uso de AnyDoor:
En aplicaciones de prueba virtual, los usuarios pueden personalizar rápidamente la prenda seleccionada en su propia foto.
En aplicaciones de movimiento de objetos, los usuarios pueden mover el objeto deseado desde una foto hasta una ubicación específica en otra foto.
En el ámbito del diseño, los usuarios pueden personalizar los muebles o accesorios que hayan diseñado en distintos escenarios de interior para obtener una vista previa más intuitiva del resultado.
AnyDoor es un generador de imágenes basado en difusión, capaz de transportar el objeto objetivo a una nueva escena en la ubicación indicada por el usuario de forma armoniosa. En lugar de ajustar parámetros para cada objeto, nuestro modelo se entrena una sola vez y, en la fase de inferencia, generaliza sin esfuerzo a diferentes combinaciones objeto-escena. Un escenario zero-shot tan desafiante requiere una representación suficiente del objeto específico.
Para ello, complementamos las habituales características de identidad con características de detalle, cuidadosamente diseñadas para mantener los detalles de textura y, al mismo tiempo, permitir diversas variaciones locales (por ejemplo, iluminación, orientación, postura, etc.), favoreciendo una integración armoniosa del objeto en distintos entornos. Proponemos además aprovechar el conocimiento de conjuntos de datos de vídeo, donde podemos observar las diversas formas de un mismo objeto (es decir, a lo largo del eje temporal), logrando así una mayor generalización y robustez del modelo.
Numerosos experimentos demuestran que nuestro método supera a las alternativas existentes y que posee un enorme potencial en aplicaciones prácticas, como la prueba virtual de maquillaje y el movimiento de objetos.














