
 Asistente de guiones▸
 Apps AI
 Noticias AI
DreaMoving: framework de generación de vídeo humano basado en difusión
DreaMoving: framework de generación de vídeo humano basado en difusiónIntroducción
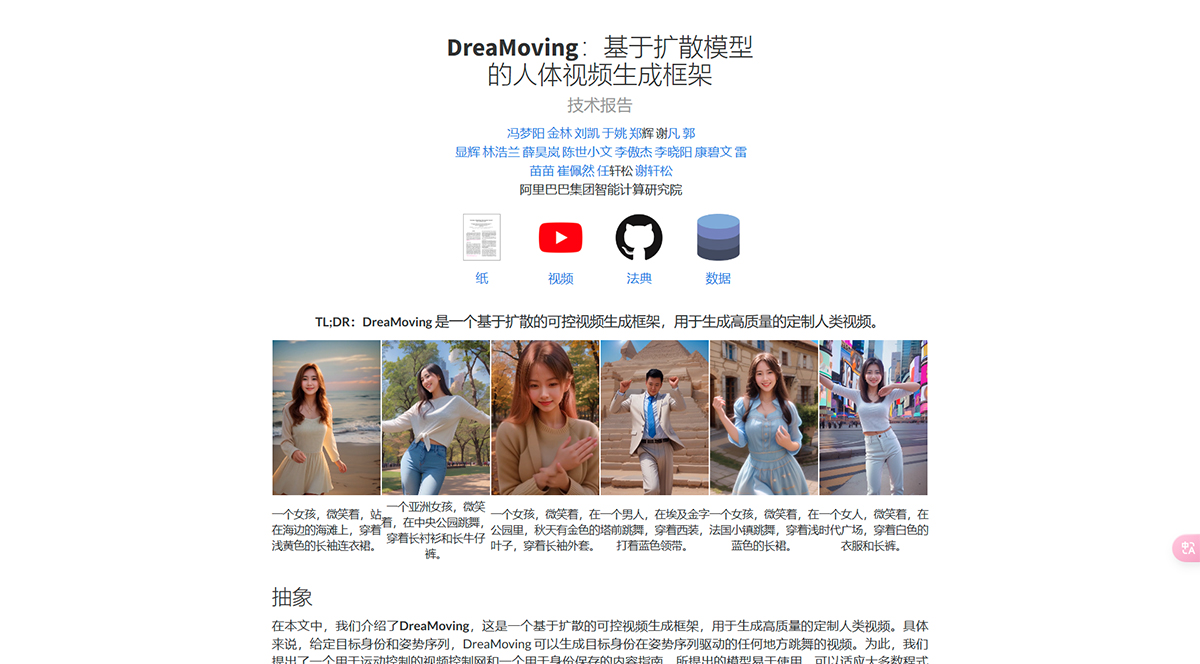
DreaMoving, un marco de generación de vídeo controlable basado en difusión, se utiliza para generar vídeos de danza humana personalizados y de alta calidad. En concreto, dada una identidad objetivo y una secuencia de poses, DreaMoving puede generar vídeos en los que la identidad objetivo baila en cualquier lugar guiada por la secuencia de poses. Para ello, proponemos una red de control de vídeo para el control del movimiento y una guía de contenido para preservar la identidad. El modelo propuesto es fácil de usar y puede adaptarse a la mayoría de los modelos de difusión estilizados para generar resultados diferentes.
Dirección del proyecto DreaMoving:https://dreamoving.github.io/dreamoving
Descripción general de DreaMoving:
Video ControlNet es un ControlNet de imagen que inyecta bloques de movimiento después de cada bloque U-Net. Video ControlNet procesa las secuencias de control (pose o profundidad) como residuos temporales adicionales. El Denoising U-Net es un U-Net Stable-Diffusion derivado, con bloques de movimiento para la generación de vídeo. El Content Guider transmite la indicación de texto de entrada y la expresión de apariencia (como la cara, la ropa es opcional) a incrustaciones de contenido para la atención cruzada.
Resultados:
DreaMoving puede generar vídeos de alta calidad y alta fidelidad, dada una secuencia de guía y una descripción sencilla del contenido, como texto e imágenes de referencia, como entrada. En concreto, DreaMoving demuestra su dominio del control de identidad mediante imágenes de referencia de rostros, una manipulación precisa del movimiento mediante secuencias de poses y un control completo de la apariencia del vídeo indicado por la indicación de texto especificada.














