
 Asistente de guiones▸
 Apps AI
 Noticias AI

PixWeaver_云技派,专注ai人工智能!
PixWeaver_云技派,专注ai人工智能!Introducción
PixWeaver es una plataforma de creación de imágenes basada en inteligencia artificial. Puede ayudar a los usuarios a generar las imágenes deseadas mediante descripciones de voz o texto, sin necesidad de aprender complejos programas de diseño.
Los usuarios solo necesitan introducir unas pocas frases descriptivas, y el potente modelo de IA de PixWeaver puede generar automáticamente imágenes de alta calidad. Los usuarios pueden dar rienda suelta a su creatividad ilimitada y lograr la liberación total en la creación de imágenes.
PixWeaver hace que la creación sea sencilla y divertida,con una barrera de entrada muy baja; los usuarios solo tienen que iniciar sesión para empezar a usarlo. El método de uso es el siguiente:
1. En la página de creación, los usuarios pueden hacer clic en "Crear" o en la opción "Pintura con IA" de la barra de menú.
2. Introduzca la descripción de la imagen que desea en el campo de descripción de la imagen, o también puede seleccionar "Descripción aleatoria" para generarla.
3. En el campo "Elementos no deseados", los usuarios pueden introducir el contenido que no quieren que aparezca en la imagen.
4. Haga clic en Generar.
PixWeaver tiene una velocidad de generación muy rápida; de media, generar cada imagen solo lleva 3 segundos, por lo que los usuarios no tienen que esperar. PixWeaver también ofrece funciones de postprocesado como el tratamiento y la retoque de imágenes.
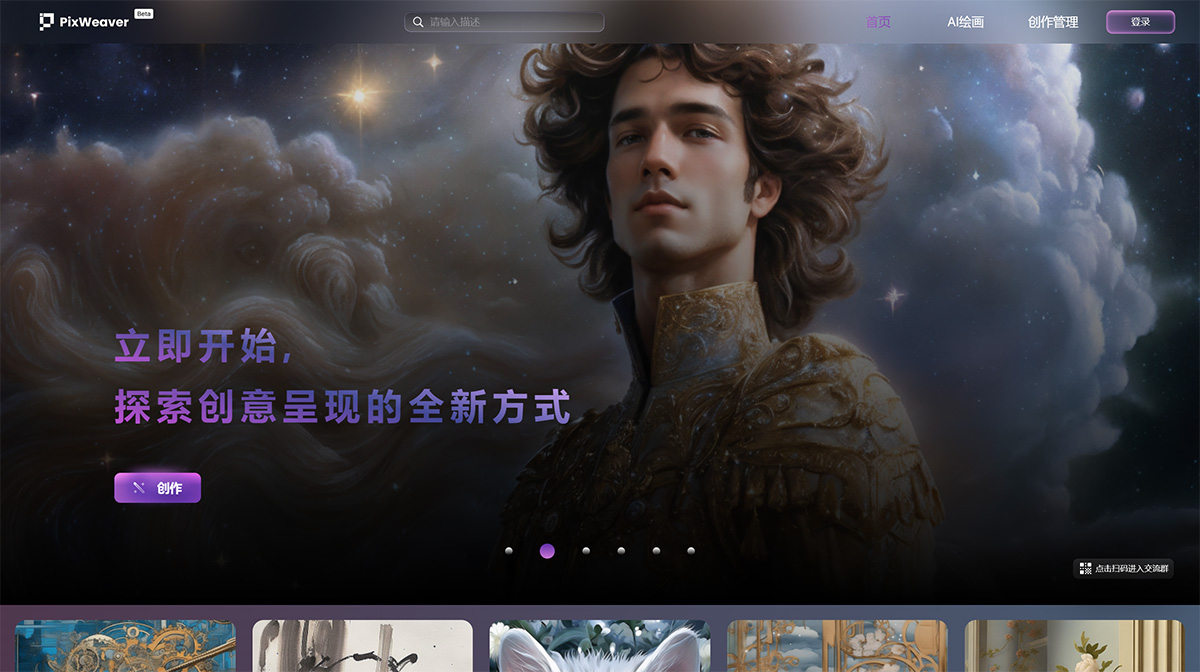
Funciones del producto PixWeaver:
Generación de imágenes a partir de descripciones de voz o texto
Proporciona potentes modelos de creación con IA
Funciones de tratamiento y retoque de imágenes
Función de gestión de la creación
PixWeaver, de Shengshu Technology, es una plataforma de diseño creativo visual personalizado que ofrece generación de imágenes a partir de texto de alta calidad, estilos diversificados, nivel artístico, expansión creativa y creación eficiente. Shengshu Technology es un desarrollador de modelos multimodales de gran tamaño a nivel industrial, centrado en el desarrollo de modelos multimodales generativos de gran escala y productos de aplicación. Ha publicado como código abierto el modelo de difusión multimodal basado en Transformer Unidiffuser, que utiliza la arquitectura Transformer U-ViT para implementar por primera vez la multimodalidad en un Diffusion Model (modelo de difusión), logrando tareas de generación de alta calidad como texto a imagen, imagen a texto, generación conjunta de imagen y texto, y reescritura de imagen y texto, basándose en un único modelo subyacente.















