
 Asistente de guiones▸
 Apps AI
 Noticias AI
¡DeepSeek-V4 llega con todo! 1M de contexto y soporte para Huawei Ascend
小编 ·

¡DeepSeek-V4 llega con todo! 1M de contexto y soporte para Huawei Ascend
DeepSeek-V4 se lanzó oficialmente el 24 de abril de 2026 y simultáneamente se publicó como código abierto una familia de modelos de lenguaje a gran escala, que incluye dos versiones: DeepSeek-V4-Pro y DeepSeek-V4-Flash. La serie destaca por ofrecer de forma estándar un contexto ultralargo de un millón de tokens (1M), alcanzando un nivel líder en el ámbito nacional y de código abierto en capacidades de Agent, conocimiento del mundo y rendimiento de razonamiento. El modelo ya está profundamente adaptado a los chips Huawei Ascend.
🚀 Aspectos destacados principales
Contexto de un millón de tokens como estándar: ambas versiones soportan un contexto ultralargo de 1 millón de tokens, y el servicio oficial lo ofrece como configuración estándar. Esto es posible gracias a un nuevo mecanismo de atención (atención híbrida CSA + HCA), que reduce los requisitos de cómputo y memoria.
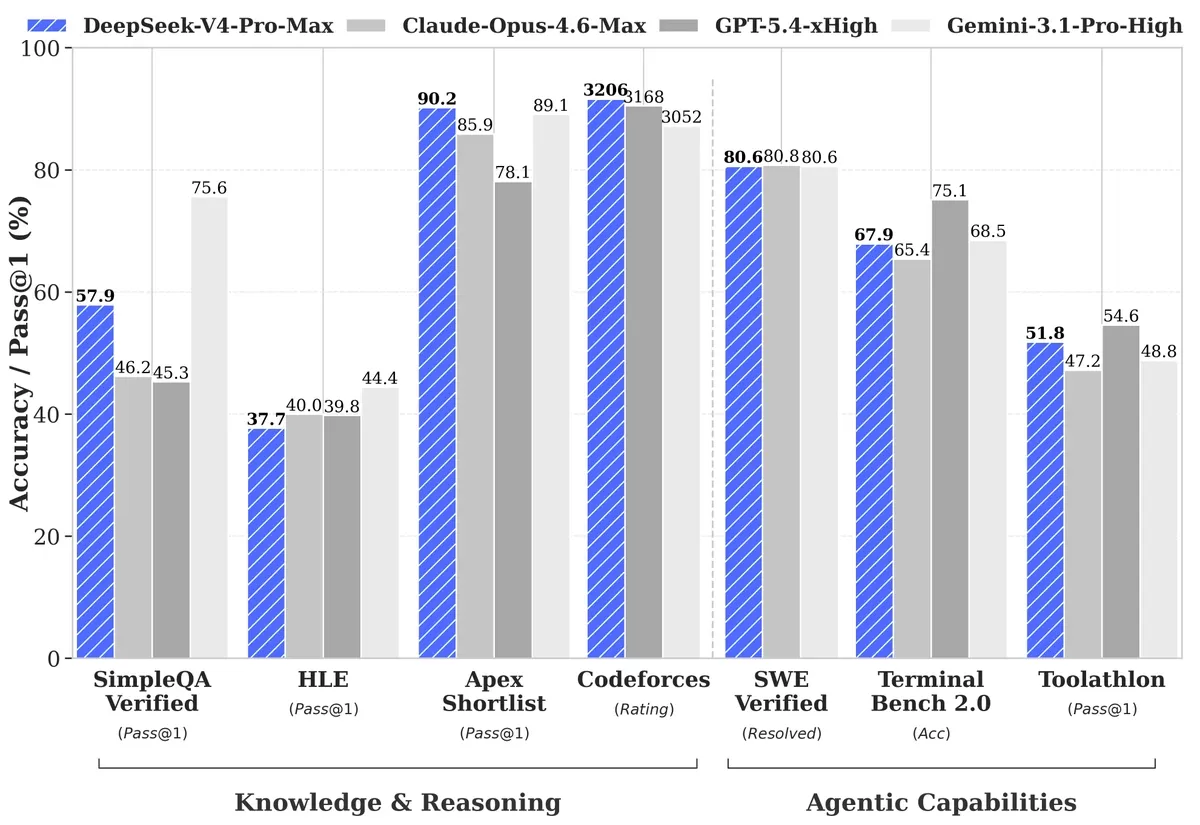
Rendimiento destacado en razonamiento y conocimiento: DeepSeek-V4-Pro supera en matemáticas, STEM y código de competición a todos los modelos de código abierto evaluados públicamente, con un rendimiento cercano al de los modelos cerrados de primer nivel mundial. Su base de conocimiento del mundo también supera claramente a la de otros modelos de código abierto.
Capacidad de Agent mejorada: la capacidad de Agent de V4-Pro alcanza el mejor nivel entre los modelos de código abierto en las evaluaciones de Agentic Coding, con una experiencia de uso superior a la de Sonnet 4.5 y una calidad de entrega cercana al modo sin pensamiento de Opus 4.6. El modelo también se ha optimizado específicamente para productos Agent populares como Claude Code y OpenClaw.
Adaptación al hardware nacional: DeepSeek-V4 se ejecutará en los últimos chips Huawei Ascend; los ingenieros han completado la migración底层 desde NVIDIA CUDA a la arquitectura Huawei CANN. Cambricon también ha completado la adaptación a la serie V4.
🤔 ¿Cómo elegir entre las dos versiones?
La serie DeepSeek-V4 ofrece dos versiones, adaptadas a distintos escenarios:
DeepSeek-V4-Pro - Modo experto
Posicionamiento:,追求极致性能,对标顶级闭源模型。
Características: base de conocimiento del mundo más amplia, mayor capacidad de razonamiento, ideal para razonamiento complejo, generación de código y tareas de Agent.
Parámetros: total de parámetros 1,6T, parámetros activados 49B.
DeepSeek-V4-Flash - Modo rápido
Posicionamiento: 更快捷、更经济的选择
Características: capacidad de razonamiento cercana a la versión Pro, menor cantidad de parámetros y de activación, precio de API más bajo y respuesta más rápida. En tareas de Agent simples, su rendimiento es comparable al de Pro.
Parámetros: total de parámetros 284B, parámetros activados 13B.
💻 ¿Cómo obtenerlo y usarlo?
Pesos de código abierto: ya disponible en código abierto en las plataformas Hugging Face y ModelScope.
Llamada a la API: el servicio de API se actualiza simultáneamente; los desarrolladores solo deben cambiar el parámetro model a deepseek-v4-pro o deepseek-v4-flash para realizar la llamada.
Uso directo: inicia sesión en el sitio web oficial de DeepSeek o en la App oficial para conversar directamente.
Precio de la API
A continuación se muestra el precio de llamada por cada millón de tokens:
| Versión del modelo | Entrada (acierto de caché)¥/MTok | Entrada (sin acierto de caché)¥/MTok | Salida¥/MTok |
|---|---|---|---|
| DeepSeek-V4-Flash | 0,2 yuanes | 1 yuan | 2 yuanes |
| DeepSeek-V4-Pro | 1 yuan | 12 yuanes | 24 yuanes |









