
 Asistente de guiones▸
 Apps AI
 Noticias AI
Qwen-Image: modelo de generación de imágenes y pósteres de código abierto de Alibaba Tongyi
小编 ·

Qwen-Image: modelo de generación de imágenes y pósteres de código abierto de Alibaba Tongyi
Qwen-Image es el modelo básico de generación de imágenes de código abierto presentado por el equipo Tongyi Qianwen de Alibaba el 5 de agosto de 2025, con 20.000 millones de parámetros y arquitectura MMDiT. Destaca en la renderización compleja de texto y la edición precisa de imágenes, siendo especialmente capaz de generar grandes cantidades de contenido chino preciso, y también admite prompts en chino, liderando en pruebas específicas para chino como LongText-Bench y ChineseWord.
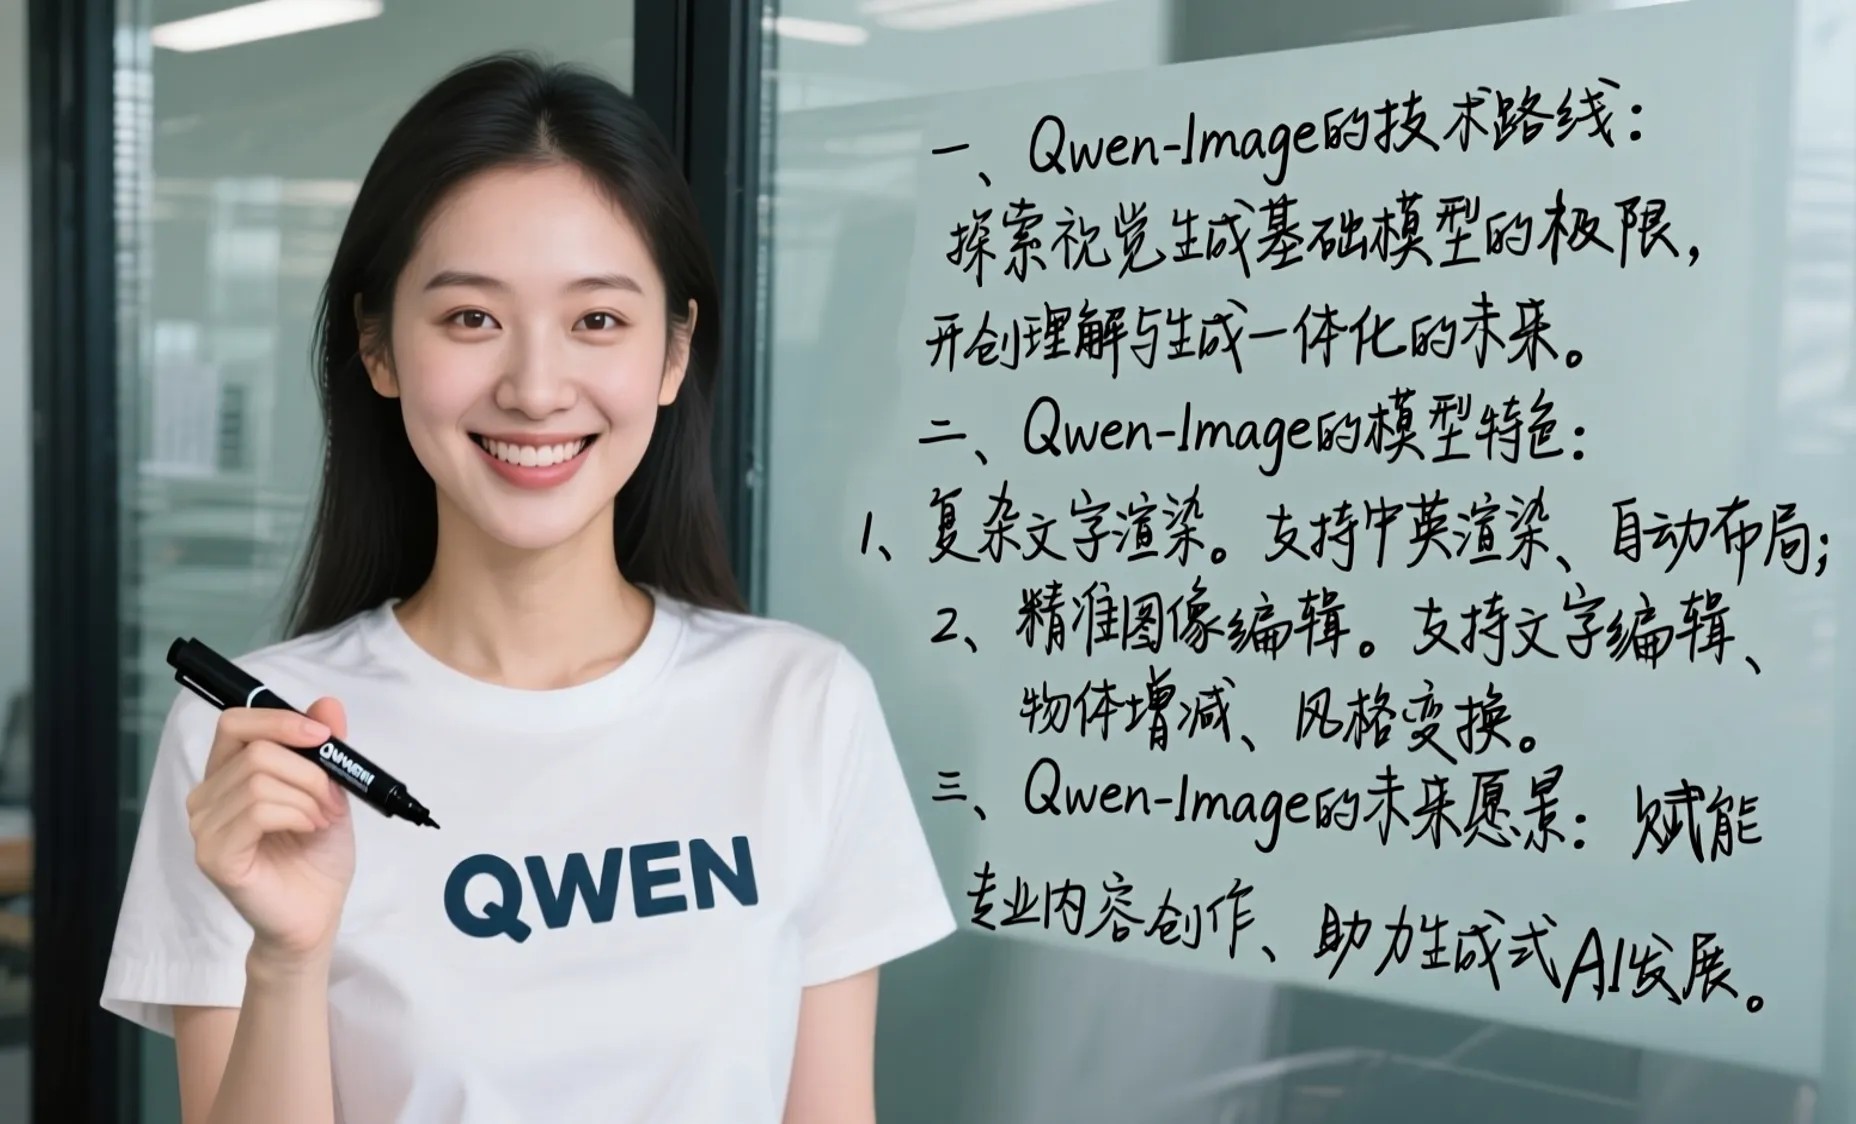
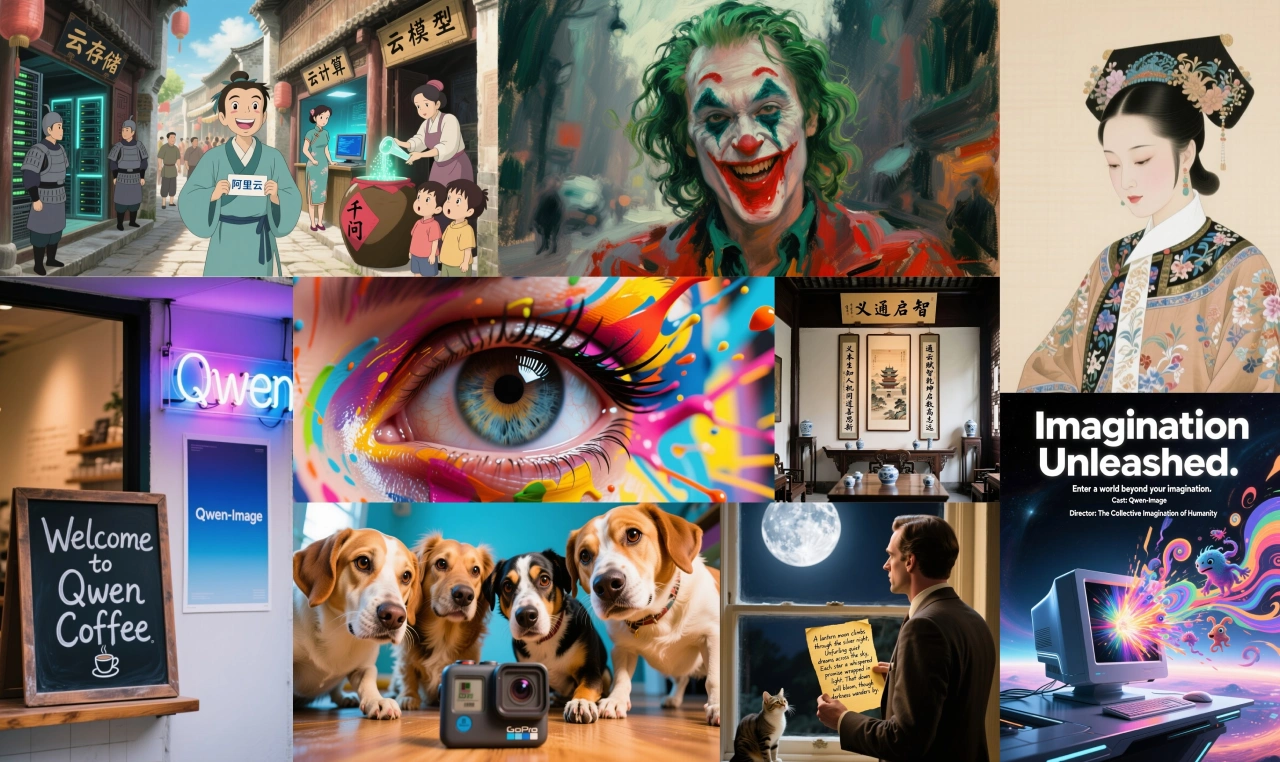
Este modelo es compatible con chino e inglés, puede manejar diferentes fuentes, párrafos muy largos y maquetaciones complejas de imagen y texto, y puede generar imágenes para diversos escenarios como carteles y ppt, además de realizar edición de imágenes como transferencia de estilo, añadir o quitar objetos y ajustar posturas. Se puede aplicar en múltiples sectores como diseño publicitario, producción audiovisual, desarrollo de videojuegos y educación y formación. Los usuarios pueden experimentar con él seleccionando la función de generación de imágenes en QwenChat (chat.qwen.ai), donde pueden generar carteles, páginas de PPT, imágenes promocionales de productos, etc., así como realizar diversas ediciones de imágenes, proporcionando una potente herramienta para los diseñadores.
Características principales
Gran capacidad de renderización de texto: admite maquetación de varias líneas, generación de texto a nivel de párrafo y presentación de detalles, con salida de alta fidelidad tanto en chino como en inglés. Tiene un buen rendimiento en pruebas como LongText-Bench, ChineseWord y TextCraft, y la renderización de texto en chino es mucho mejor que la de los modelos avanzados actuales. Puede generar texto en diferentes idiomas y estilos, escribir en caligrafía china, o generar directamente páginas de PPT con texto e imágenes.
Buena consistencia en la edición de imágenes: mediante entrenamiento multitarea reforzado, mantiene la coherencia visual y semántica durante la edición, admitiendo operaciones como transferencia de estilo, añadir/eliminar/modificar, mejora de detalles, edición de texto y ajuste de la postura de las personas.
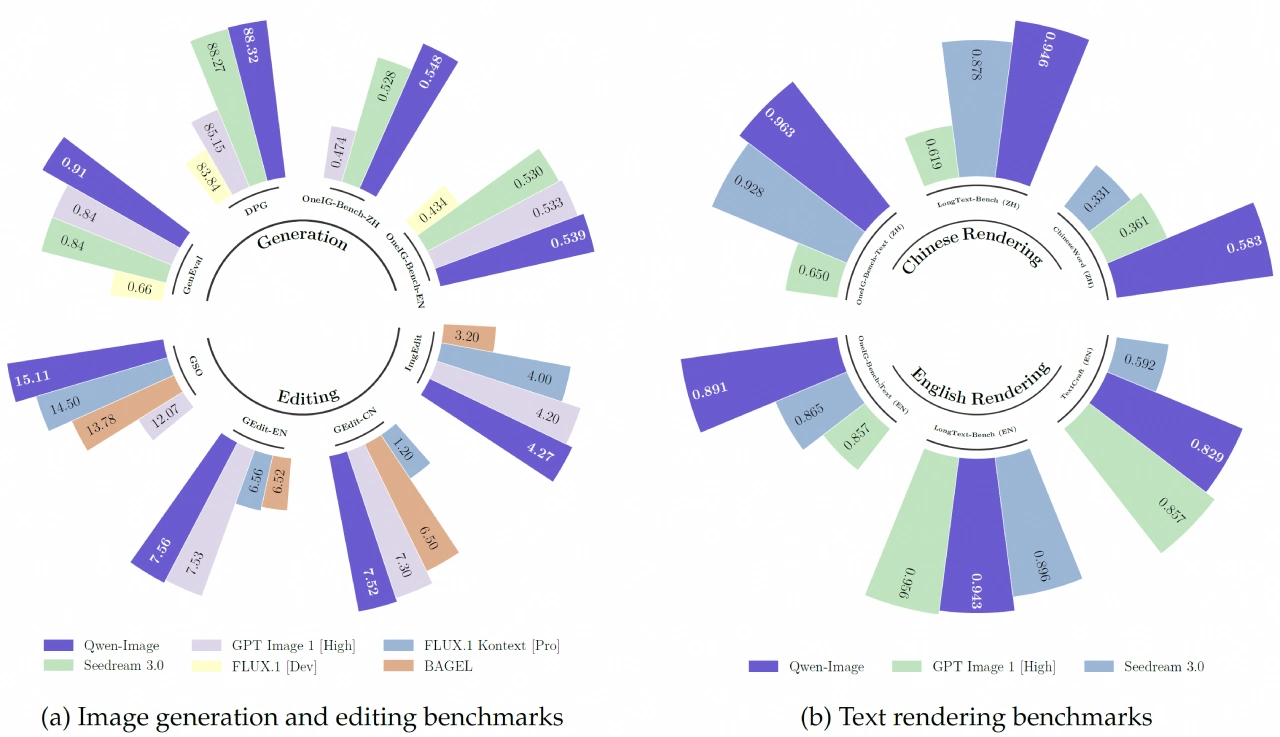
Excelente rendimiento en distintos benchmarks: alcanza un rendimiento de primer nivel en múltiples pruebas públicas como GenEval, DPG y OneIG-Bench para generación general de imágenes, y GEdit, ImgEdit y GSO para edición de imágenes.
Componentes principales
Modelo de lenguaje grande multimodal Qwen2.5-VL: actúa como codificador de condiciones, extrayendo características del texto y describiendo en detalle, según las indicaciones del sistema, el color, la cantidad, el texto, etc. de los objetos y el fondo, proporcionando una base para la generación de imágenes y haciendo que el contenido generado sea más refinado.
Autoencoder (VAE) del modelo de generación de vídeo Wan-2.1: actúa como tokenizador de imágenes, capaz de comprimir las imágenes de entrada en representaciones latentes compactas y decodificarlas de nuevo durante la inferencia. El equipo congeló el codificador y solo ajustó el decodificador para resaltar más los detalles de la imagen.
Transformer de difusión multimodal (MMDiT): como modelo principal de difusión, procesa la relación entre el ruido y las representaciones latentes de la imagen bajo la guía del texto. Incorpora el método RoPE multimodal escalable, que ayuda a distinguir la información de imagen y texto, permitiendo generar imágenes de alta resolución y texto preciso al mismo tiempo.
Arquitectura técnica de Qwen-Image
Arquitectura MMDiT: utiliza un transformador de difusión multimodal para lograr una fusión profunda de texto e imagen.
VAE con un codificador y dos decodificadores: se encarga de comprimir las imágenes en representaciones latentes compactas y decodificarlas en píxeles tras la generación. Mediante el ajuste del equilibrio entre la pérdida de reconstrucción y la pérdida perceptiva, puede还原 fielmente los detalles de la imagen.
Codificación posicional rotacional escalable multimodal (MSRoPE): codifica la información textual en la "diagonal" de la cuadrícula de la imagen, manteniendo la independencia del texto y aprovechando las ventajas del escalado de resolución de la imagen.
Estrategia de entrenamiento
Se adopta un preentrenamiento por etapas y progresivo: entrenando gradualmente desde baja resolución hasta alta resolución, desde contenido general hasta contenido especializado, y desde datos masivos hasta datos refinados.
En la fase final del entrenamiento se utiliza ajuste fino supervisado (SFT) y aprendizaje por refuerzo (RL): se ajustan con datos de alta calidad seleccionados manualmente, y se utilizan técnicas como DPO para que el modelo aprenda las preferencias humanas.
Escenarios de aplicación
Diseño publicitario: genera rápidamente imágenes de alta calidad según el estilo de la marca, admite conversión de estilo y optimización de detalles, ayudando a los diseñadores a probar rápidamente múltiples efectos para satisfacer las necesidades del cliente.
Producción audiovisual: se utiliza para conceptos previos, presets de escenas y diseño de personajes, acortando los ciclos de producción y reduciendo costes.
Visualización para comercio electrónico: los comerciantes pueden generar rápidamente imágenes展示 de productos, imágenes de prueba virtual y materiales de marketing, mejorando la experiencia del usuario y la tasa de compra.
Creación de carteles: genera carteles impactantes y artísticos (como carteles de películas y eventos) según el texto y los requisitos de diseño, adaptándose a diferentes estilos y temas.
Creación de PPT: genera páginas de PPT de nivel empresarial, utilizando una paleta principal de azul estrellado, combinada con líneas tecnológicas fluidas y efectos especiales de partículas con brillo sutil, con una apariencia profesional y moderna, admitiendo múltiples estilos y maquetaciones.
Rendimiento
Generación general de imágenes: excelente rendimiento en pruebas como GenEval, DPG y OneIG-Bench.
Edición de imágenes: rendimiento顶级 en pruebas profesionales como GEdit, ImgEdit y GSO.
Renderización de texto: capacidad destacada en pruebas como LongText-Bench, ChineseWord y TextCraft, especialmente en la renderización de texto en chino, superando con creces a los modelos顶级 actuales.
Ventajas de Qwen-Image
Mejor soporte para chino: optimización específica para chino, con un efecto de renderización mucho mejor que el de DALL-E.
Totalmente gratuito: no requiere suscripción de pago y también se puede implementar localmente.
Código abierto y transparente: código público, personalizable y modificable.
Funciones de edición más potentes: admite operaciones de edición de imágenes más diversas.
Sin restricciones de uso: sin límite de llamadas a la API.
Cómo usar Qwen-Image
Preparación del entorno: instala la última versión de diffusers.
Código básico:
from diffusers import DiffusionPipeline
import torch
model_name = "Qwen/Qwen-Image"
if torch.cuda.is_available():
    torch_dtype = torch.bfloat16
    device = "cuda"
else:
    torch_dtype = torch.float32
    device = "cpu"
pipe = DiffusionPipeline.from_pretrained(model_name, torch_dtype=torch_dtype)
pipe = pipe.to(device)
prompt = '''一个穿着"QWEN"标志T恤的中国美女正拿着黑色马克笔面向镜头微笑。她身后的玻璃板上手写体写着"欢迎使用Qwen-Image,一款强大的图像基础模型"'''
aspect_ratios = {
    "1:1": (1328, 1328),
    "16:9": (1664, 928),
    "9:16": (928, 1664),
    "4:3": (1472, 1140),
    "3:4": (1140, 1472)
}
width, height = aspect_ratios["16:9"]
image = pipe(
    prompt=prompt + "超清,4K,电影级构图",
    width=width,
    height=height,
    num_inference_steps=50,
    true_cfg_scale=4.0,
    generator=torch.Generator(device=device).manual_seed(42)
).images[0]
image.save("qwen_image_example.png")
GB de VRAM), el modo CPU también puede funcionar, aunque la velocidad de generación es más lenta.
✅Introducción oficial de Qwen-Image: https://qwenlm.github.io/zh/blog/qwen-image/
✅Modelo Qwen-Image: https://huggingface.co/Qwen/Qwen-Image
✅Uso en línea: https://chat.qwen.ai/ (selecciona generación de imágenes debajo del cuadro de entrada)









