
 Asistente de guiones▸
 Apps AI
 Noticias AI
MOSS-TTSD: modelo de síntesis de voz para diálogo bilingüe de código abierto
小编 ·

MOSS-TTSD: modelo de síntesis de voz para diálogo bilingüe de código abierto
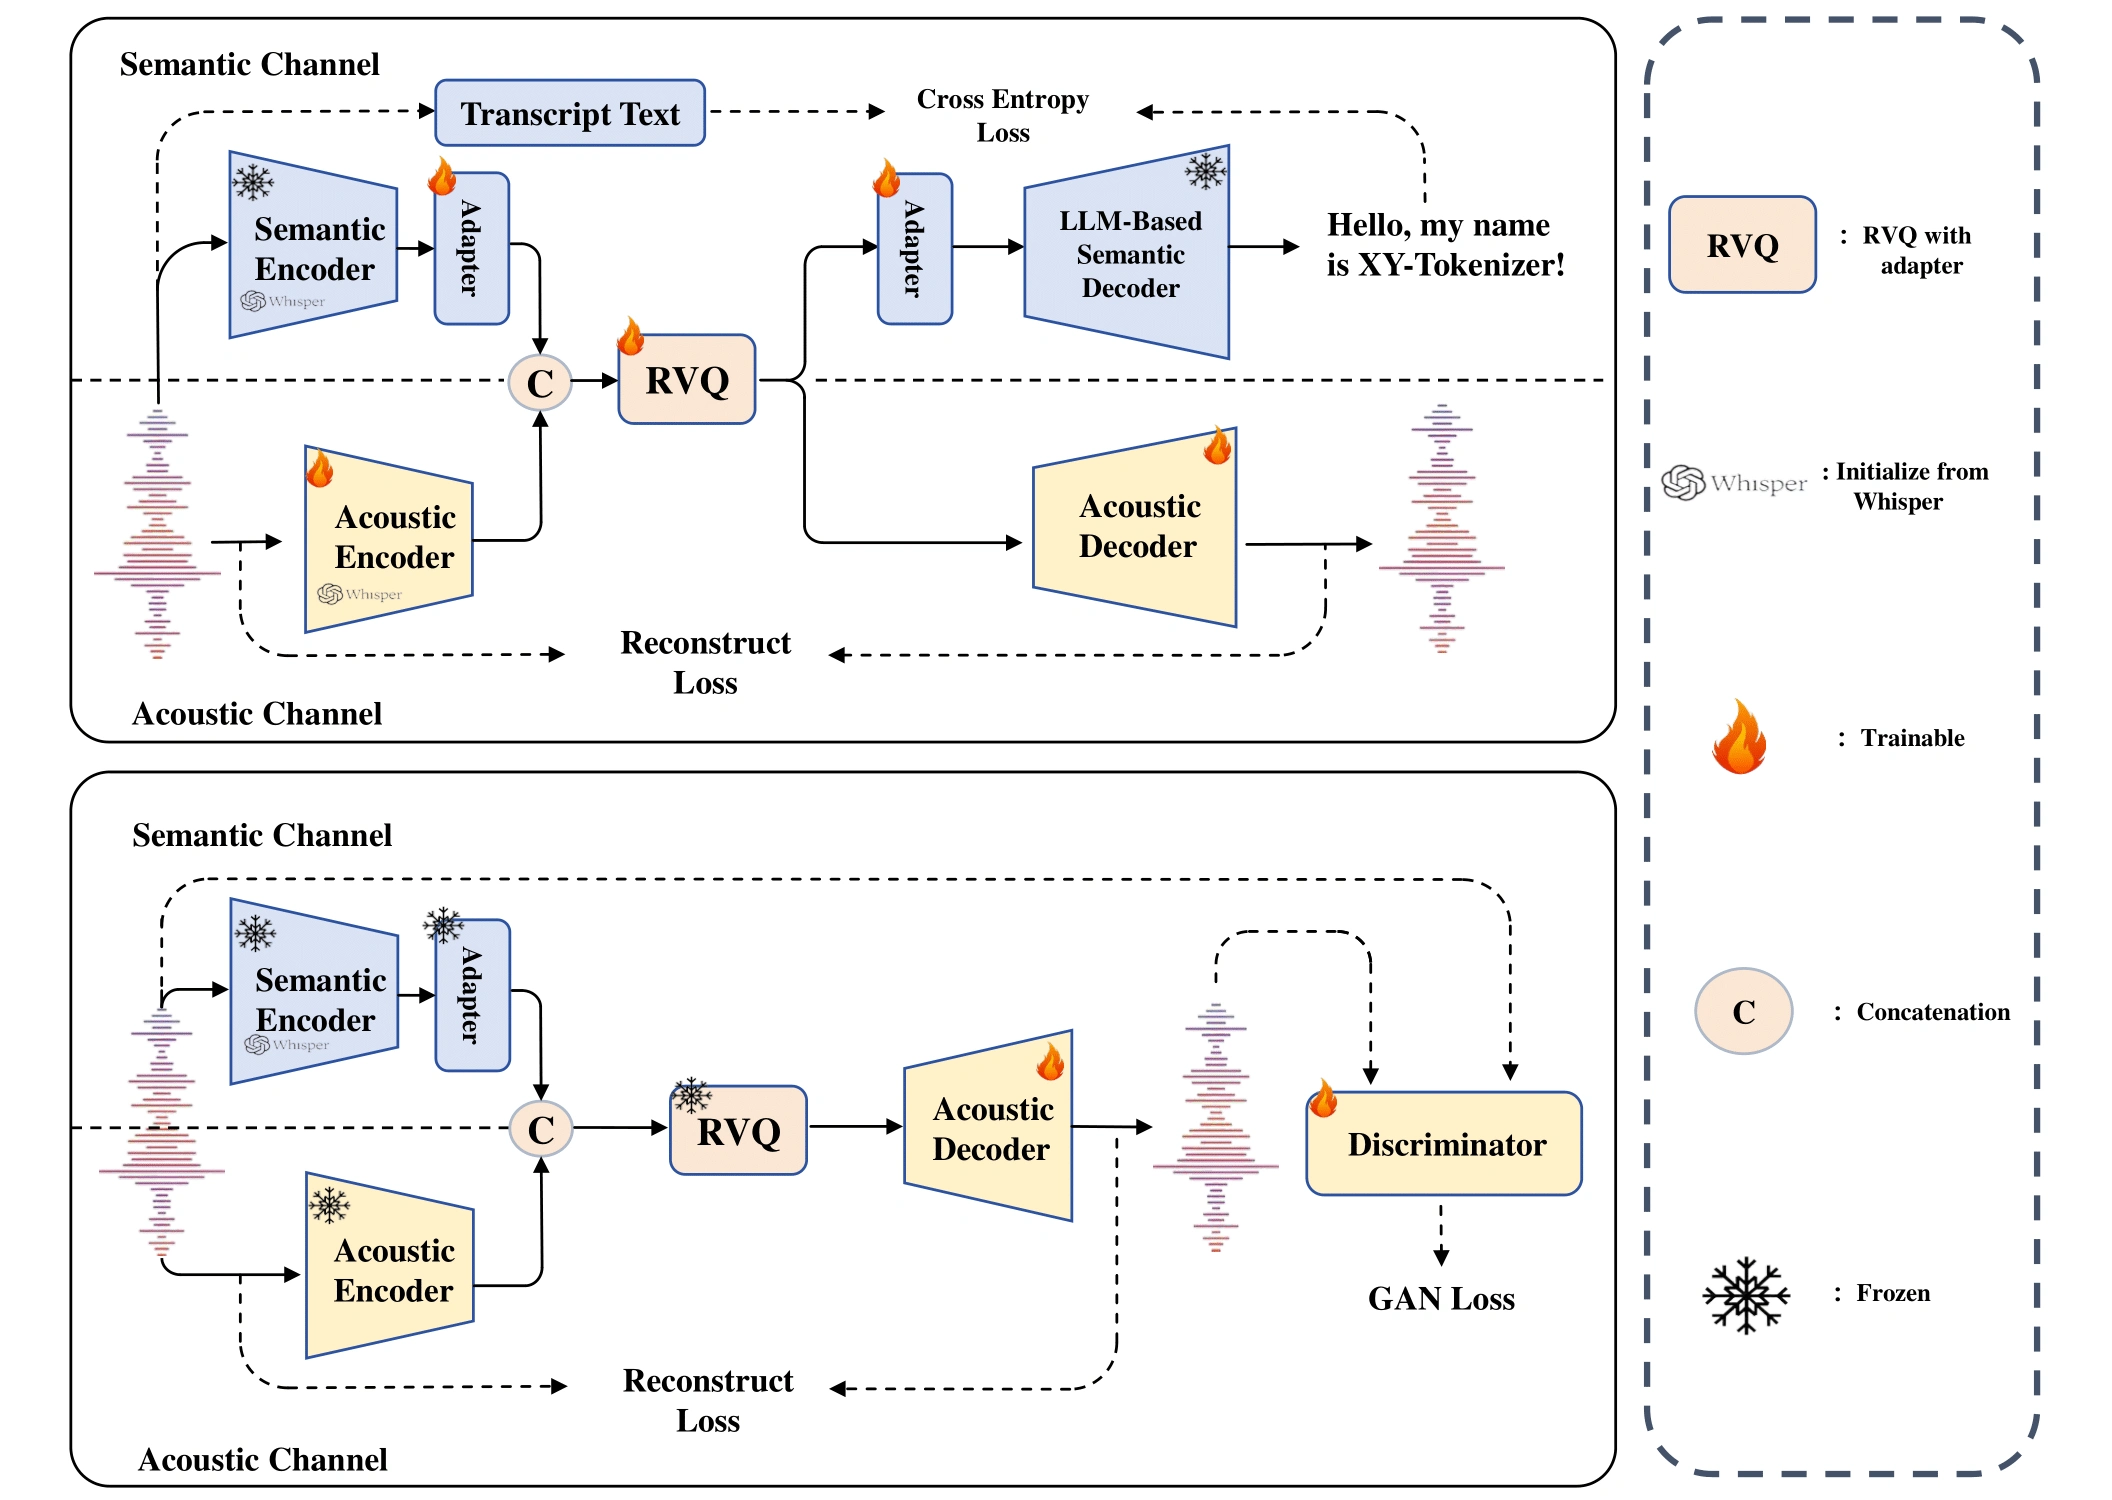
MOSS-TTSD es un modelo de código abierto de síntesis de voz para diálogos en dos idiomas, desarrollado por el Laboratorio de Voz y Lenguaje de la Universidad de Tsinghua en colaboración con Tencent ai Lab y otras instituciones. Admite chino e inglés, y puede convertir guiones de diálogo entre dos hablantes en voz conversacional natural y expresiva. El modelo se entrena a partir del modelo Qwen3-1.7B-base, utilizando modelado de secuencias de voz discretizadas. Mediante XY-Tokenizer, comprime la voz a 1 kbps conservando al mismo tiempo la información semántica y acústica.
El modelo MOSS-TTSD es compatible con chino e inglés, permite clonar la voz de varios hablantes con muestras cero (zero-shot) y puede generar audio de hasta 960 segundos de duración, por lo que resulta adecuado para escenarios como podcasts con IA, locuciones para cine y televisión, o entrevistas largas. Los pesos del modelo, el código de inferencia y la interfaz API son de código abierto y admiten uso comercial gratuito.
Características principales
✅ Voz conversacional altamente expresiva: construido sobre un códec de audio neuronal unificado semántico-acústico, un modelo de lenguaje grande preentrenado, millones de horas de datos TTS y 400 000 horas de voz conversacional sintética y real. Es capaz de generar voz conversacional similar a la humana, con una prosodia natural y gran expresividad.
✅ Clonación de voz de dos hablantes: admite la clonación de voz zero-shot para dos hablantes, y puede cambiar de interlocutor con precisión según el guion del diálogo para generar voz conversacional.
✅ Compatibilidad bilingüe chino-inglés: puede generar voz altamente expresiva tanto en chino como en inglés.
✅ Generación de voz larga: optimizado mediante un códec de baja tasa de bits y mejoras en el marco de entrenamiento, está especialmente entrenado para la generación de audios largos.
✅ Totalmente de código abierto y apto para uso comercial: MOSS-TTSD y sus futuras actualizaciones son completamente de código abierto y admiten uso comercial sin coste.
Principio técnico de MOSS-TTSD
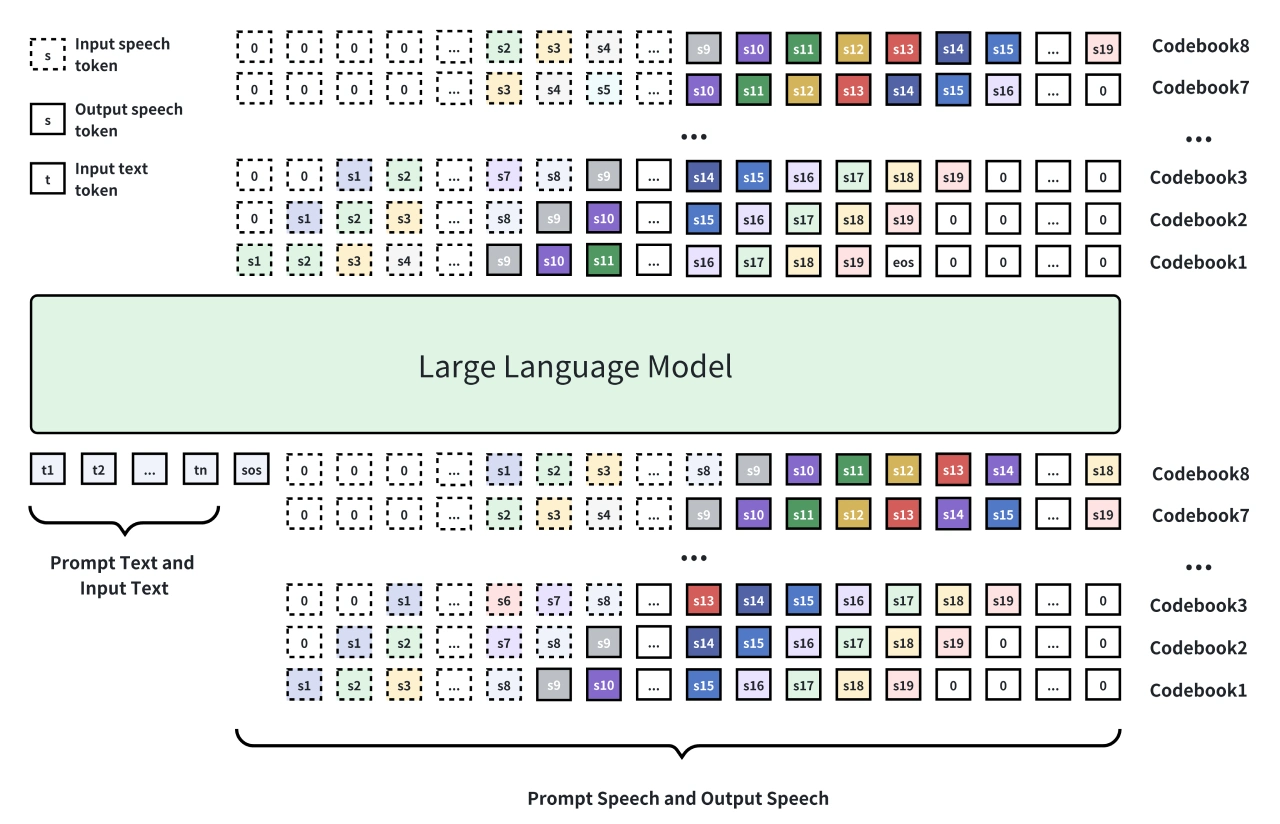
✅ Arquitectura del modelo: ajustado a partir del modelo Qwen3-1.7B-base, adopta modelado de voz discretizada. Mediante RVQ ( cuantificación vectorial residual ) de 8 niveles, la señal de voz se convierte en una secuencia discreta de tokens, que se genera de forma autorregresiva combinándola con un Delay Pattern, y finalmente un decodificador la reconstruye en voz.
✅ Innovación principal: XY-Tokenizer cuenta con un flujo de aprendizaje multitarea en dos fases. En la primera fase se entrenan simultáneamente tareas de reconocimiento automático del habla (ASR) y reconstrucción de voz, fusionando información semántica y acústica de grano grueso; en la segunda fase se congelan el codificador y el cuantificador, y solo se entrena el decodificador, añadiendo pérdidas de reconstrucción y pérdidas GAN para mejorar el detalle de la representación.
✅ Volumen de datos y preentrenamiento: entrenado con aproximadamente 1 millón de horas de datos de voz de un solo hablante y 400 000 horas de datos de voz conversacional. Los datos se someten a un filtrado y etiquetado estrictos, y también se realiza un preentrenamiento TTS en chino e inglés.
Escenarios de aplicación
✅ Producción de podcasts con IA: MOSS-TTSD puede convertir automáticamente texto en audio de podcasts con varios interlocutores, admite clonación de voz zero-shot y generación de voz larga, lo que reduce los costes de producción.
✅ Locución para cine, televisión y animación: genera voz conversacional natural para películas, televisión y animación, admite el cambio entre varios idiomas y mejora la eficiencia de la locución.
✅ Entrevistas largas y actas de reuniones: convierte el texto de entrevistas o reuniones en voz, conservando la prosodia y la emoción del diálogo, lo que facilita su archivo y compartición.
Ventajas y características
✅ Código abierto y apto para uso comercial: los pesos del modelo MOSS-TTSD, el código de inferencia y la interfaz API son de código abierto, y los usuarios pueden emplearlos con fines comerciales sin coste alguno.
✅ Naturalidad y expresividad: alcanza niveles líderes del sector en naturalidad y expresividad de la voz.
✅ Admite control de eventos sonoros: por ejemplo, sonidos no verbales como risas, lo que hace que la voz sea más expresiva.
Dirección del proyecto de código abierto:https://github.com/OpenMOSS/MOSS-TTSD
Sitio web oficial de MOSS-TTSD:https://www.open-moss.com/cn/









