
 Asistente de guiones▸
 Apps AI
 Noticias AI
ThinkSound: herramienta de audio con IA multimodal del laboratorio Tongyi de Alibaba
小编 ·

ThinkSound: herramienta de audio con IA multimodal del laboratorio Tongyi de Alibaba
ThinkSound es una herramienta de audio de IA multimodal desarrollada por el laboratorio Tongyi de Alibaba, capaz de generar efectos de sonido de alta fidelidad y audio ambiental a partir de entradas de vídeo, texto o audio.
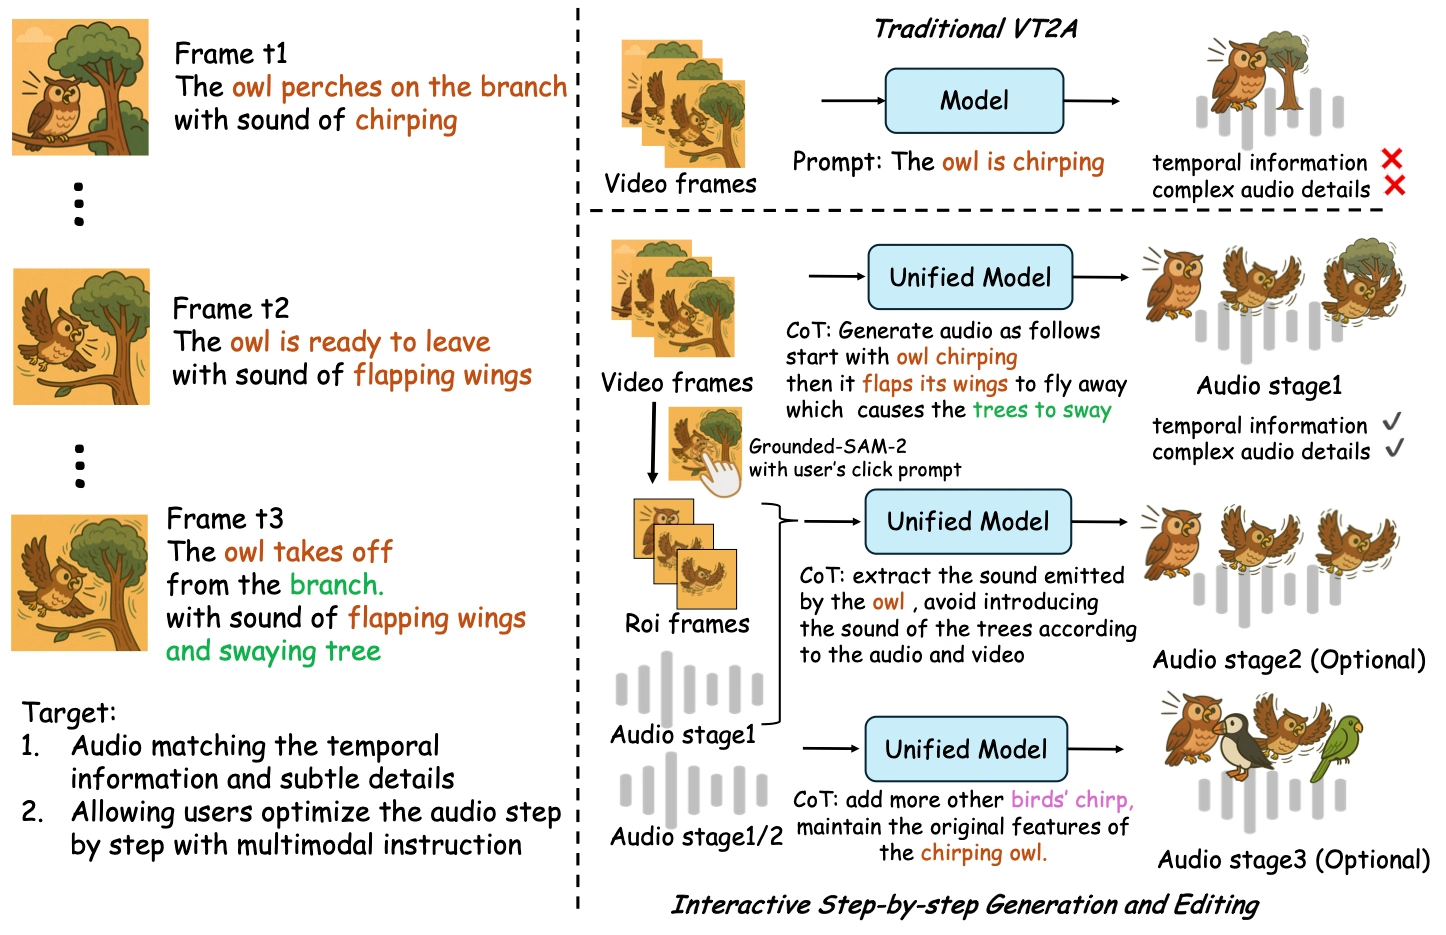
Funciones principales
✅ Vídeo a audio: convierte cualquier vídeo en efectos de sonido enriquecidos que se ajustan a las imágenes. Mediante el análisis fotograma a fotograma de los elementos visuales, las trayectorias de movimiento y el contexto ambiental, genera sonidos de fondo y efectos espaciales sincronizados con el entorno.
✅ Síntesis de voz inteligente: genera diálogos y narraciones naturales basados en el contenido del vídeo. La IA es capaz de reconocer expresiones faciales, movimientos labiales y el contexto emocional, produciendo una voz con sincronización labial precisa, entonación natural y emocionalmente auténtica.
✅ Diseño de efectos de sonido multimodal: combina vídeo, instrucciones de texto, efectos de sonido de referencia y preferencias de estilo para ajustar con precisión los detalles del sonido, garantizando una integración natural con la imagen, ideal para producciones profesionales como cine y videojuegos.
✅ Edición de audio interactiva: los usuarios pueden hacer clic en los objetos dentro del vídeo o introducir instrucciones directamente en lenguaje natural para refinar sonidos específicos.
Principio técnico
Marco interactivo en tres fases:
✅ Generación básica de efectos de sonido: el sistema analiza primero el vídeo en su totalidad y, mediante razonamiento lógico, identifica los eventos sonoros, los elementos ambientales, las características acústicas y sus relaciones temporales, generando una escena de sonido ambiente inicial y coherente.
✅ Optimización por objeto: tras hacer clic en el objeto objetivo, el sistema utiliza técnicas de localización para extraer la región y rastrear el movimiento del objeto, generando de forma específica la lógica de sonido de dicho objeto, optimizando los detalles del audio y manteniendo al mismo tiempo la coherencia con la pista de sonido global.
✅ Edición por instrucciones: el usuario introduce instrucciones en lenguaje natural (por ejemplo, "añadir cantos de pájaros" o "eliminar el ruido del coche"), y el sistema las traduce en operaciones de audio precisas, ajustándolas según la imagen y el estado actual del sonido.
✅ Modelo multimodal de gran tamaño (MLLM): su capacidad principal es comprender de forma sincronizada la imagen del vídeo, las descripciones textuales y el contexto sonoro, fusionando la información para generar de manera progresiva efectos de sonido naturales y realistas.
Ventajas destacadas
✅ Alta autenticidad de los efectos de sonido, con un rendimiento destacado en pruebas de generación vídeo-audio y una gran adaptabilidad a la escena.
✅ Soporta la personalización de efectos creativos mediante instrucciones detalladas, garantizando al mismo tiempo una sincronización natural entre audio e imagen.
✅ Compatible con los principales formatos de vídeo (MP4/MOV/AVI/MKV) y adaptable desde definición estándar hasta resolución 4K, con compatibilidad para múltiples tasas de fotogramas.
✅ Diseñada para escenarios profesionales (cine, publicidad, videojuegos, etc.), todas las versiones incluyen licencia de uso comercial.
Escenarios de aplicación
✅ Postproducción audiovisual: genera rápidamente sonido ambiental, diálogos o bandas sonoras para material sin audio, mejorando la eficiencia de producción.
✅ Efectos de sonido para videojuegos: crea sonido ambiental dinámico que aumenta la inmersión en escenas virtuales.
✅ Medios interactivos y educación: implementa diálogos multilingües mediante síntesis de voz, combinando sincronización labial precisa y expresión emocional para hacer que los personajes virtuales resulten más vívidos.
Enlaces del proyecto
✅ Github: https://github.com/FunAudioLLM/ThinkSound
✅ Página web oficial: https://thinksound-demo.github.io/
✅ HuggingFace: https://huggingface.co/spaces/FunAudioLLM/ThinkSound









